


প্রকাশিত: ১২ নভেম্বর, ২০২৬
এই সপ্তাহে আমরা মডার্ন ওয়েব নির্দেশিকা ১.০ লঞ্চ করেছি, এটি একটি ওপেন-সোর্স দক্ষতা যা কোডিং এজেন্টদের লিগ্যাসি ওয়ার্কঅ্যারাউন্ডের পরিবর্তে আধুনিক ওয়েব প্ল্যাটফর্ম ফিচার ব্যবহার করতে সাহায্য করে। এই পোস্টে লোকাল সার্চ ইঞ্জিন সম্পর্কে আলোচনা করা হয়েছে যা আপনার টোকেন নষ্ট না করেই আপনার টাস্কের জন্য সবচেয়ে প্রাসঙ্গিক গাইড খুঁজে দেয়।
আপনি যদি কোনও ইঞ্জিনিয়ারকে বলেন যে আপনি তার কোডিং এজেন্টের জন্য ১.৭ এমবি Markdown টেক্সট সহ একটি নলেজ বেস তৈরি করেছেন, তাহলে তিনি দুটি প্রশ্ন করবেন:
- "এটি আমার কন্টেক্সট উইন্ডোতে কতগুলি টোকেন ডাম্প করবে?"
- "এটির জন্য কী ধরনের ব্লটেড ভেক্টর ডেটাবেস প্রয়োজন?"
গত ছয় মাসে, আমরা আমাদের লোকাল রিট্রিভাল ইঞ্জিন তিনবার নতুন করে তৈরি করেছি। আমরা ৫০৭ এমবি C++ বাইন্ডিং থেকে শুরু করে TensorFlow.js ব্যবহার করে ২৩ এমবি পিওর JavaScript-এ নেমে আসি এবং তারপর ৭ এমবি প্যাকেজে নেমে আসি যেখানে কোয়েরি এম্বেডিং হল একটি ৭-লাইনের for লুপ, এই সব কিছুই অ্যাকুরেসি উন্নত করার সময় করা হয়।
এজেন্টিক RAG এবং প্রোগ্রেসিভ ডিসক্লোজার
AGENTS.md-এ ২০০টির বেশি HTML/CSS/Web API গাইড সহ ১.৭ এমবি মার্কডাউন টেক্সট ডাম্প করা বাস্তবসম্মত নয়। আমরা প্রোগ্রেসিভ ডিসক্লোজার-এ বিশ্বাস করি, তবে জানি যে মার্কডাউন ইন্ডেক্স স্কেলে টোকেন-এফিশিয়েন্ট হওয়া বন্ধ করে দেবে।
এই সমস্যার সমাধান করতে, আমরা সার্চ CLI দ্বারা সমর্থিত এজেন্টিক RAG ব্যবহার করি:
- অ্যাক্টিভ না থাকলে, এজেন্ট শুধু স্কিলের বিবরণ দেখতে পায় (~২০৫ টোকেন)। বিবরণটি Anthropic-এর স্কিল ট্রিগার নির্দেশিকা অনুসরণ করে যাতে এজেন্ট প্রাসঙ্গিক ফ্রন্টএন্ড টাস্কে স্কিলটি চালু করে।
- ফ্রন্টএন্ড টাস্কে, এজেন্ট CLI ব্যবহার করে সার্চ করতে পারে:
modern-web-guidance search "animate height auto", ১০টি প্রাসঙ্গিক ম্যাচ (~৫৩০ টোকেন) পাওয়া যাচ্ছে। - এজেন্ট সম্পূর্ণ গাইড (প্রায় ৮০০ টোকেন) পুল করতে
modern-web-guidance retrieve animate-to-intrinsic-sizesরান করে। এটি এখন মানানসই, ফলব্যাক এবং টেকনিকের জন্য পেশাদার পদ্ধতি প্রয়োগের সাথে সজ্জিত।
MCP সার্ভার বা ওয়েব সার্চের পরিবর্তে CLI স্কিল কেন?
- MCP টুল হয় টোকেন নষ্ট করে অথবা সেগুলির ট্রিগার মেকানিজম নির্ভরযোগ্য নয় (ডায়নামিক টুল ডিসকভারির কারণে)। আমাদের স্কিলের বিবরণ কার্যকারিতার জন্য মিনিম্যাক্স করা হয়েছে এবং এজেন্টকে শুধুমাত্র উপযুক্ত হলে নির্দেশিকা গ্রহণ করতে সক্ষম করে।
- বিল্ট-ইন ওয়েব সার্চ, আপ-টু-ডেট, কিউরেট করা
DO/DO NOTইমপ্লিমেন্টেশন প্যাটার্নের পরিবর্তে ২০১৫ Stack Overflow উত্তর ও রেফারেন্স ডকুমেন্ট দেখায়। এছাড়াও, নেটওয়ার্কের মাধ্যমে এটি করতে কয়েক সেকেন্ড সময় লাগে এবং অফলাইন স্যান্ডবক্সে এটি কাজ করে না, যেখানে লোকাল CLI কয়েক মিলিসেকেন্ডে CPU-তে রান করে।
Gen 1: ৫০৭ এমবি C++ প্রোটোটাইপ
মডার্ন ওয়েব নির্দেশিকার প্রথম ভার্সনে লোকাল RAG স্ট্যাক ব্যবহার করা হয়েছিল: LanceDB, Apache Arrow এবং onnxruntime-native-এর সাথে Transformers.js।
এটি ডেভেলপমেন্ট মেশিনে ভাল কাজ করেছে, তবে এটি এজেন্টের দক্ষতার জন্য একটি মোটামুটি ফিট ছিল:
- আপনি যখন কোনও প্রোজেক্টে একটি স্কিল যোগ করেন (অথবা কোনও এজেন্ট এটিকে
npxদিয়ে আহ্বান করে), তখন আপনি আশা করেন না যে আপনাকেnpm installডাউনলোড করার জন্য অপেক্ষা করতে হবে, যা আর্কিটেকচার-নির্ভর.nodeবাইনারি বাnode-gypC++ কম্পাইলেশন, যা ক্লাউড স্যান্ডবক্সে নিয়মিত ব্যর্থ হয়। node_modulesএক্সট্র্যাক্ট করা ডিরেক্টরির সাইজ ৫০৭ এমবি।
Gen 2: TensorFlow.js-এর সাইজ কমিয়ে ২৩ এমবি করা
আমরা চেয়েছিলাম, Node যেখানেই রান করুক না কেন, সেখানে যেন কোনও নেটিভ কম্পাইলেশন না হয় এবং ইনস্ট্যান্ট এক্সিকিউশন হয়। তাই এপ্রিল মাসে, আমরা নেটিভ স্ট্যাকের পরিবর্তে @tensorflow/tfjs-এ all-MiniLM-L6-v2 রান করা পিওর-জাভাস্ক্রিপ্ট সিপিইউ ইঞ্জিন ব্যবহার করেছি:
- esbuild-এ
onnxruntime-nodeশিম আউট করা হয়েছে এবং Hugging Face টোকেনাইজারকে একটি ছোট ইন-ট্রি BERT WordPiece টোকেনাইজার (০ টোকেন-আইডি অমিল) দিয়ে পরিবর্তন করা হয়েছে। - কিছু সোর্স-ম্যাপ এক্সপ্লোর করার পরে, pruned
@tensorflow/tfjs-backend-cpu-এর ৪০০+ মডিউল থেকে ২৬ কার্নেল MiniLM আসলে ব্যবহার করে, JS ইঞ্জিনকে ৬ এমবি থেকে ৮৩০ কেবি-তে সঙ্কুচিত করে। - বিল্ড-টাইম gzipped ভেক্টর এবং প্রায় ২০০টি গাইডের মধ্যে ইন-মেমরি
<1 msডট-প্রোডাক্ট স্ক্যানের জন্য LanceDB বাদ দেওয়া হয়েছে। - এম্বেডারকে
import()কলের পিছনে রাখুন যাতেretrieveএবংlistদশ মিলিসেকেন্ডের কম সময়ে শেষ হয়।
এর ফলে npm প্যাকেজের সাইজ কমে ২৩ এমবি হয়ে যায় এবং কোনও রানটাইম ডিপেন্ডেন্সি থাকে না। আমরা এটি শিপ করেছি এবং এজেন্টরা এর বিরুদ্ধে প্রায় ৭, ৫০,০০০ সার্চ করেছে।
প্রোডাকশনে MiniLM কোথায় ভেঙে গেছে
কয়েক মাস পরে, আমরা এমন ট্র্যাজেক্টরি লক্ষ্য করেছি যেখানে এজেন্টদের স্কিল ইনস্টল করা থাকলেও তারা লিগ্যাসি কোড লিখেছে।
একটি Codex রান-এ, একজন ডেভেলপার মুছে ফেলার কনফার্মেশন প্রম্পট চেয়েছেন। HTML <dialog closedby="any">-এর সাহায্যে অ্যাক্সেসযোগ্য কনফার্মেশন মোডাল তৈরি করার জন্য আমাদের কাছে একটি সম্পূর্ণ গাইড আছে।
এজেন্ট সঠিক কাজ করেছে এবং এটি সার্চ করেছে:
npx modern-web-guidance@latest search "confirm destructive action"
CLI [] রিটার্ন করেছে। তাই এজেন্ট কাঁধ ঝাঁকিয়ে window.confirm() লিখে দিল।
কেন এটি খালি ফেরত এসেছে? আমরা যখন লগ ও এম্বেডিং খুঁটিয়ে দেখেছি, তখন দুটি রিট্রিভাল গ্যাপ আমাদের চোখে পড়েছে:
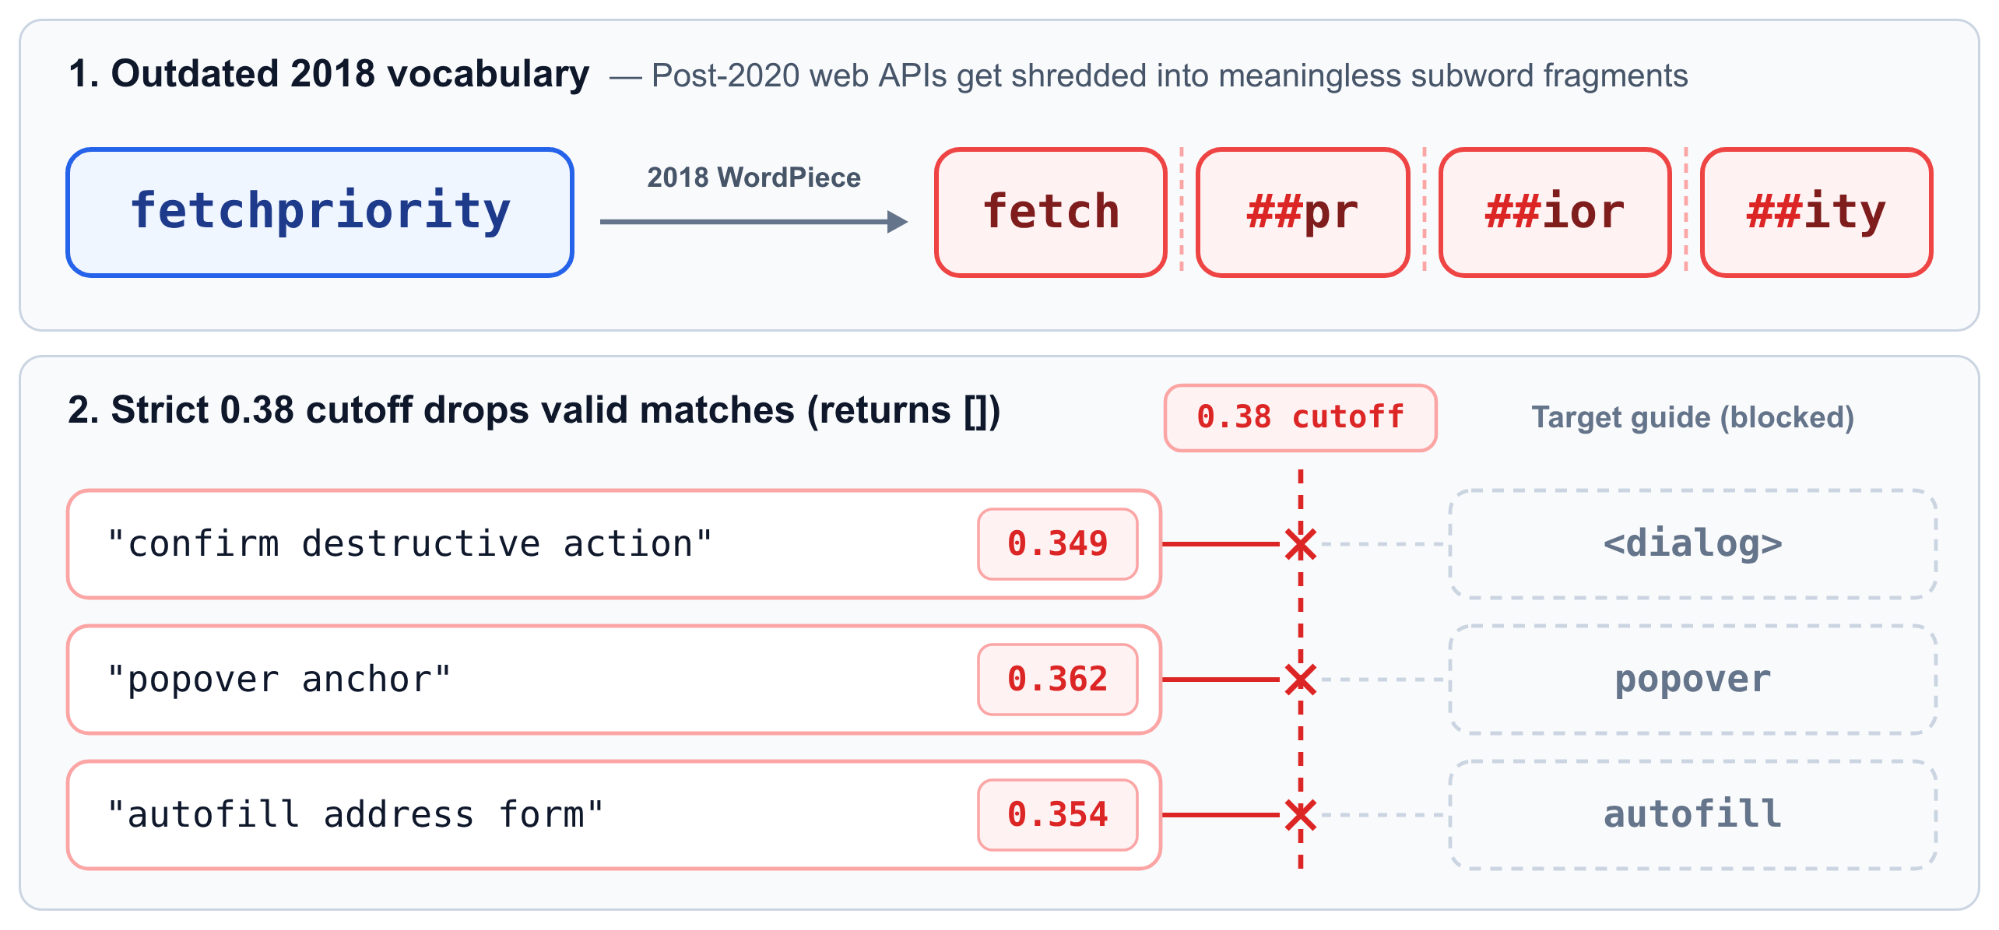
all-MiniLM-L6-v2-কে ২০১৮–২০২০ সালের মধ্যে ট্রেনিং দেওয়া হয়েছে, তাই এর WordPiece শব্দভাণ্ডার ২০২০ সালের পরের ওয়েব API-এর অস্তিত্ব সম্পর্কে আক্ষরিক অর্থেই জানে না। কোনও এজেন্টfetchpriority,popoverবাstartViewTransitionসার্চ করলে, ২০১৮ টোকেনাইজারfetchpriority-কে চারটি অর্থহীন সাবওয়ার্ডে ভেঙে দেয়:fetch·##pr·##ior·##ity।- আউট-অফ-স্কোপ কোয়েরি থেকে র্যান্ডম গাইড রিটার্ন করা আটকাতে, আগের PR-এ কঠোর
0.38কোসাইন সিমিলারিটি কাটঅফ যোগ করা হয়েছিল। যেহেতু MiniLM ৩-শব্দের বাক্যাংশ"confirm destructive action"-কে"dialog"-এর সাথে0.38-এর উপরে ব্রিজ করতে পারেনি (স্কোরিং0.349, যেখানে"popover anchor"পেয়েছে0.362এবং"autofill address form"পেয়েছে0.354), তাই গেট সঠিক ম্যাচগুলি বাদ দিয়েছে। আরও খারাপ হল, যখনইsearch[]রিটার্ন করেছে, আমাদের স্কিল সংক্রান্ত নির্দেশাবলী এজেন্টকেmodern-web-guidance list-এ ফিরে যেতে বলেছে, সমস্ত ~২০০টি গাইডের বিবরণ (~১,৫০০টি নষ্ট হওয়া টোকেন) প্রসঙ্গে ডাম্প করেছে।
রিট্রিভাল সংক্রান্ত সমস্যার সমাধান করা: রিয়েল টেলিমেট্রি, হাইব্রিড সার্চ এবং ১০টি ফলাফল দেখানো
আমাদের আসল বেঞ্চমার্ক ছিল ৮৫০টি সিন্থেটিক কোয়েরি যা গাইড থেকে জেনারেট করা হয়েছিল। এই কোয়েরিগুলি গাইডের শব্দগুচ্ছের সাথে খুব বেশি মিলে গিয়েছিল, যার ফলে এই ব্যর্থতাগুলি ধরা যায়নি। তাই আমরা অপ্ট-আউট করা CLI টেলিমেট্রি (যা শুধুমাত্র এজেন্টের ২–৫ শব্দের search আর্গুমেন্ট লগ করে, কখনও ব্যবহারকারীর প্রম্পট বা রিপোজিটরি কোড নয় এবং DISABLE_TELEMETRY=1 মেনে চলে) থেকে স্যাম্পেল করা ৪,০০০ লাইভ সার্চ এবং Claude Code, Codex CLI ও Gemini CLI জুড়ে নাইটলি এজেন্ট ইভ্যাল থেকে মাইন করা ১,০২৯ সার্চ-এর ভিত্তিতে একটি নতুন মূল্যায়ন হার্নেস (pnpm benchmark:rag) তৈরি করেছি।
আমাদের গিট ইতিহাসকে সেইসব হোল্ড-আউট কোয়েরির সাথে তুলনা করে দেখা গেছে যে 0.38 কাট-অফ [] খালি উত্তর ৮ গুণ বাড়িয়ে দিয়েছে। বেঞ্চমার্ক সেট করার পরে, এম্বেডিং মডেল নিয়ে কাজ করার আগে আমরা দুটি দ্রুত উন্নতি করেছি:
- হাইব্রিড কীওয়ার্ড + সিম্যান্টিক সার্চ: ডেন্স ভেক্টর সঠিক API নাম (
:user-invalid,showModal,details-name) অস্পষ্ট করে দেয়, অন্যদিকে এজেন্ট API নাম না জানলে কীওয়ার্ড সার্চ ইনটেন্ট কোয়েরি মিস করে যায়। আমরা বহুবচন স্টেম সহ একটি জিরো-ডিপেন্ডেন্সি BM25 (আপনি জানলে, আপনি জানেন) কীওয়ার্ড ইনডেক্স যোগ করেছি, প্রতিটি গাইডেরweb-feature-idsইনডেক্স করেছি এবং সিম্যান্টিক র্যাঙ্কিংয়ের সাথে BM25 ফিউজ করেছি। এখনsearchশুধুমাত্র[]রিটার্ন করে যখন সিম্যান্টিক সিমিলারিটি<0.30হয় এবং BM25-এ কোনও কিওয়ার্ড হিট থাকে না। - ৫টি বিস্তারিত ফলাফলের পরিবর্তে ১০টি সংক্ষিপ্ত ফলাফল: স্কিল সংক্রান্ত নির্দেশাবলী আগে থেকেই এজেন্টদের
similarityএবংtokenCountউপেক্ষা করতে বলেছে। অব্যবহৃত ফিল্ডগুলি বাদ দিয়ে, আমরা ১০টি কম্প্যাক্ট{id, description}ফলাফলকে ঠিক একই ~৫৩০-টোকেন বাজেটে ফিট করি, যা ৫টি ভার্বোস ফলাফলের সমান:
// Before: 5 verbose results (~105 tokens each = ~525 tokens)
{
  "id": "dialog",
  "category": "html",
  "description": "Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby.",
  "featuresUsed": ["dialog", "dialog-closedby"],
  "tokenCount": 780,
  "similarity": 0.49
}
// After: 10 compact results (~53 tokens each = ~530 tokens)
{"id":"dialog","description":"Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby."}
একসাথে, এই দুটি পরিবর্তন আমাদের সার্চ হিট রেটকে হেল্ড-আউট টেলিমেট্রি কোয়েরিতে ৮০.৬% থেকে ৯৪.৭%-এ উন্নীত করেছে, যা Hit@K (প্রত্যাশিত গাইডটি সেরা K ফলাফলে প্রদর্শিত হয় কিনা) হিসাবে পরিমাপ করা হয়।
Gen 3: প্রি-বেকড এম্বেডিং এবং ৭-লাইনের for লুপ
এমনকি 94.7% হিট রেটেও, আমাদের টেলিমেট্রি একটি স্পষ্ট অমিল দেখিয়েছে: লাইভ এজেন্ট সার্চের ৮৬.৭% ছিল মাত্র ২ থেকে ৫ শব্দ দীর্ঘ (মিডিয়ান: ৩ শব্দ)। প্রতিবার কোনও এজেন্ট ৩-শব্দের বাক্যাংশ সার্চ করলে, Node, TensorFlow.js বুট করছিল, ২২.৬ এমবি নিউরাল নেটওয়ার্ক পার্স করছিল এবং ৭৭০ মিলি সেকেন্ড কোল্ড-স্টার্ট লেটেন্সি ও ৩৪৬ এমবি পিক র্যাম ব্যবহার করছিল।
নিউরাল নেট ছাড়াই ৩-শব্দের কোয়েরি এম্বেড করার কোনও সহজ উপায় আছে কিনা জিজ্ঞাসা করা হলে, আমাদের Antigravity এজেন্ট অপরিচিত ML ডিস্টিলেশন টেকনিকের একটি স্ট্যাক নিয়ে ফিরে আসে: Model2Vec, Tokenlearn, Matryoshka ডাইমেনশন, Adagrad। (আপনি যদি আরও বিশদে জানতে চান, তাহলে আমাদের সার্চ কোয়ালিটি পৃষ্ঠা দেখুন।)
স্ট্যান্ডার্ড লোকাল RAG ব্যবহারকারীর CPU-তে একই ছোট মডেলের মাধ্যমে ডকুমেন্ট এবং কোয়েরি উভয়কেই প্রসেস করে। কিন্তু আমরা npm রিলিজ কাট করার পরে আমাদের ~২০০টি গাইড পরিবর্তন হয় না, তাই ২০১৮ সালের ছোট মডেলের সাথে সেগুলি এম্বেড করার কোনও কারণ নেই। পরিবর্তে, embed-guide-chunks.ts রিলিজের সময় gemini-embedding-001 ব্যবহার করে ক্লাউডে আমাদের সব গাইড ভেক্টর প্রি-বেক করে এবং বাইনারি ২৫৬-ডাইমেনশনাল Int8 ভেক্টর (guide-chunks.i8, 335 KB gzipped) হিসেবে সেগুলি শিপ করে।
কীভাবে একটি অফলাইন, জিরো-API-কী CLI প্রোজেক্ট ব্যবহারকারীর লাইভ কোয়েরিকে সেই একই Gemini ভেক্টর স্পেসে প্রজেক্ট করে? এজেন্ট কোয়েরি প্রায় সবসময় ২ থেকে ৫ শব্দের হয়, তাই রানটাইমে আমাদের ট্রান্সফর্মারের প্রয়োজন হয় না। আমাদের শুধু পরিচিত শব্দের (table) জন্য ভেক্টরের একটি লুকআপ টেবিল এবং সেগুলি যোগ করার একটি স্মার্ট উপায় প্রয়োজন। রানটাইমে, সম্পূর্ণ ২৩ এমবি TensorFlow.js পাইপলাইন static-embedder.ts-এ ৭-লাইনের for লুপে ভেঙে যায়:
// Each word's weight and Int8 scale are pre-folded into `scales[i]`
for (const [i, f] of enc) {
  const wt = scales[i] * f;
  const offset = i * 256;
  for (let k = 0; k < 256; k++) {
    out[k] += wt * table[offset + k];
  }
}
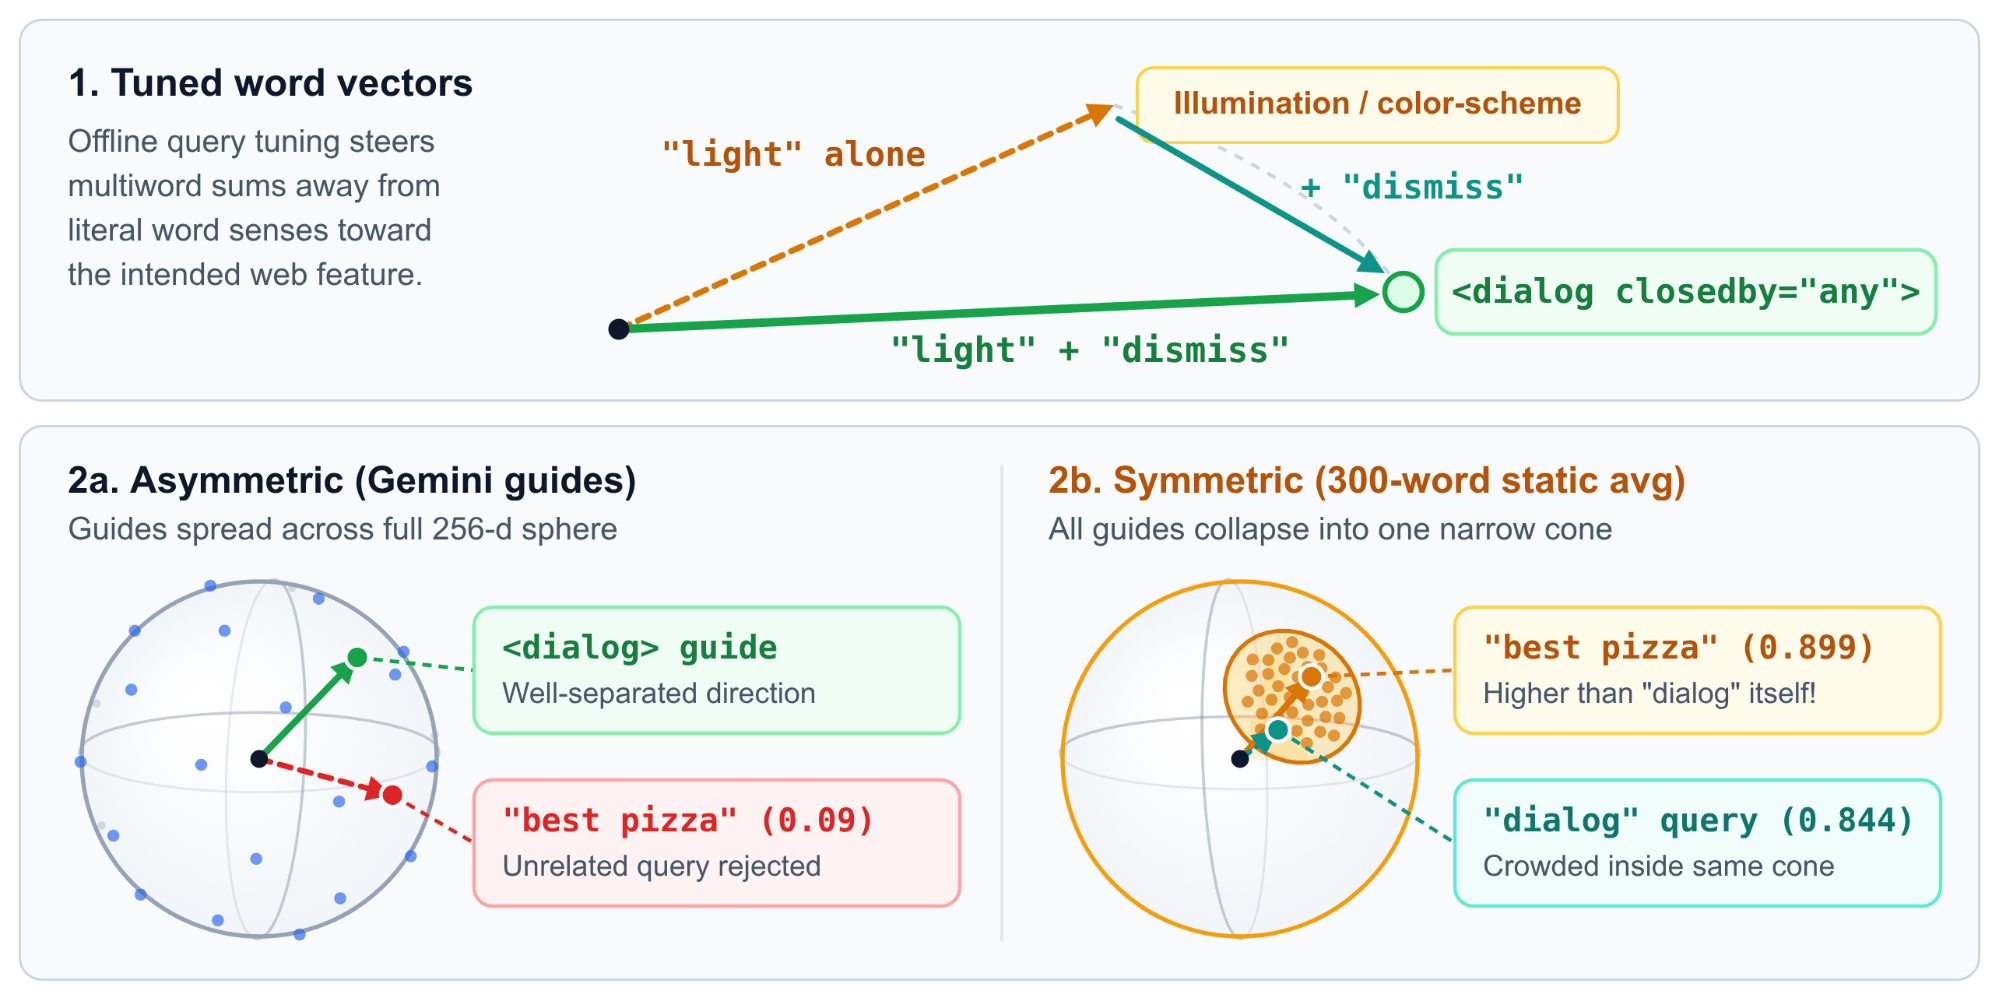
সেই লুকআপ টেবিল (train-query-words.ts) তৈরি করতে, আমরা ২৯,১৬৫-শব্দের শব্দভাণ্ডার (যেখানে fetchpriority, light-dismiss, popover ও scrollytelling-এর মতো আধুনিক ওয়েব শব্দগুলি স্বতন্ত্র সম্পূর্ণ শব্দ) নিয়েছি, সেগুলিকে gemini-embedding-001-এর সাথে এম্বেড করেছি এবং ৩৩,০০০টি আসল ওয়েব কোয়েরির বিপরীতে অফলাইনে শব্দ ভেক্টর টিউন করেছি যাতে একাধিক শব্দের কম্বিনেশন সঠিক জায়গায় পৌঁছায় (যেমন, "light" + "dismiss", <dialog closedby="any">-এর দিকে নির্দেশ করে, আলোকসজ্জা বা রঙের স্কিমের দিকে নয়)। Int8 (query-words.i8)-এ কম্প্রেস করা হয়েছে, সম্পূর্ণ লুকআপ টেবিল 5.3 MB gzipped করা হয়েছে।
গাইড এম্বেড করার জন্য সেই স্ট্যাটিক লুকআপ টেবিল ব্যবহার করে ক্লাউড বিল্ড ধাপটি এড়িয়ে যান না কেন? আমরা প্রথমে সেটি চেষ্টা করেছিলাম এবং সম্পূর্ণ অনুচ্ছেদের ক্ষেত্রে তা ভেঙে পড়েছিল: ৩টি কোয়েরি শব্দের যোগফল শার্প থাকে, কিন্তু সম্পূর্ণ নির্দেশিকা জুড়ে শত শত শব্দের গড় প্রতিটি নির্দেশিকাকে সাধারণ ইংরেজি গড়ের কাছাকাছি একটি সংকীর্ণ কোণে ভেঙে দেয় (এমন একটি বিন্দুতে যেখানে "best pizza in new york" আমাদের dialog নির্দেশিকার বিপরীতে একটি 0.899 কোসাইন সাদৃশ্য স্কোর করেছে, যা কোয়েরি "dialog"-এর থেকে বেশি 0.844-এ!)। সম্পূর্ণ-মডেল Gemini নির্দেশিকা এম্বেডিংয়ের (guide-chunks.i8) বিপরীতে ৩-শব্দের স্ট্যাটিক কোয়েরি লুকআপ (query-words.i8) পেয়ার করলে, আমরা ক্লাউড-গ্রেড নির্ভুলতা পাই, যেখানে কোয়েরি এখনও ৩০ µs-এ অফলাইনে চলে।
তিনটি জেনারেশন জুড়ে স্কোরবোর্ড
আমাদের রিলিজ মাইলস্টোন জুড়ে, Hit@K-এর পারফর্ম্যান্স ৭৮.২% থেকে বেড়ে ৯৫.৪% হয়েছে। এর মধ্যে সম্পূর্ণ ডকুমেন্ট এম্বেডিং থেকে শুরু করে স্ট্যাটিক Int8 এম্বেডার (ক্লাউড gemini-embedding-001 API-এর ৯৬.৯%-এর সাথে তুলনা করে) পর্যন্ত অন্তর্ভুক্ত:
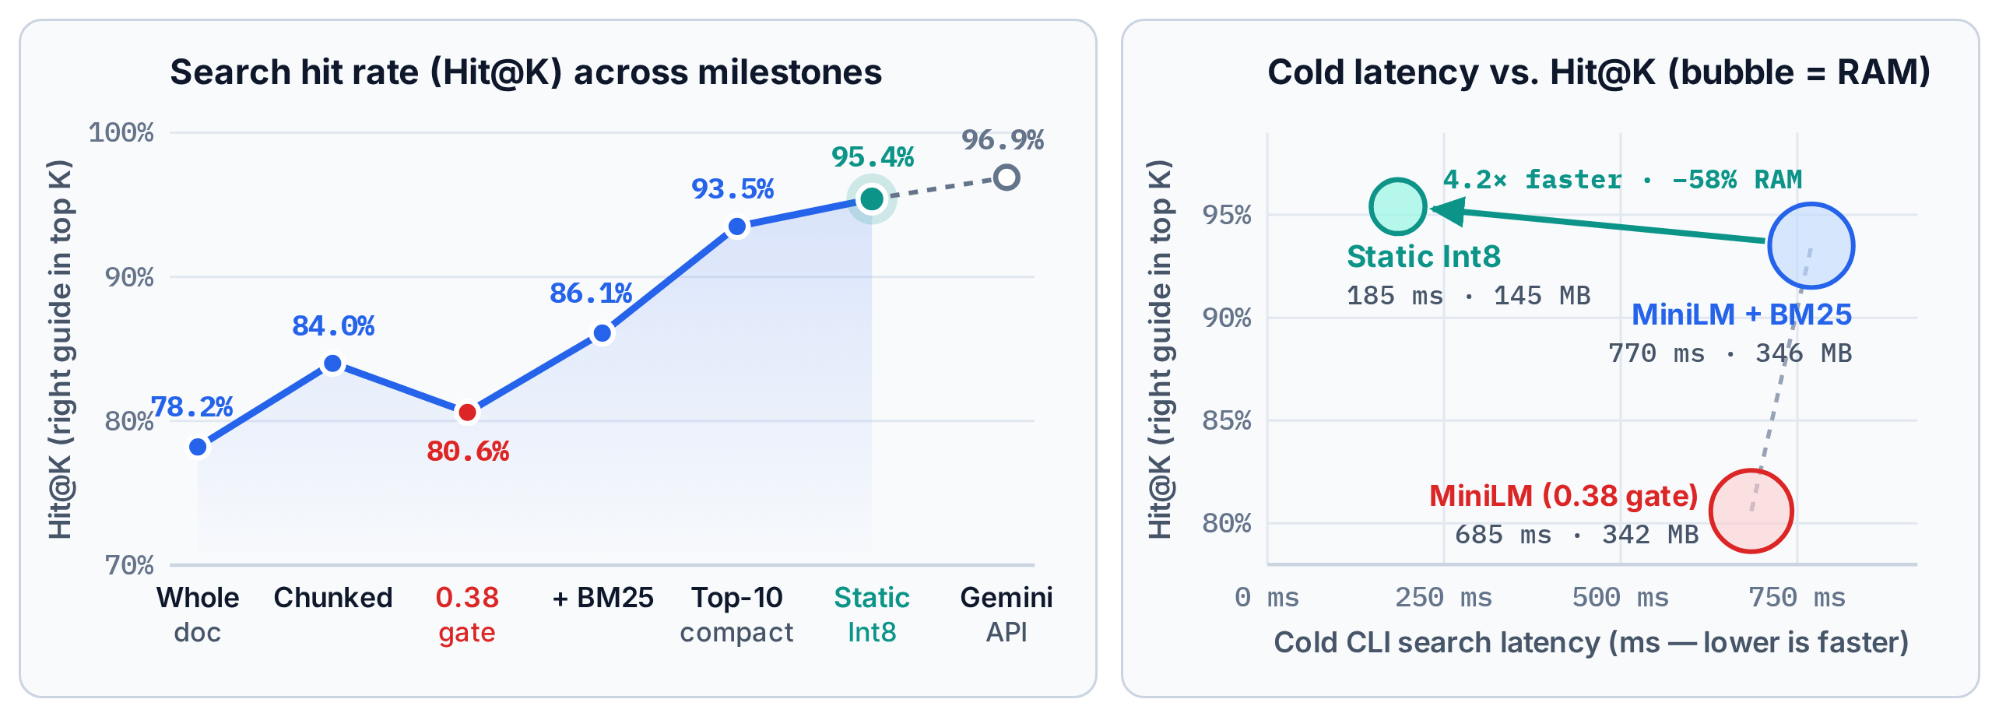
স্ট্যাটিক এম্বেডার ল্যান্ড করার পরে তিনটি জেনারেশন কীভাবে স্ট্যাক আপ করে তা এখানে দেওয়া হল:
এবং আপনি যদি আগে থেকে সেই ভাঙা Codex কোয়েরি চালান:
npx modern-web-guidance@latest search "confirm destructive action"
dialog গাইড তালিকার একদম উপরে ফিরে আসে।
(আপনি আমাদের সার্চ কোয়ালিটি ড্যাশবোর্ড থেকে সব মাইলস্টোন, কোয়েরির দৈর্ঘ্য ও K হরাইজন জুড়ে ইন্টার্যাক্টিভ চার্ট এক্সপ্লোর করতে পারবেন।)
কোড সস্তা; পরিমাপ করাই হল কাজ
একজন এজেন্ট কয়েক মিনিটের মধ্যে BM25 র্যাংকার বা ওয়ার্ড-ভেক্টর ডিস্টিলেশন স্ক্রিপ্ট লিখতে পারেন। ক্যান্ডিডেট ইমপ্লিমেন্টেশন জেনারেট করা আর কোনও বাধা নয়। কোনও পরিবর্তন আসলে সাহায্য করেছে কিনা (অথবা আমাদের 0.38 গেটের মতো প্রোডাকশন সার্চের ৯% চুপচাপ ভেঙে দিয়েছে) তা জানা প্রায় পুরো কাজ।
আমরা কীভাবে এই সিস্টেমটি তৈরি করেছি তা এখানে দেওয়া হল:
- নর্থ স্টার গোল নির্ধারণ করুন এবং যেকোনও একটি ইমপ্লিমেন্টেশনের পরিবর্তে পরিমাপের হার্নেসে ইনভেস্ট করুন। আমরা কোনও রিট্রিভার লেখার চেয়ে
pnpm benchmark:ragতৈরি করতে, ৫,০০০টি আসল কোয়েরি কিউরেট করতে এবং মানুষের রেটিংয়ের সাথে আমাদের অটোমেটেড গ্রেডিং ক্যালিব্রেট করতে অনেক বেশি সময় ব্যয় করেছি। - আপনি এবং আপনার এজেন্টরা কীভাবে কোয়ালিটি বিচার করেন তার জন্য একটি রুব্রিক তৈরি করুন এবং বাস্তব-জগতের ডেটা হিট করার পরে এটি বিকশিত হবে বলে আশা করুন। অনেকে একে "মেজারমেন্ট-ফার্স্ট" বলেন, যা আংশিকভাবে সঠিক: আপনি প্রথম দিনেই জানা-উত্তর চেক করার প্রাথমিক পদ্ধতি লিখতে পারেন, কিন্তু বাস্তব ব্যর্থতাগুলি পরীক্ষা করার আগে আপনি শূন্য থেকে একটি ভাল রুব্রিক ডিজাইন করতে পারবেন না (শঙ্কর এবং অন্যান্যরা এটিকে Who Validates the Validators?-এ ক্রাইটেরিয়া ড্রিফ্ট বলে উল্লেখ করেছেন)। এজেন্ট ১,৫০০-টোকেন
listফলব্যাক ট্রিগার করছে দেখে আমরা রিকলের পাশাপাশি টোকেন ব্লটের জন্য পেনাল্টি আরোপ করতে বাধ্য হয়েছি। - বিশ্বস্ত পরিমাপের ব্যবস্থা থাকলে, বিভিন্ন ইমপ্লিমেন্টেশন নিয়ে আগ্রাসীভাবে এক্সপেরিমেন্ট করুন এবং স্কোরবোর্ডকে আর্কিটেকচার সংক্রান্ত বিতর্কের নিষ্পত্তি করতে দিন। কোনও বেঞ্চমার্ক কয়েক সেকেন্ডে ৫,০০০ কোয়েরি গ্রেড করলে, ২৩ এমবি ট্রান্সফর্মারকে ৭-লাইনের
Int8লুপ হারাতে পারবে কিনা তা নিয়ে আপনাকে PR-এ তর্ক করতে হবে না। এক বিকেলে পাঁচটি পদ্ধতি ব্যবহার করে দেখুন এবং যেটি সবচেয়ে ভাল সেটি বেছে নিন।
অবশ্যই, সব কোড (এম্বেডার, ডিস্টিলার ও বেঞ্চমার্ক হার্নেস সহ) ওপেন সোর্স।