


पब्लिश होने की तारीख: 12 नवंबर, 2026
इस हफ़्ते हमने मॉडर्न वेब गाइडेंस 1.0 लॉन्च किया है. यह एक ओपन-सोर्स स्किल है. इसकी मदद से, कोडिंग एजेंट लेगसी वर्कअराउंड के बजाय, मॉडर्न वेब प्लैटफ़ॉर्म की सुविधाओं का इस्तेमाल कर सकते हैं. इस पोस्ट में, लोकल सर्च इंजन के बारे में बताया गया है. यह आपके टास्क के लिए सबसे काम की गाइड ढूंढता है. इससे आपके टोकन भी खर्च नहीं होते.
अगर किसी इंजीनियर को यह बताया जाए कि आपने उसके कोडिंग एजेंट के लिए, 1.7 एमबी के Markdown टेक्स्ट के साथ एक नॉलेज बेस बनाया है, तो वह दो सवाल पूछेगा:
- "इससे मेरी कॉन्टेक्स्ट विंडो में कितने टोकन डंप होंगे?"
- "इसके लिए किस तरह के बड़े वेक्टर डेटाबेस की ज़रूरत होती है?"
पिछले छह महीनों में, हमने अपने लोकल रीट्रिवल इंजन को तीन बार फिर से बनाया. हमने C++ बाइंडिंग के 507 एमबी से शुरुआत की. इसके बाद, TensorFlow.js का इस्तेमाल करके, 23 एमबी के प्योर JavaScript पर आए. इसके बाद, हम 7 एमबी के पैकेज पर आए, जिसमें क्वेरी एम्बेडिंग for की सात लाइन का लूप है. इस दौरान, हमने सटीक जानकारी देने की सुविधा को बेहतर बनाया.
एजेंटिक आरएजी और प्रोग्रेसिव डिसक्लोज़र
AGENTS.md में 1.7 एमबी का मार्कडाउन टेक्स्ट डंप करना व्यावहारिक नहीं है. इसमें एचटीएमएल/सीएसएस/वेब एपीआई की 200 से ज़्यादा गाइड शामिल हैं. हम प्रोग्रेसिव डिसक्लोज़र में भरोसा रखते हैं. हालांकि, हमें पता है कि बड़े पैमाने पर Markdown इंडेक्स का इस्तेमाल करने से, टोकन की खपत बढ़ जाएगी.
इस समस्या को हल करने के लिए, हम सर्च सीएलआई की मदद से एजेंटिक आरएजी का इस्तेमाल करते हैं:
- जब एजेंट का इस्तेमाल नहीं किया जा रहा होता है, तब उसे सिर्फ़ स्किल का ब्यौरा दिखता है (~205 टोकन). ब्यौरा, Anthropic के स्किल ट्रिगर से जुड़े दिशा-निर्देशों के मुताबिक हो, ताकि एजेंट काम के फ़्रंटएंड टास्क पर स्किल को ट्रिगर कर सके.
- फ़्रंटएंड टास्क के लिए, एजेंट सीएलआई का इस्तेमाल करके,
modern-web-guidance search "animate height auto"को खोज सकता है. इससे उसे 10 काम के मैच (~530 टोकन) मिलते हैं. - एजेंट, पूरी गाइड (करीब 800 टोकन) को फ़ेच करने के लिए
modern-web-guidance retrieve animate-to-intrinsic-sizesचलाता है. अब इसमें साथ काम करने की सुविधा, फ़ॉलबैक, और तकनीक के लिए, लागू करने के सबसे सही तरीके शामिल हैं.
एमसीपी सर्वर या वेब खोज के बजाय, सीएलआई स्किल का इस्तेमाल क्यों करना चाहिए?
- एमसीपी टूल, टोकन बर्बाद करते हैं या उनके ट्रिगर करने के तरीके भरोसेमंद नहीं होते. ऐसा डाइनैमिक टूल डिस्कवरी की वजह से होता है. हमारे स्किल के ब्यौरे को इस तरह से तैयार किया गया है कि वह ज़्यादा से ज़्यादा असरदार हो. इससे एजेंट को सिर्फ़ ज़रूरत पड़ने पर ही निर्देश मिलते हैं.
- पहले से मौजूद वेब खोज की सुविधा, 2015 के Stack Overflow के जवाब और रेफ़रंस दस्तावेज़ दिखाती है. इसके बजाय, उसे अप-टू-डेट और चुने गए
DO/DO NOTलागू करने के पैटर्न दिखाने चाहिए. साथ ही, नेटवर्क पर इसे चलाने में कुछ सेकंड लगते हैं और यह ऑफ़लाइन सैंडबॉक्स में काम नहीं करता. वहीं, लोकल सीएलआई, सीपीयू पर कुछ मिलीसेकंड में चलता है.
पहली जनरेशन: 507 एमबी का C++ प्रोटोटाइप
मॉडर्न वेब गाइडेंस के पहले वर्शन में, लोकल आरएजी स्टैक का इस्तेमाल किया गया था: LanceDB, Apache Arrow, और onnxruntime-native के साथ Transformers.js.
यह डेवलपमेंट मशीन पर ठीक से काम कर रहा था, लेकिन एजेंट की स्किल के लिए यह सही नहीं था:
- जब किसी प्रोजेक्ट में कोई स्किल जोड़ी जाती है (या कोई एजेंट उसे
npxसे शुरू करता है), तो आपकोnpm installआर्किटेक्चर पर निर्भर.nodeबाइनरी याnode-gypC++ कंपाइलेशन डाउनलोड होने का इंतज़ार नहीं करना पड़ता. ये क्लाउड सैंडबॉक्स में अक्सर काम नहीं करते. node_modulesडायरेक्ट्री को एक्सट्रैक्ट करने के बाद, उसका साइज़ 507 एमबी था.
दूसरी जनरेशन: TensorFlow.js को 23 एमबी तक कम करना
हम चाहते थे कि नेटिव कंपाइलेशन की ज़रूरत न पड़े और Node जहां भी चले वहां तुरंत एक्ज़ीक्यूशन हो. इसलिए, अप्रैल में हमने नेटिव स्टैक को @tensorflow/tfjs पर चलने वाले all-MiniLM-L6-v2 के प्योर-JavaScript सीपीयू इंजन से बदल दिया:
- esbuild में
onnxruntime-nodeको शिम किया गया और Hugging Face tokenizer को छोटे इन-ट्री BERT WordPiece tokenizer से बदल दिया गया (0 टोकन-आईडी मैच नहीं हुआ). - सोर्स-मैप को एक्सप्लोर करने के बाद,
@tensorflow/tfjs-backend-cpuके 400 से ज़्यादा मॉड्यूल को कम करके 26 कर्नेल पर लाया गया. MiniLM असल में इनका इस्तेमाल करता है. इससे JS इंजन का साइज़ 6 एमबी से घटकर 830 केबी हो गया. - हमने LanceDB का इस्तेमाल बंद कर दिया. इसकी वजह यह थी कि हमें बिल्ड-टाइम पर gzipped वेक्टर और इन-मेमोरी
<1 msडॉट-प्रॉडक्ट स्कैन की ज़रूरत थी. यह स्कैन, सभी 200 या उससे ज़्यादा गाइड के लिए किया जाना था. - एम्बेडर को
import()कॉल के पीछे रखें, ताकिretrieveऔरlist10 मिलीसेकंड से कम समय में खत्म हो जाएं.
इससे npm पैकेज का साइज़ 23 एमबी हो गया और इसमें कोई रनटाइम डिपेंडेंसी नहीं थी. हमने इसे लॉन्च किया और एजेंट ने इसके ख़िलाफ़ करीब 7, 50,000 खोजें कीं.
MiniLM प्रोडक्शन में कहां काम नहीं कर रहा है
कुछ महीनों बाद, हमने उन एजेंट के ट्रैजेक्ट्री की जांच की जिनके पास स्किल इंस्टॉल थी, लेकिन वे अब भी लेगसी कोड लिख रहे थे.
एक Codex रन में, एक डेवलपर ने मिटाने की पुष्टि करने वाला प्रॉम्प्ट मांगा. हमारे पास एचटीएमएल <dialog closedby="any"> की मदद से, सुलभ पुष्टि करने वाले मॉडल बनाने के बारे में पूरी गाइड है.
एजेंट ने सही काम किया और यह खोजा:
npx modern-web-guidance@latest search "confirm destructive action"
सीएलआई ने [] दिखाया. इसलिए, एजेंट ने कंधे उचकाए और window.confirm() लिख दिया.
यह खाली क्यों है? जब हमने लॉग और एंबेडिंग की जांच की, तो हमें जानकारी को वापस पाने में दो कमियां मिलीं:
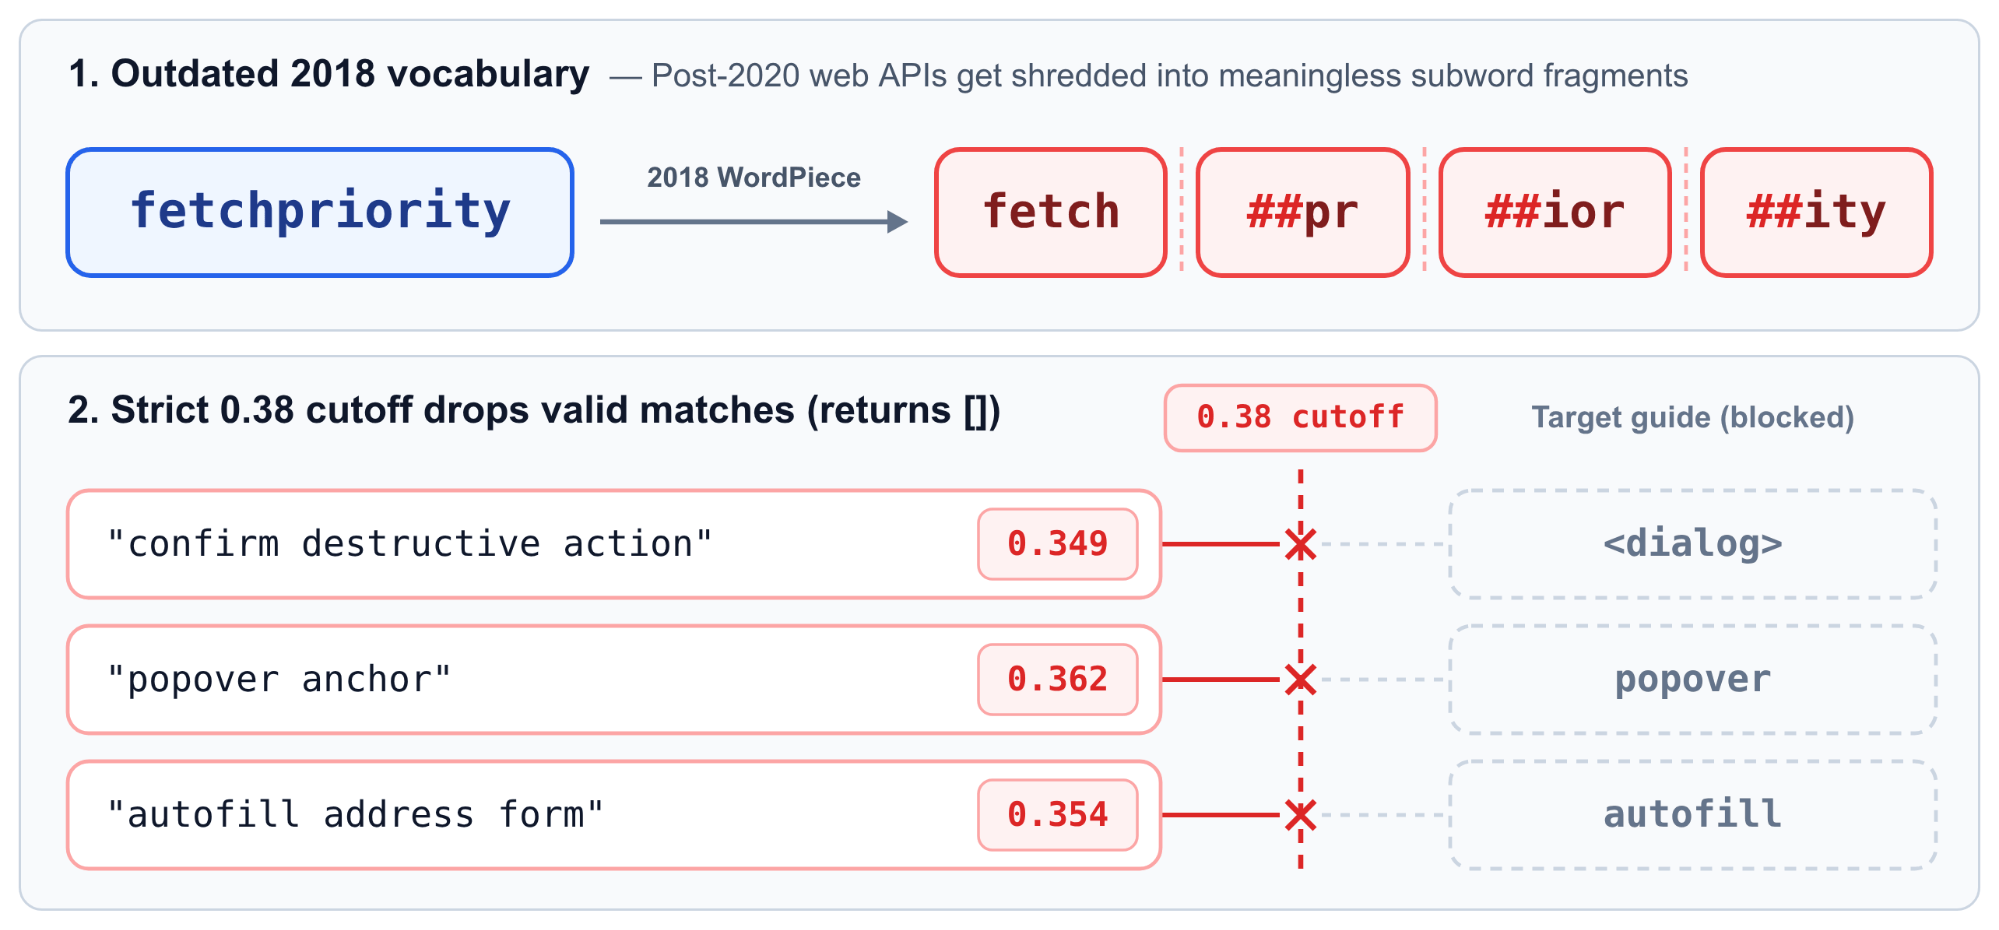
all-MiniLM-L6-v2को 2018 से 2020 के बीच ट्रेनिंग दी गई थी. इसलिए, इसकी WordPiece वोकैबलरी को यह नहीं पता है कि 2020 के बाद के वेब एपीआई मौजूद हैं. जब कोई एजेंटfetchpriority,popoverयाstartViewTransitionको खोजता है, तो 2018 का टोकनाइज़रfetchpriorityको चार ऐसे सबवर्ड में बांट देता है जिनका कोई मतलब नहीं होता:fetch·##pr·##ior·##ity.- स्कोप से बाहर की क्वेरी के लिए, रैंडम गाइड न दिखें, इसके लिए पिछले पीआर में सख्त
0.38कोसाइन सिमिलैरिटी कटऑफ़ जोड़ा गया था. MiniLM, तीन शब्दों वाले वाक्यांश"confirm destructive action"को"dialog"से0.38से ज़्यादा स्कोर पर नहीं जोड़ सका. इसका स्कोर0.349था, जबकि"popover anchor"को0.362और"autofill address form"को0.354स्कोर मिला. इस वजह से, गेट ने मान्य मैच हटा दिए. इससे भी खराब बात यह है कि जब भीsearchने[]दिखाया, तो हमारे स्किल से जुड़े निर्देशों ने एजेंट कोmodern-web-guidance listपर वापस जाने के लिए कहा. इससे, कॉन्टेक्स्ट में करीब 200 गाइड के ब्यौरे (करीब 1,500 बर्बाद हुए टोकन) डंप हो गए.
जानकारी वापस पाने की सुविधा को ठीक करना: रीयल टेलीमेट्री, हाइब्रिड सर्च, और 10 नतीजे दिखाना
हमारा ओरिजनल बेंचमार्क, गाइड से जनरेट की गई 850 सिंथेटिक क्वेरी थीं. ये क्वेरी, गाइड के शब्दों से काफ़ी मिलती-जुलती थीं. इस वजह से, इन गड़बड़ियों को पकड़ना मुश्किल था. इसलिए, हमने एक नया इवैलुएशन हार्नेस (pnpm benchmark:rag) बनाया. इसमें, ऑप्ट-आउट किए गए सीएलआई टेलीमेट्री से सैंपल की गई करीब 4,000 लाइव सर्च शामिल हैं. यह टेलीमेट्री, सिर्फ़ एजेंट के 2 से 5 शब्दों वाले search आर्ग्युमेंट को लॉग करती है. इसमें उपयोगकर्ता के प्रॉम्प्ट या रिपॉज़िटरी कोड को कभी लॉग नहीं किया जाता. साथ ही, यह DISABLE_TELEMETRY=1 का पालन करती है. इसके अलावा, इसमें Claude Code, Codex CLI, और Gemini CLI में हर रात होने वाले एजेंट के इवैलुएशन से मिली 1,029 सर्च भी शामिल हैं.
हमने Git के इतिहास में जाकर, उन क्वेरी को फिर से चलाया जिनके जवाब नहीं दिए गए थे. इससे हमें पता चला कि 0.38 कटऑफ़ की वजह से, [] के जवाब न देने की दर आठ गुना बढ़ गई थी. बेंचमार्क सेट करने के बाद, हमने एंबेडिंग मॉडल में बदलाव करने से पहले, दो अहम सुधार किए:
- हाइब्रिड कीवर्ड + सिमैंटिक सर्च: डेंस वेक्टर, एपीआई के सटीक नामों (
:user-invalid,showModal,details-name) को धुंधला कर देते हैं. वहीं, कीवर्ड सर्च से इंटेंट क्वेरी तब छूट जाती हैं, जब एजेंट को एपीआई का नाम नहीं पता होता. हमने बिना किसी डिपेंडेंसी के BM25 (अगर आपको पता है, तो पता है) कीवर्ड इंडेक्स जोड़ा है. इसमें प्लूरल स्टेमिंग की सुविधा है. साथ ही, हर गाइड केweb-feature-idsको इंडेक्स किया गया है और BM25 को सिमैंटिक रैंकिंग के साथ जोड़ा गया है. अबsearchसिर्फ़ तब[]दिखाता है, जब दोनों का मतलब<0.30हो और BM25 में कोई कीवर्ड हिट न हो. - ज़्यादा जानकारी वाले पांच नतीजों के बजाय, कम शब्दों में 10 नतीजे: स्किल के निर्देशों में एजेंट को पहले ही बताया गया है कि वे
similarityऔरtokenCountको अनदेखा करें. इस्तेमाल न किए गए फ़ील्ड को हटाकर, हम 10 छोटे{id, description}नतीजों को ठीक उसी ~530-टोकन बजट में फ़िट कर देते हैं जिसमें पांच बड़े नतीजे आते हैं:
// Before: 5 verbose results (~105 tokens each = ~525 tokens)
{
  "id": "dialog",
  "category": "html",
  "description": "Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby.",
  "featuresUsed": ["dialog", "dialog-closedby"],
  "tokenCount": 780,
  "similarity": 0.49
}
// After: 10 compact results (~53 tokens each = ~530 tokens)
{"id":"dialog","description":"Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby."}
इन दोनों बदलावों की वजह से, टेलीमेट्री से जुड़ी क्वेरी के लिए खोज के नतीजों में सही गाइड मिलने की दर 80.6% से बढ़कर 94.7% हो गई. इसे Hit@K के तौर पर मेज़र किया गया. इसका मतलब है कि उम्मीद के मुताबिक गाइड, टॉप K नतीजों में दिखती है या नहीं.
तीसरी जनरेशन: पहले से तैयार एंबेडिंग और सात लाइन का for लूप
94.7% हिट रेट होने के बावजूद, हमारी टेलीमेट्री से पता चला कि दोनों के बीच काफ़ी अंतर है: लाइव एजेंट की 86.7% खोजें सिर्फ़ दो से पांच शब्दों की थीं (औसतन: तीन शब्द). जब भी कोई एजेंट तीन शब्दों वाला वाक्यांश खोजता था, तब Node, TensorFlow.js को बूट करता था और 22.6 एमबी के न्यूरल नेटवर्क को पार्स करता था. साथ ही, 770 मि॰से॰ की कोल्ड-स्टार्ट लेटेंसी और 346 एमबी की पीक रैम का इस्तेमाल करता था.
जब हमने पूछा कि क्या न्यूरल नेट के बिना, तीन शब्दों वाली क्वेरी को एम्बेड करने का कोई आसान तरीका है, तो हमारे Antigravity एजेंट ने हमें एमएल डिस्टिलेशन की कई ऐसी तकनीकों के बारे में बताया जिनके बारे में हमें नहीं पता था: Model2Vec, Tokenlearn, Matryoshka डाइमेंशन, Adagrad. (अगर आपको इस बारे में ज़्यादा जानकारी चाहिए, तो हमारे खोज की क्वालिटी वाले पेज पर जाएं.)
स्टैंडर्ड लोकल आरएजी, उपयोगकर्ता के सीपीयू पर मौजूद एक ही छोटे मॉडल के ज़रिए, दस्तावेज़ों और क्वेरी, दोनों को प्रोसेस करता है. हालांकि, npm रिलीज़ के बाद हमारी ~200 गाइड में कोई बदलाव नहीं होता. इसलिए, उन्हें 2018 के छोटे मॉडल के साथ एम्बेड करने की कोई वजह नहीं है. इसके बजाय, embed-guide-chunks.ts रिलीज़ के समय क्लाउड में हमारे सभी गाइड वेक्टर को पहले से तैयार कर लेता है. इसके लिए, वह gemini-embedding-001 का इस्तेमाल करता है और उन्हें बाइनरी 256-डाइमेंशनल Int8 वेक्टर (guide-chunks.i8, 335 KB gzipped) के तौर पर शिप करता है.
ऑफ़लाइन और बिना एपीआई पासकोड वाला सीएलआई, उपयोगकर्ता की लाइव क्वेरी को Gemini के ठीक उसी वेक्टर स्पेस में कैसे प्रोजेक्ट करता है? एजेंट की क्वेरी में आम तौर पर दो से पांच शब्द होते हैं. इसलिए, हमें रनटाइम के दौरान ट्रांसफ़ॉर्मर की ज़रूरत नहीं होती. हमें सिर्फ़ जाने-पहचाने शब्दों (table) के लिए वेक्टर की एक लुकअप टेबल और उन्हें जोड़ने का एक स्मार्ट तरीका चाहिए. रनटाइम के दौरान, 23 एमबी की पूरी TensorFlow.js पाइपलाइन, static-embedder.ts में सात लाइनों के for लूप में सिमट जाती है:
// Each word's weight and Int8 scale are pre-folded into `scales[i]`
for (const [i, f] of enc) {
  const wt = scales[i] * f;
  const offset = i * 256;
  for (let k = 0; k < 256; k++) {
    out[k] += wt * table[offset + k];
  }
}
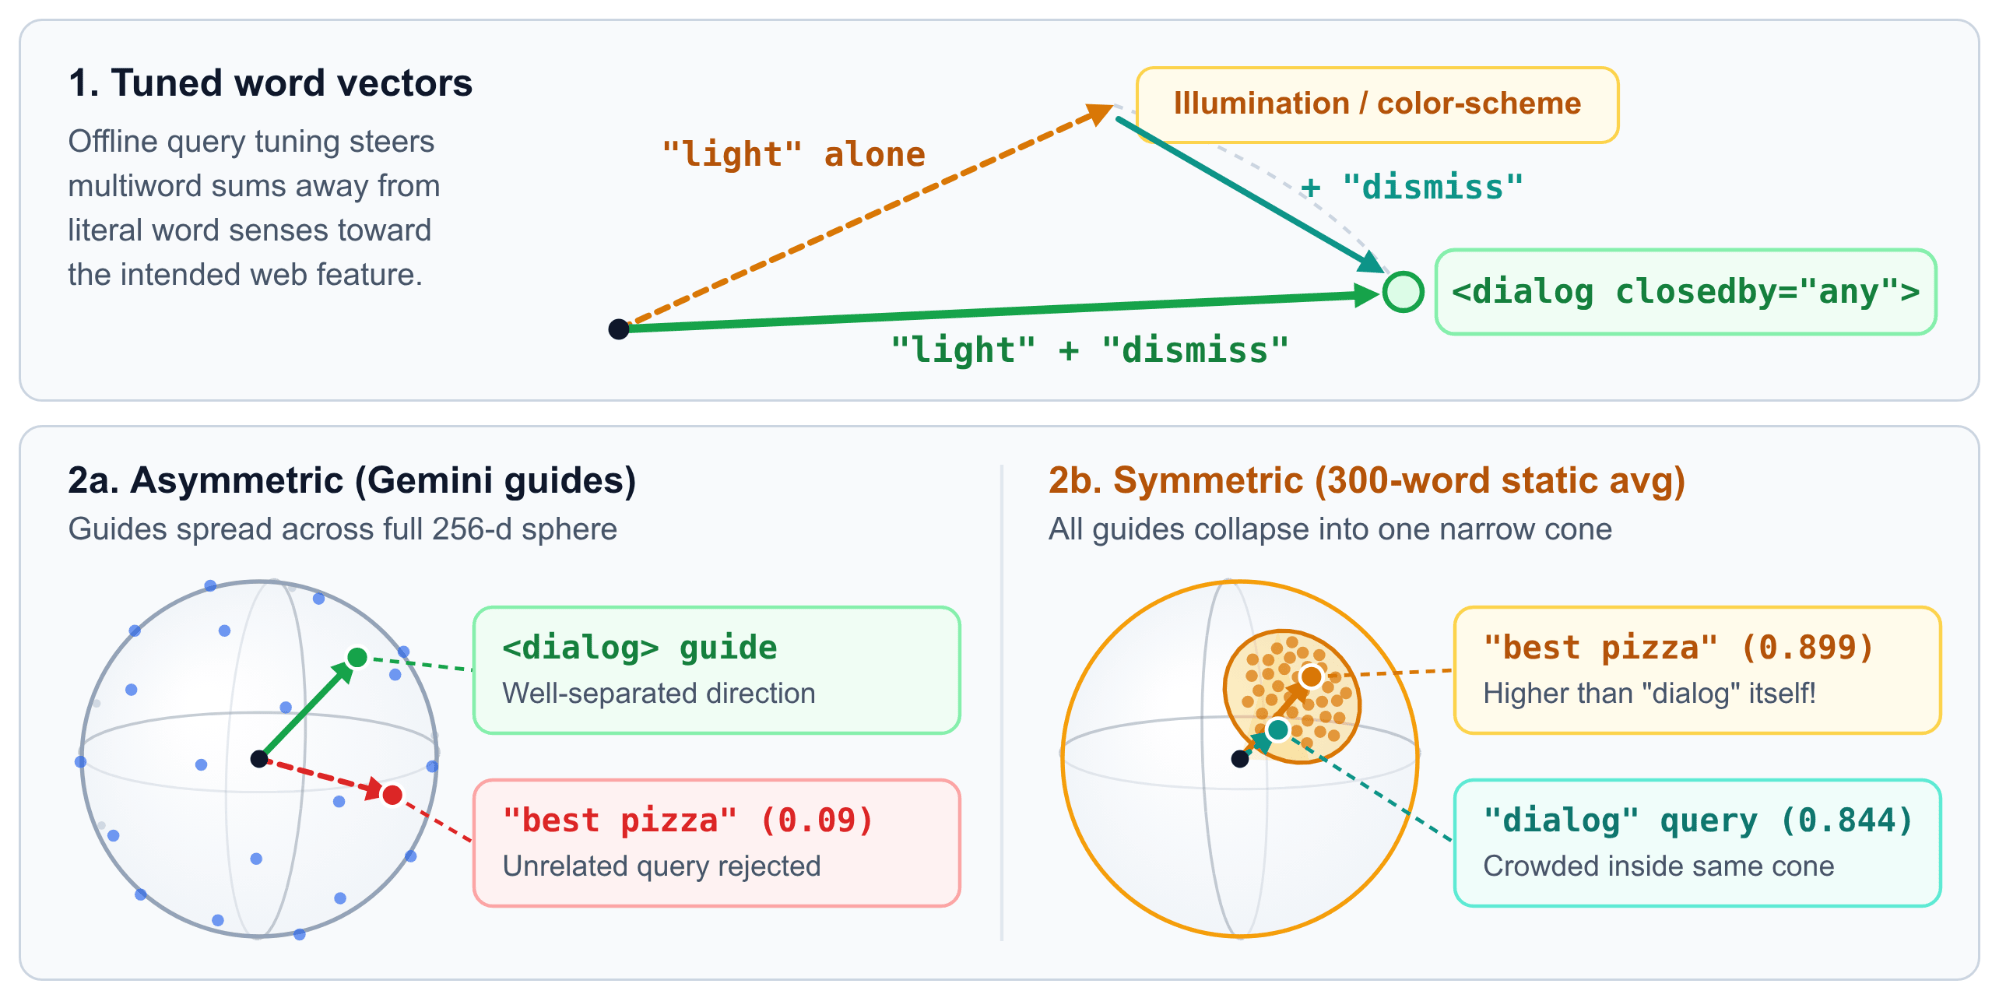
लुकअप टेबल (train-query-words.ts) बनाने के लिए, हमने 29,165 शब्दों की शब्दावली ली. इसमें fetchpriority, light-dismiss, popover, और scrollytelling जैसे आधुनिक वेब शब्द, अलग-अलग पूरे शब्द हैं. हमने उन्हें gemini-embedding-001 के साथ एम्बेड किया और 33,000 असल वेब क्वेरी के लिए, वर्ड वेक्टर को ऑफ़लाइन ट्यून किया. इससे कई शब्दों के कॉम्बिनेशन सही जगह पर दिखते हैं. उदाहरण के लिए, "light" + "dismiss", <dialog closedby="any"> की ओर इशारा करता है, न कि रोशनी या कलर स्कीम की ओर. Int8 (query-words.i8) तक कंप्रेस की गई पूरी लुकअप टेबल, 5.3 MB gzipped है.
गाइड को एम्बेड करने के लिए, स्टैटिक लुकअप टेबल का इस्तेमाल क्यों नहीं किया जाता? साथ ही, क्लाउड बिल्ड के चरण को क्यों नहीं छोड़ा जाता? हमने पहले यही तरीका आज़माया था, लेकिन पूरे पैराग्राफ़ के लिए यह तरीका काम नहीं आया: तीन शब्दों वाली क्वेरी के लिए यह तरीका सटीक रहता है, लेकिन पूरी गाइड में मौजूद सैकड़ों शब्दों का औसत निकालने पर, हर गाइड सामान्य अंग्रेज़ी के औसत के आस-पास एक छोटे से कोन में सिमट जाती है. इस हद तक कि "best pizza in new york" ने हमारी dialog गाइड के मुकाबले 0.899 कोसाइन समानता स्कोर किया, जो कि 0.844 पर क्वेरी "dialog" से ज़्यादा है! तीन शब्दों वाली स्टैटिक क्वेरी लुकअप (query-words.i8) को Gemini गाइड के फ़ुल-मॉडल एंबेडिंग (guide-chunks.i8) के साथ जोड़ने से, हमें क्लाउड-ग्रेड की सटीक जानकारी मिलती है. साथ ही, क्वेरी अब भी 30 µs में ऑफ़लाइन चलती हैं.
तीनों जनरेशन का स्कोरबोर्ड
रिलीज़ के अलग-अलग पड़ावों के दौरान, Hit@K की परफ़ॉर्मेंस में सुधार हुआ. पूरे दस्तावेज़ को एम्बेड करने पर, इसकी परफ़ॉर्मेंस 78.2% थी. वहीं, स्टैटिक Int8 एम्बेडर का इस्तेमाल करने पर, यह 95.4% हो गई. इसकी तुलना में, क्लाउड gemini-embedding-001 एपीआई का इस्तेमाल करने पर, इसकी परफ़ॉर्मेंस 96.9% थी:
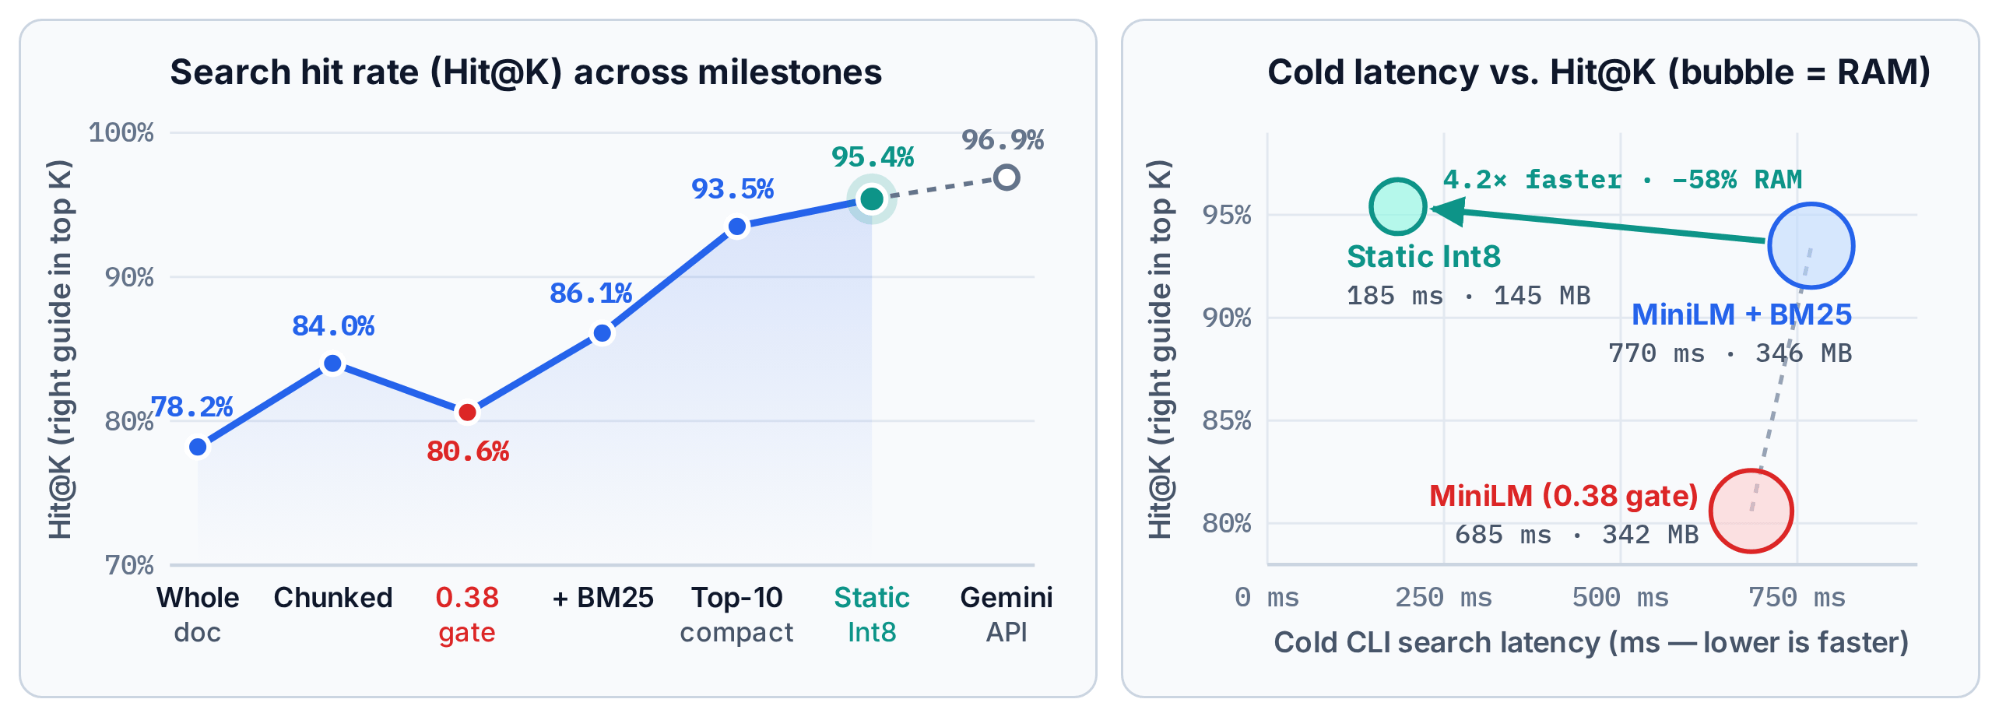
स्टैटिक एंबेडर को लैंड करने के बाद, तीनों जनरेशन इस तरह से स्टैक अप होती हैं:
अगर Codex की वह क्वेरी फिर से चलाई जाए, जो पहले काम नहीं कर रही थी:
npx modern-web-guidance@latest search "confirm destructive action"
dialog गाइड, सूची में सबसे ऊपर वापस आ जाती है.
(हमारे सर्च क्वालिटी डैशबोर्ड पर जाकर, सभी माइलस्टोन, क्वेरी की लंबाई, और K हॉरिज़न के इंटरैक्टिव चार्ट देखे जा सकते हैं.)
कोड लिखना आसान है, लेकिन मेज़रमेंट करना मुश्किल
कोई एजेंट, कुछ ही मिनटों में BM25 रैंकर या वर्ड-वेक्टर डिस्टिलेशन स्क्रिप्ट लिख सकता है. अब कोड जनरेट करना कोई मुश्किल काम नहीं है. यह जानना कि किसी बदलाव से वाकई मदद मिली या नहीं, यह हमारा मुख्य काम है. जैसे, हमारे 0.38 गेट ने प्रोडक्शन सर्च के 9% हिस्से को चुपचाप खराब कर दिया था.
हमने इस सिस्टम को इस तरह से डिज़ाइन किया है:
- सबसे अहम लक्ष्य तय करें और किसी एक तरीके को लागू करने के बजाय, मेज़रमेंट हार्नेस में निवेश करें. हमने
pnpm benchmark:ragको बनाने, 5,000 असल क्वेरी को क्यूरेट करने, और मैन्युअल रेटिंग के हिसाब से अपने ऑटोमेटेड ग्रेडिंग सिस्टम को कैलिब्रेट करने में, किसी भी रिट्रीवर को लिखने से कहीं ज़्यादा समय लगाया. - एक ऐसा रूब्रिक बनाएं जिससे आपको और आपके एजेंट को क्वालिटी का आकलन करने में मदद मिले. साथ ही, उम्मीद करें कि रीयल-वर्ल्ड डेटा मिलने के बाद, यह रूब्रिक और बेहतर हो जाएगा. लोग इसे "मेज़रमेंट-फ़र्स्ट" कहते हैं. हालांकि, यह सिर्फ़ आधा सच है: पहले दिन, जाने-पहचाने जवाबों की बुनियादी जांच की जा सकती है. हालांकि, असल गड़बड़ियों की जांच किए बिना, अच्छा रूब्रिक डिज़ाइन नहीं किया जा सकता. शंकर और अन्य लोगों ने Who Validates the Validators? में इसे क्राइटीरिया ड्रिफ़्ट कहा है. एजेंट को 1,500-टोकन वाले
listफ़ॉलबैक ट्रिगर करते हुए देखने की वजह से, हमें रिकॉल के साथ-साथ टोकन ब्लोट पर भी जुर्माना लगाना पड़ा. - भरोसेमंद मेज़रमेंट की मदद से, अलग-अलग तरीकों से एक्सपेरिमेंट करें. साथ ही, स्कोरबोर्ड की मदद से आर्किटेक्चर से जुड़ी बहस को खत्म करें. जब कोई बेंचमार्क कुछ ही सेकंड में 5,000 क्वेरी को ग्रेड कर देता है, तो आपको पीआर में इस बात पर बहस करने की ज़रूरत नहीं पड़ती कि सात लाइनों वाला
Int8लूप, 23 एमबी के ट्रांसफ़ॉर्मर को मात दे सकता है या नहीं. एक ही दोपहर में पांच अलग-अलग तरीके आज़माएं और सबसे सही तरीका चुनें.
ज़ाहिर है कि सारा कोड ओपन सोर्स है. इसमें एंबेडर, डिस्टिलर, और मानदंड हार्नेस शामिल हैं.