


公開日: 2026 年 11 月 12 日
今週、Google は Modern Web Guidance 1.0 をリリースしました。これは、コーディング エージェントが以前の回避策ではなく、最新のウェブ プラットフォーム機能を使用できるようにするオープンソースのスキルです。この投稿では、トークンを無駄にすることなく、タスクに最も関連性の高いガイドを見つけるローカル検索エンジンについて説明します。
エンジニアに、コーディング エージェント用に 1.7 MB の Markdown テキストでナレッジベースを構築したと伝えると、次の 2 つの質問をされます。
- 「このダンプはコンテキスト ウィンドウに何個のトークンを投入するのか?」
- 「どのような肥大化したベクトル データベースが必要ですか?」
過去 6 か月間で、ローカル検索エンジンを 3 回再構築しました。C++ バインディングの 507 MB から、TensorFlow.js を使用した純粋な JavaScript の 23 MB に、さらにクエリ エンベディングが 7 行の for ループである 7 MB のパッケージにまで削減され、精度も向上しました。
エージェント型 RAG と段階的な開示
200 を超える HTML / CSS / Web API ガイドを含む 1.7 MB のマークダウン テキストを AGENTS.md にダンプすることは現実的ではありません。Google は段階的な開示を重視していますが、Markdown インデックスは大規模になるとトークン効率が低下することがわかっています。
これを解決するために、検索 CLI を利用したエージェント型 RAG を使用します。
- 待機状態では、エージェントはスキルの説明(約 205 トークン)のみを認識します。この説明は Anthropic のスキル トリガー ガイドラインに沿っているため、エージェントは関連するフロントエンド タスクでスキルを呼び出します。
- フロントエンド タスクでは、エージェントは CLI を使用して検索できます。
modern-web-guidance search "animate height auto"を実行すると、10 件の関連する一致(約 530 トークン)が取得されます。 - エージェントは
modern-web-guidance retrieve animate-to-intrinsic-sizesを実行して、ガイド全体(約 800 トークン)を取得します。互換性、フォールバック、手法に関する実装のベスト プラクティスが備わっています。
MCP サーバーやウェブ検索ではなく、CLI スキルを使用する理由
- MCP ツールは、トークンを浪費するか、トリガー メカニズムの信頼性が低い(動的なツール検出が原因)。スキルの説明は、効果を最大化するために最小限に抑えられており、エージェントは適切な場合にのみガイダンスを使用できます。
- 組み込みのウェブ検索では、最新のキュレートされた
DO/DO NOT実装パターンではなく、2015 年の Stack Overflow の回答とリファレンス ドキュメントが表示されます。また、ネットワーク経由で数秒かかり、オフラインのサンドボックスでは失敗します。一方、ローカル CLI は CPU でミリ秒単位で実行されます。
第 1 世代: 507 MB の C++ プロトタイプ
Modern Web Guidance の最初のバージョンでは、LanceDB、Apache Arrow、Transformers.js と onnxruntime-native というローカル RAG スタックが使用されていました。
開発マシンでは問題なく動作しましたが、エージェント スキルとしては不十分でした。
- プロジェクトにスキルを追加する(またはエージェントが
npxでスキルを呼び出す)場合、npm installがアーキテクチャに依存する.nodeバイナリをダウンロードしたり、クラウド サンドボックスで日常的に失敗するnode-gypC++ コンパイルを待つ必要はありません。 - 抽出された
node_modulesディレクトリのサイズは 507 MB でした。
第 2 世代: TensorFlow.js を 23 MB に縮小
ネイティブ コンパイルをゼロにし、Node が実行される場所であればどこでも即座に実行できるようにしたいと考えました。そこで 4 月に、ネイティブ スタックを置き換え、@tensorflow/tfjs で all-MiniLM-L6-v2 を実行する純粋な JavaScript CPU エンジンを導入しました。
- esbuild で
onnxruntime-nodeをシムアウトし、Hugging Face トークナイザーを小さなツリー内 BERT WordPiece トークナイザーに置き換えました(トークン ID の不一致は 0)。 - ソースマップをいくつか調べた後、
@tensorflow/tfjs-backend-cpuの 400 以上のモジュールを、MiniLM が実際に使用する 26 個のカーネルに削減し、JS エンジンを 6 MB から 830 KB に縮小しました。 - LanceDB を削除し、ビルド時に gzip 圧縮されたベクトルと、200 ほどのすべてのガイドにわたるインメモリ
<1 msドット積スキャンを採用しました。 - エンベッダーを
import()呼び出しの背後に配置して、retrieveとlistが 10 ミリ秒未満で完了するようにします。
これにより、npm パッケージは 23 MB に縮小され、ランタイムの依存関係がなくなりました。このツールをリリースしたところ、エージェントは約 75 万回の検索を実行しました。
MiniLM が本番環境で破損した場所
数か月後、エージェントにスキルがインストールされているにもかかわらず、レガシーコードが記述されている軌跡を調べました。
ある Codex の実行で、開発者が削除確認プロンプトを要求しました。HTML <dialog closedby="any"> を使用してアクセス可能な確認モーダルを構築する方法については、こちらのガイドをご覧ください。
エージェントは適切な対応を行い、以下を検索しました。
npx modern-web-guidance@latest search "confirm destructive action"
CLI から [] が返されました。そのため、エージェントは window.confirm() と記述しました。
空の結果が返されたのはなぜでしょうか。ログとエンベディングを詳しく調べたところ、次の 2 つの検索ギャップが浮き彫りになりました。
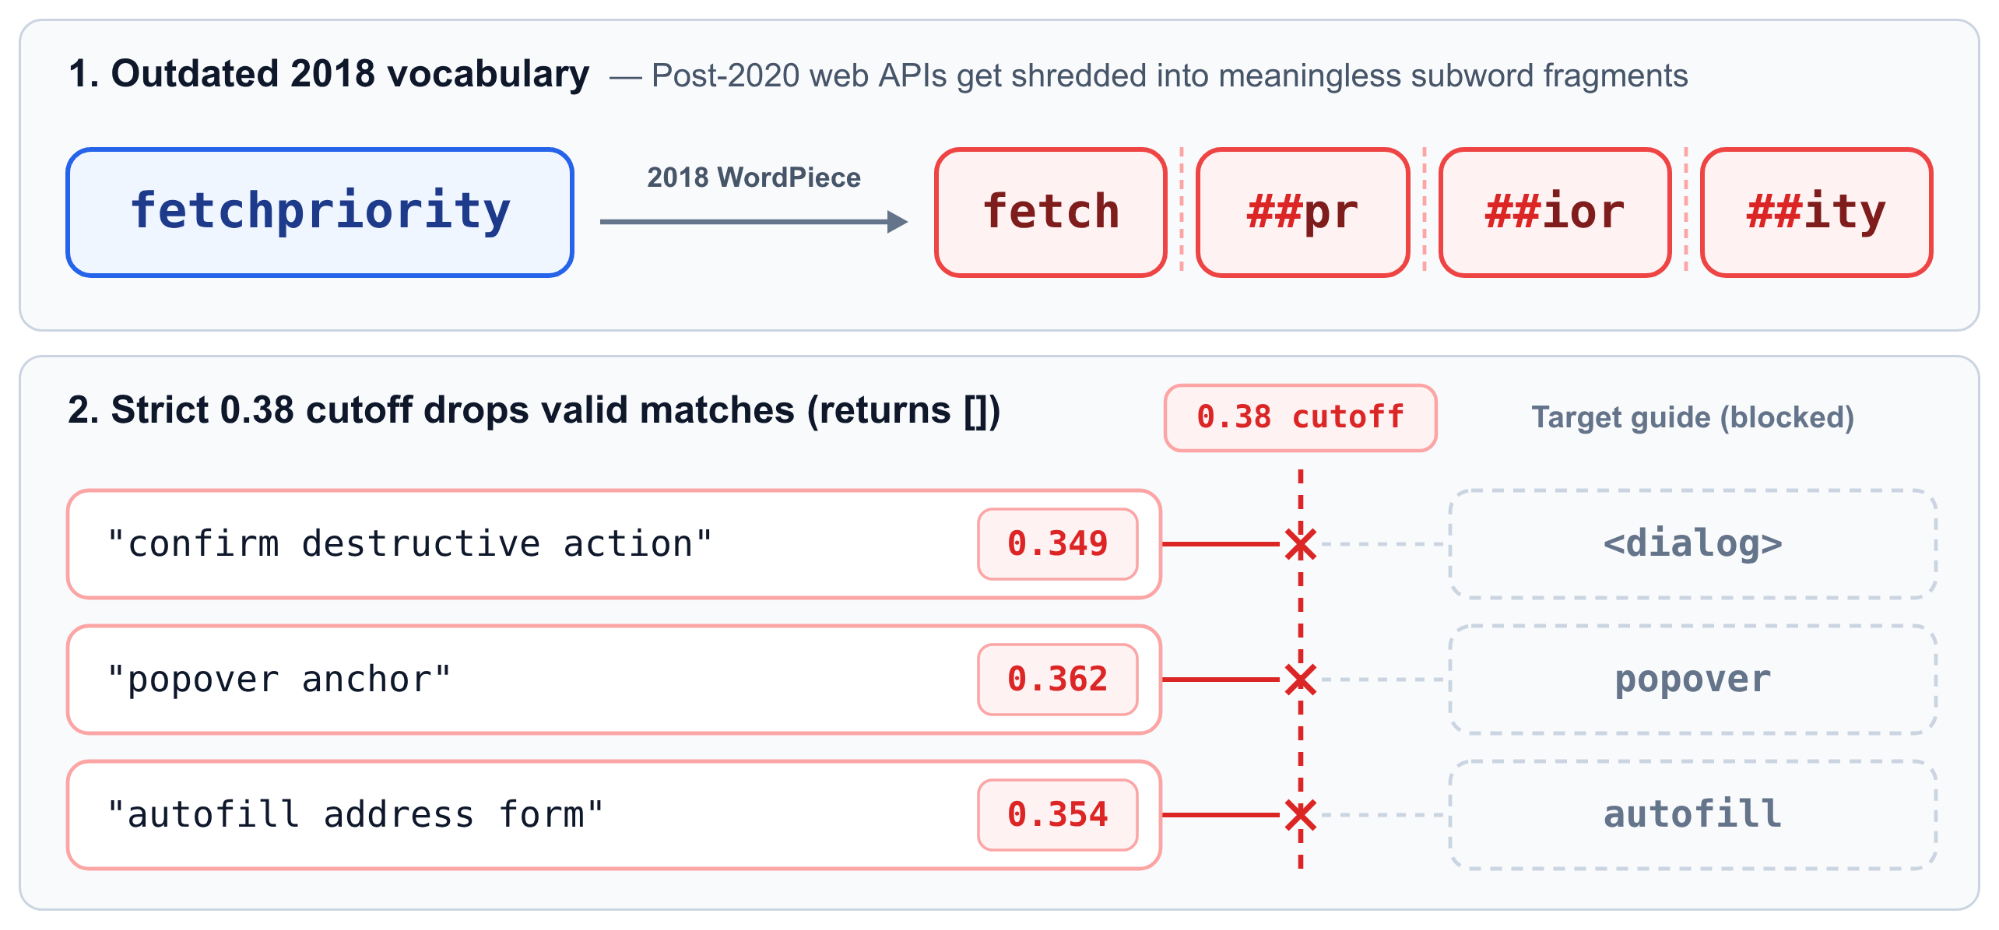
all-MiniLM-L6-v2は 2018 ~ 2020 年頃にトレーニングされたため、その WordPiece 語彙は、2020 年以降のウェブ API が存在することを文字どおり認識していません。fetchpriority、popover、startViewTransitionを検索すると、2018 年のトークナイザーはfetchpriorityをfetch、##pr、##ior、##ityという 4 つの無意味なサブワードに分割します。- 範囲外のクエリがランダムなガイドを返さないように、以前の PR では厳格な
0.38コサイン類似度のカットオフが追加されていました。MiniLM は 3 語のフレーズ"confirm destructive action"を0.38を超える"dialog"にブリッジできなかったため(スコアは0.349、"popover anchor"は0.362、"autofill address form"は0.354)、ゲートは有効な一致を破棄しました。さらに悪いことに、searchが[]を返すたびに、スキル指示によりエージェントはmodern-web-guidance listにフォールバックし、約 200 件のガイドの説明(約 1,500 トークンの無駄)をすべてコンテキストにダンプしていました。
情報取得の修正: 実際のテレメトリー、ハイブリッド検索、10 件の結果の返却
元のベンチマークは、ガイド自体から生成された 850 件の合成クエリでした。これはガイドの表現に近すぎて、これらの失敗を検出できませんでした。そこで、オプトアウトされた CLI テレメトリ(エージェントの 2 ~ 5 語の search 引数のみをログに記録し、ユーザー プロンプトやリポジトリ コードは記録せず、DISABLE_TELEMETRY=1 を尊重)からサンプリングされた約 4,000 件のライブ検索と、Claude Code、Codex CLI、Gemini CLI の夜間のエージェント評価から抽出された 1,029 件の検索を中心に、新しい評価ハーネス(pnpm benchmark:rag)を構築しました。
これらのホールドアウト クエリに対して git 履歴を再生したところ、0.38 のカットオフにより、空の [] レスポンスが 8 倍に急増したことがわかりました。ベンチマークを確立したことで、エンベディング モデルに手を加える前に、2 つの迅速な改善を実現できました。
- ハイブリッド キーワード + セマンティック検索: 密ベクトルでは正確な API 名(
:user-invalid、showModal、details-name)が曖昧になります。一方、キーワード検索では、エージェントが API 名を認識していない場合、インテント クエリが検出されません。ゼロ依存関係の BM25(ご存じの方もいらっしゃるかと思います)キーワード インデックスを複数形の語幹処理とともに導入し、各ガイドのweb-feature-idsをインデックスに登録して、BM25 とセマンティック ランキングを融合させました。searchは、セマンティック類似性が<0.30で、かつ BM25 のキーワード ヒット数がゼロの場合にのみ[]を返すようになりました。 - 詳細な結果 5 件ではなく、簡潔な結果 10 件: スキル指示により、エージェントは
similarityとtokenCountを無視するように指示されています。未使用のフィールドを削除することで、10 個のコンパクトな{id, description}の結果を、5 個の詳細な結果と同じ約 530 トークンの予算に収めることができます。
// Before: 5 verbose results (~105 tokens each = ~525 tokens)
{
  "id": "dialog",
  "category": "html",
  "description": "Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby.",
  "featuresUsed": ["dialog", "dialog-closedby"],
  "tokenCount": 780,
  "similarity": 0.49
}
// After: 10 compact results (~53 tokens each = ~530 tokens)
{"id":"dialog","description":"Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby."}
これら 2 つの変更を組み合わせることで、ホールドアウトされたテレメトリー クエリの検索ヒット率は 80.6% から 94.7% に向上しました。これは Hit@K(想定されるガイドが上位 K 件の結果に表示されるかどうか)として測定されます。
第 3 世代: 事前作成されたエンベディングと 7 行の for ループ
94.7% のヒット率でも、テレメトリーでは、ライブ エージェントの検索の 86.7% が 2 ~ 5 語(中央値: 3 語)という、明らかな不一致が示されました。エージェントが 3 語のフレーズを検索するたびに、Node は TensorFlow.js を起動し、22.6 MB のニューラル ネットワークを解析して、770 ミリ秒のコールド スタート レイテンシと 346 MB のピーク RAM を消費していました。
ニューラル ネットワークを使用せずに 3 語のクエリを埋め込む、より軽量な方法があるかどうかを尋ねたところ、Antigravity エージェントは、Model2Vec、Tokenlearn、Matryoshka ディメンション、Adagrad など、あまり知られていない ML 蒸留技術を提案しました。(詳細については、検索品質のページをご覧ください)。
標準的なローカル RAG では、ドキュメントとクエリの両方がユーザーの CPU 上の同じ小さなモデルを通過します。しかし、npm リリースをカットしても、約 200 のガイドは変更されないため、小さな 2018 モデルに埋め込む理由はありません。代わりに、gemini-embedding-001 を使用して、リリース時にクラウドですべてのガイドベクトルを事前にベイクし、バイナリの 256 次元 Int8 ベクトル(guide-chunks.i8、335 KB gzip 圧縮)として出荷します。embed-guide-chunks.ts
オフラインで API キーを使用しない CLI が、ユーザーのライブクエリをまったく同じ Gemini ベクトル空間に投影するにはどうすればよいでしょうか。エージェントのクエリはほぼ常に 2 ~ 5 語であるため、実行時にトランスフォーマーは必要ありません。必要なのは、既知の単語(table)のベクトルのルックアップ テーブルと、それらを合計するスマートな方法だけです。実行時に、23 MB の TensorFlow.js パイプライン全体が static-embedder.ts の 7 行の for ループに縮小されます。
// Each word's weight and Int8 scale are pre-folded into `scales[i]`
for (const [i, f] of enc) {
  const wt = scales[i] * f;
  const offset = i * 256;
  for (let k = 0; k < 256; k++) {
    out[k] += wt * table[offset + k];
  }
}
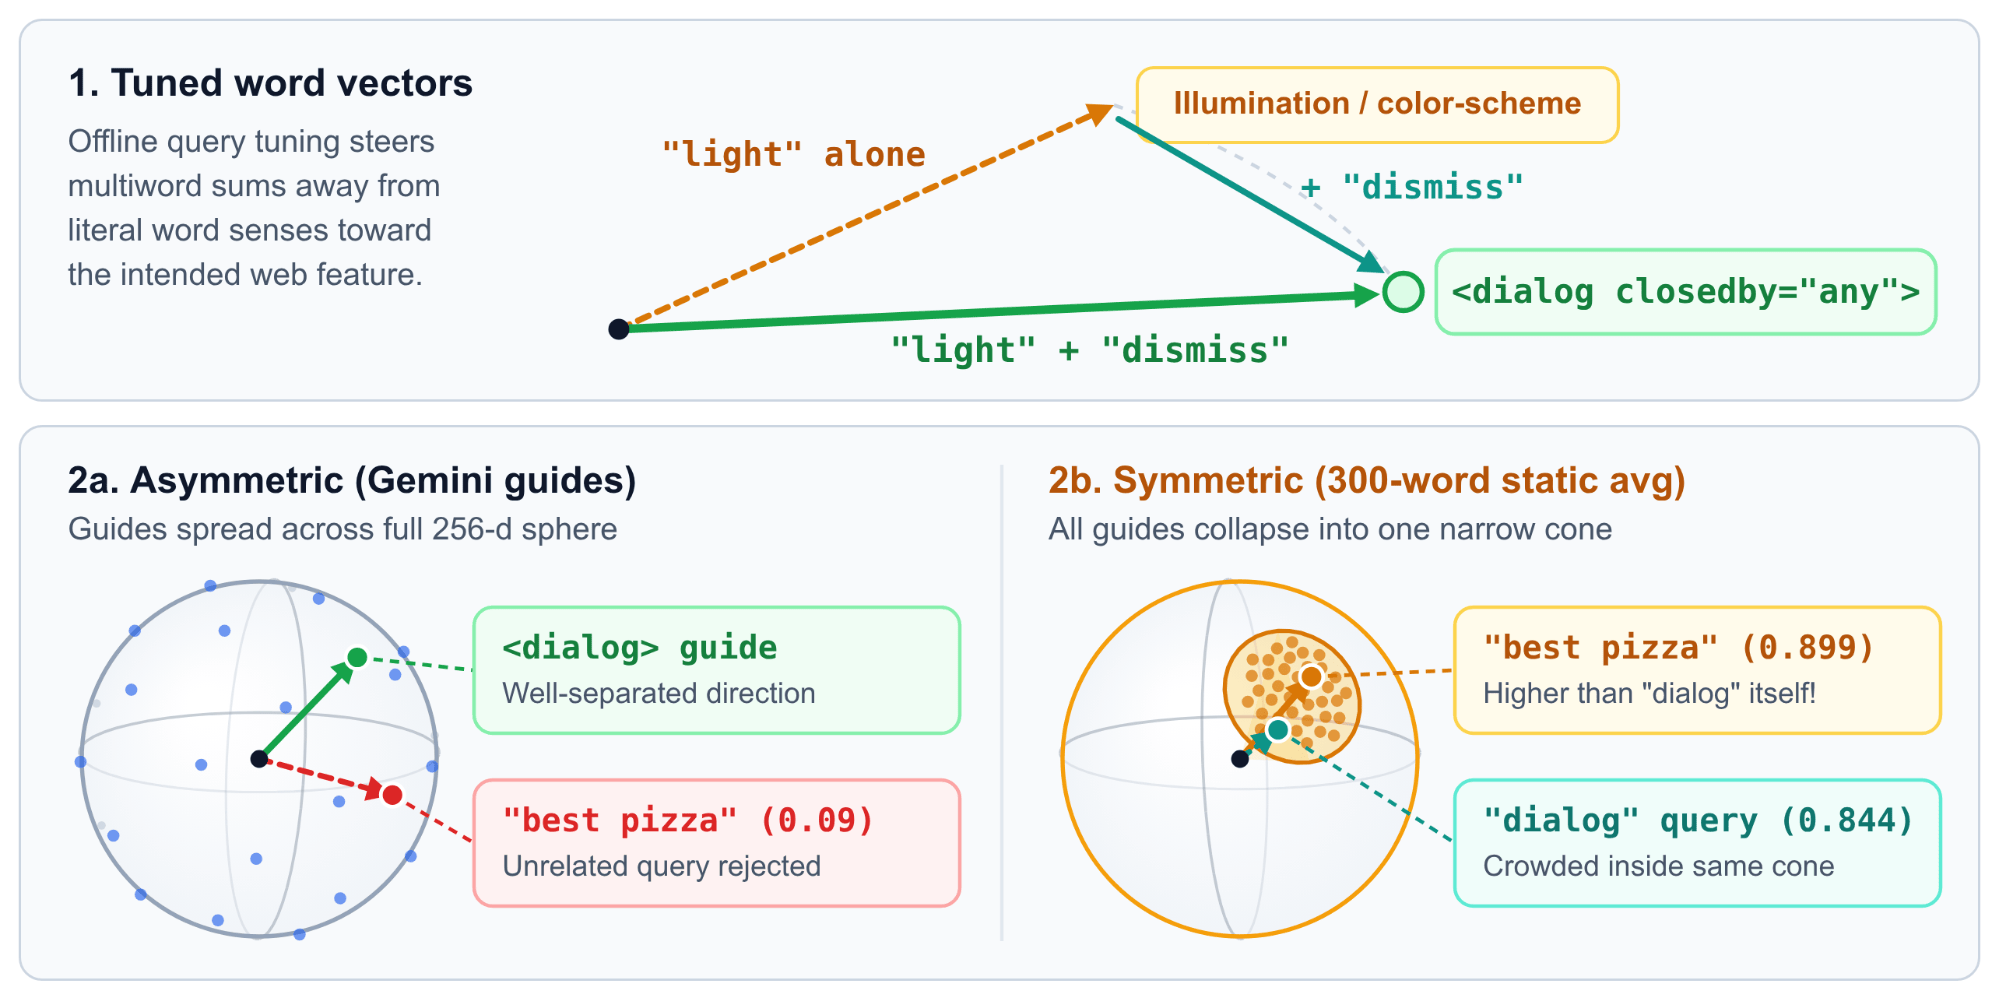
このルックアップ テーブル(train-query-words.ts)を構築するために、29,165 語の語彙(fetchpriority、light-dismiss、popover、scrollytelling などの最新のウェブ用語が独立した単語として含まれる)を取得し、gemini-embedding-001 でエンベディングしました。さらに、33,000 件の実際のウェブクエリに対して単語ベクトルをオフラインでチューニングし、複数の単語の組み合わせが適切な位置に配置されるようにしました(たとえば、"light" + "dismiss" は、照明やカラーパターンではなく、<dialog closedby="any"> を指します)。Int8(query-words.i8)に圧縮され、ルックアップ テーブル全体が 5.3 MB gzip 圧縮されます。
その静的ルックアップ テーブルを使用してガイドを埋め込み、Cloud Build のステップをスキップしないのはなぜでしょうか。最初に試したところ、段落全体でうまくいきませんでした。3 つのクエリ単語の合計はシャープなままですが、ガイド全体で数百の単語を平均すると、すべてのガイドが一般的な英語の平均に近い狭いコーンに収束してしまいます("best pizza in new york" が dialog ガイドに対して 0.899 のコサイン類似度をスコアし、クエリ "dialog" 自体の 0.844 よりも高くなるほどです)。3 単語の静的クエリ検索(query-words.i8)とフルモデルの Gemini ガイド エンベディング(guide-chunks.i8)を組み合わせることで、クラウドグレードの精度を実現しながら、クエリは 30 µs でオフラインで実行されます。
3 世代にわたるスコアボード
リリース マイルストーン全体で、Hit@K はドキュメント全体のエンベディングを使用した 78.2% から、静的 Int8 エンベッダーを使用した 95.4% に上昇しました(クラウド gemini-embedding-001 API を使用した 96.9% と比較)。
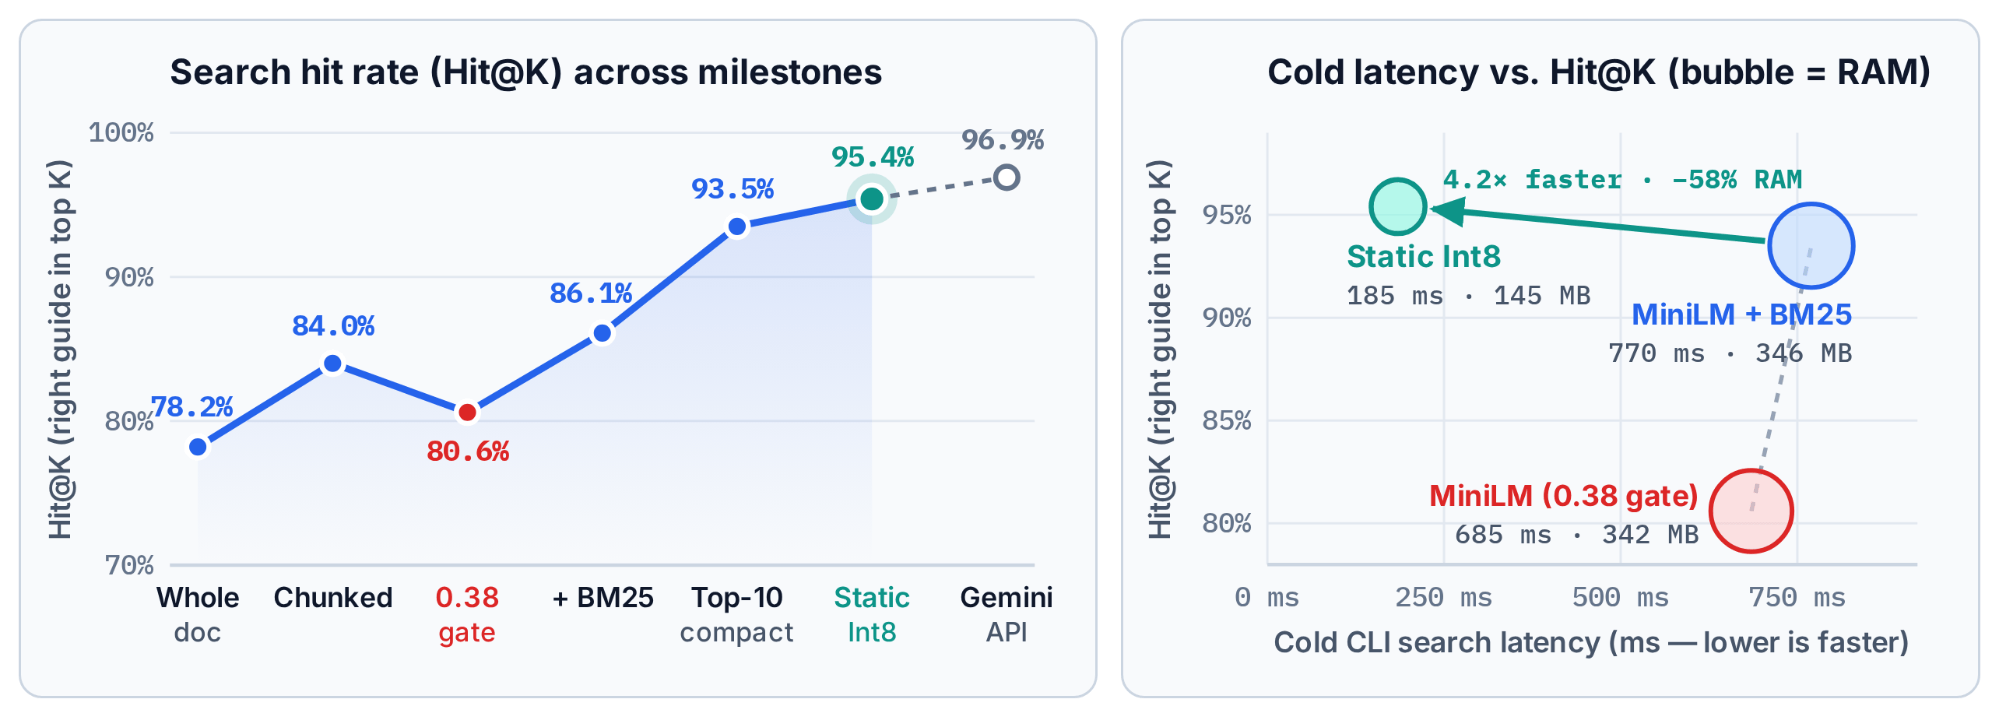
静的エンベッダーを導入した後の 3 世代の比較は次のとおりです。
先ほどの、エラーが発生した Codex クエリを実行すると、
npx modern-web-guidance@latest search "confirm destructive action"
dialog ガイドがリストの一番上に戻ります。
(すべてのマイルストーン、クエリの長さ、K ホライズンにわたるインタラクティブなグラフは、検索品質ダッシュボードで確認できます。)
コードは安価。測定が作業
エージェントは、BM25 ランカーや単語ベクトル抽出スクリプトを数分で作成できます。候補となる実装の生成は、もはやボトルネックではありません。変更が実際に役立ったかどうか(または、0.38 ゲートのように、本番環境の検索の 9% がひっそりと壊れたかどうか)を知ることが、ほぼすべての作業です。
このシステムへのアプローチは次のとおりです。
- 最重要目標を定義し、単一の実装ではなく測定ハーネスに投資します。リトリーバーの作成よりも、
pnpm benchmark:ragの構築、5,000 件の実際のクエリのキュレーション、人間の評価に対する自動評価の調整に、はるかに多くの時間を費やしました。 - あなたとエージェントが品質を判断するためのルーブリックを作成し、実際のデータに触れることで進化することを期待します。これは「測定ファースト」と呼ばれますが、これは半分しか正しくありません。初日に基本的な既知の回答チェックを作成することはできますが、実際の失敗を検査する前に、何もない状態で適切なルーブリックを設計することはできません(Shankar らは、Who Validates the Validators? でこれを「基準のドリフト」と呼んでいます)。エージェントが 1,500 トークンの
listフォールバックをトリガーするのを見て、トークンの肥大化を再現率とともにペナルティの対象にせざるを得ませんでした。 - 信頼できる測定を導入したら、さまざまな実装を積極的に試し、スコアボードでアーキテクチャの議論を解決します。ベンチマークが 5,000 件のクエリを数秒で評価できるようになれば、7 行の
Int8ループが 23 MB のトランスフォーマーに勝てるかどうかを PR で議論する必要はなくなります。午後に 5 つのアプローチを試し、最も効果的なものを採用します。
もちろん、すべてのコード(エンベッダー、ディスティラー、ベンチマーク ハーネスを含む)はオープンソースです。