


게시일: 2026년 1월 30일
Performance를 위한 AI 지원을 빌드할 때 주요 엔지니어링 과제는 Gemini가 DevTools에 기록된 성능 트레이스와 원활하게 작동하도록 하는 것이었습니다.
대규모 언어 모델(LLM)은 한 번에 처리할 수 있는 정보량에 대한 엄격한 제한을 의미하는 '컨텍스트 윈도우' 내에서 작동합니다. 이 용량은 토큰으로 측정됩니다. Gemini 모델의 경우 토큰 1개는 약 4자(영문 기준)입니다.
성능 트레이스는 대용량 JSON 파일로, 보통 수 메가바이트로 구성됩니다. 원시 trace를 전송하면 모델의 컨텍스트 윈도우가 즉시 소진되어 질문을 위한 공간이 남지 않습니다.
실적을 위한 AI 지원을 가능하게 하려면 최소한의 토큰 사용으로 LLM에 유용한 데이터의 양을 극대화하는 시스템을 설계해야 했습니다. 이 블로그에서는 이를 위해 사용한 기술을 알아보고 자체 프로젝트에 적용할 수 있습니다.
초기 컨텍스트 맞춤설정
웹사이트 성능 디버깅은 복잡한 작업입니다. 개발자는 컨텍스트의 전체 trace를 살펴보거나 Core Web Vitals 및 trace의 관련 기간에 집중하거나 세부정보를 살펴보고 클릭이나 스크롤과 같은 개별 이벤트 및 관련 호출 스택에 집중할 수 있습니다.
디버깅 프로세스를 지원하려면 DevTools의 AI 지원이 개발자 여정과 일치해야 하며 개발자 포커스에 맞는 조언을 제공하기 위해 관련 데이터만 사용해야 합니다. 따라서 항상 전체 trace를 전송하는 대신 디버깅 작업에 따라 데이터를 분할하는 AI 지원을 빌드했습니다.
| 디버깅 작업 | AI 지원에 처음 전송된 데이터 |
|---|---|
| 성능 트레이스에 관해 채팅하기 | Trace 요약: trace 및 디버깅 세션의 대략적인 정보가 포함된 텍스트 기반 보고서입니다. 페이지 URL, 제한 조건, 주요 실적 측정항목(LCP, INP, CLS), 사용 가능한 인사이트 목록, CrUX 요약(제공되는 경우)이 포함됩니다. |
| 실적 통계에 관해 채팅하기 | trace 요약 및 선택한 성능 통계의 이름 |
| trace의 작업에 관해 채팅하기 | 트레이스 요약 및 선택한 태스크가 있는 직렬화된 호출 트리 |
| 네트워크 요청에 관해 채팅하기 | trace 요약, 선택한 요청 키 및 타임스탬프 |
| trace 주석 생성 | 선택한 태스크가 있는 직렬화된 호출 트리입니다. 직렬화된 트리는 선택된 작업을 식별합니다. |
추적 요약은 AI 지원의 기본 모델인 Gemini에 초기 컨텍스트를 제공하기 위해 거의 항상 전송됩니다. AI 생성 주석의 경우 생략됩니다.
AI에 도구 제공
DevTools의 AI 어시스턴스는 에이전트 역할을 합니다. 즉, 개발자의 초기 프롬프트와 공유된 초기 컨텍스트를 기반으로 더 많은 데이터를 자율적으로 쿼리할 수 있습니다. 더 많은 데이터를 쿼리하기 위해 AI 지원에 호출할 수 있는 사전 정의된 함수 집합을 제공했습니다. 함수 호출 또는 도구 사용이라고 하는 패턴입니다.
앞서 설명한 디버깅 여정을 기반으로 에이전트의 세분화된 함수 집합을 정의했습니다. 이러한 함수는 초기 컨텍스트를 기반으로 중요하다고 간주되는 세부정보를 자세히 살펴봅니다. 이는 인간 개발자가 성능 디버깅에 접근하는 방식과 유사합니다. 함수 집합은 다음과 같습니다.
| 함수 | 설명 |
|---|---|
getInsightDetails(name) |
특정 성능 통계에 관한 세부정보를 반환합니다(예: LCP에 플래그가 지정된 이유에 관한 세부정보). |
getEventByKey(key) |
특정 이벤트 하나의 세부 속성을 반환합니다. |
getMainThreadTrackSummary(start, end) |
하향식, 상향식, 서드 파티 요약을 포함하여 지정된 경계의 기본 스레드 활동 요약을 반환합니다. |
getNetworkTrackSummary(start, end) |
지정된 시간 범위의 네트워크 활동 요약을 반환합니다. |
getDetailedCallTree(event_key) |
성능 트레이스에서 특정 기본 스레드 이벤트의 전체 호출 트리를 반환합니다. |
getFunctionCode(url, line, col) |
리소스의 특정 위치에 정의된 함수의 소스 코드를 반환하며, 성능 trace의 런타임 성능 데이터로 주석이 추가됩니다. |
getResourceContent(url) |
페이지에서 사용하는 텍스트 리소스(예: HTML 또는 CSS)의 콘텐츠를 반환합니다. |
데이터 검색을 이러한 함수 호출로 엄격하게 제한함으로써 관련 정보만 잘 정의된 형식으로 컨텍스트 윈도우에 입력되도록 하여 토큰 사용량을 최적화합니다.
에이전트 작업 예시
AI 지원이 함수 호출을 사용하여 더 많은 정보를 검색하는 방법에 대한 실제 예시를 살펴보겠습니다. "이 요청이 느린 이유는 무엇인가요?"라는 초기 프롬프트 이후 AI 지원은 다음 함수를 점진적으로 호출할 수 있습니다.
getEventByKey: 사용자가 선택한 특정 요청의 자세한 타이밍 분석(TTFB, 다운로드 시간)을 가져옵니다.getMainThreadTrackSummary: 요청이 시작되어야 할 때 기본 스레드가 사용 중(차단됨)이었는지 확인합니다.getNetworkTrackSummary: 다른 리소스가 동시에 대역폭을 두고 경쟁하고 있는지 분석합니다.getInsightDetails: Trace 요약에 이 요청과 관련된 통계가 병목 현상으로 이미 언급되어 있는지 확인합니다.
이러한 호출 결과를 결합하여 AI 지원은 진단을 제공하고 getFunctionCode를 사용하여 코드 개선을 제안하거나 getResourceContent를 기반으로 리소스 로드를 최적화하는 등의 실행 가능한 단계를 제안할 수 있습니다.
하지만 관련 데이터를 검색하는 것은 절반의 과제에 불과합니다. 세분화된 데이터를 제공하는 함수를 사용하더라도 이러한 함수에서 반환되는 데이터의 크기가 클 수 있습니다. 또 다른 예로 getDetailedCallTree는 수백 개의 노드가 있는 트리를 반환할 수 있습니다. 표준 JSON에서는 중첩을 위해 많은 { 및 }가 필요합니다.
따라서 토큰 효율성이 높을 만큼 밀도가 높으면서도 LLM이 이해하고 참조할 수 있을 만큼 구조화된 형식이 필요합니다.
데이터 직렬화
호출 트리는 성능 트레이스에서 데이터의 대부분을 차지하므로 호출 트리 예시를 계속 사용하여 이 문제에 어떻게 접근했는지 자세히 살펴보겠습니다. 참고로 다음 예시에서는 JSON의 호출 스택에 있는 단일 태스크를 보여줍니다.
{
  "id": 2,
  "name": "animate",
  "selected": true,
  "duration": 150,
  "selfTime": 20,
  "children": [3, 5, 6, 7, 10, 11, 12]
}
다음 스크린샷과 같이 하나의 성능 트레이스에 수천 개의 트레이스가 포함될 수 있습니다. 모든 작은 색상 상자는 이 객체 구조를 사용하여 표현됩니다.
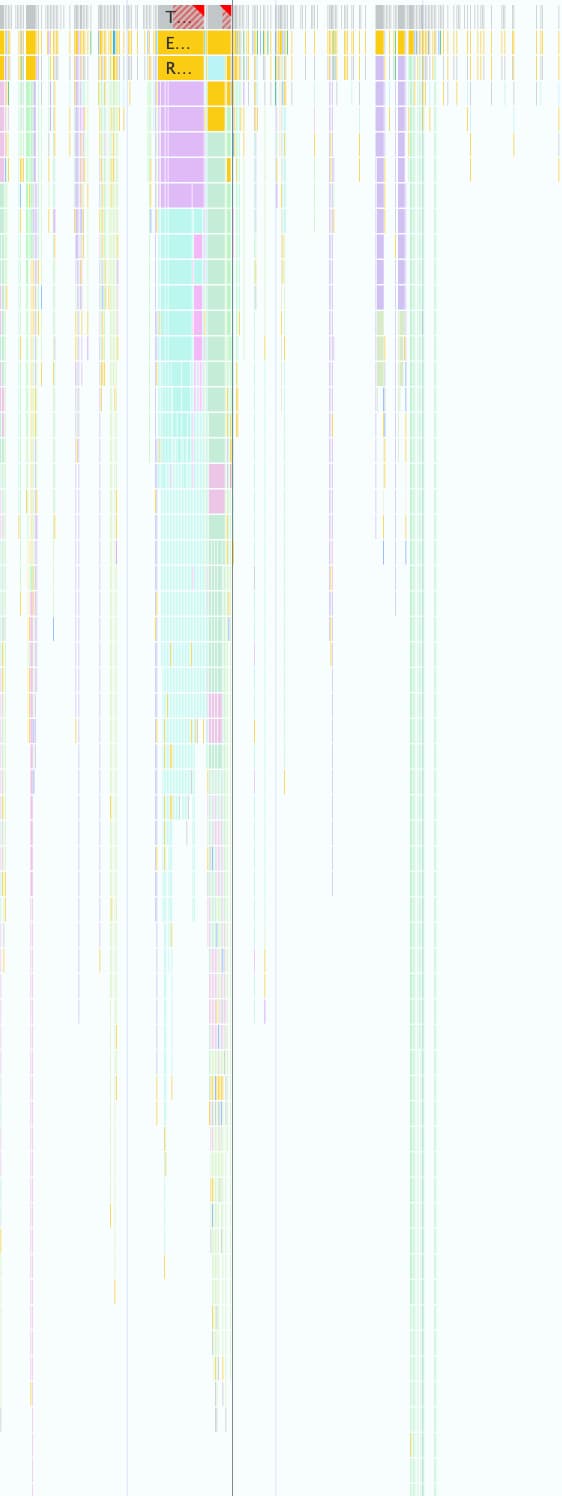
이 형식은 DevTools에서 프로그래매틱 방식으로 작업하는 데 적합하지만 다음과 같은 이유로 LLM에는 비효율적입니다.
- 중복 키:
"duration","selfTime","children"와 같은 문자열이 호출 트리의 모든 단일 노드에 반복됩니다. 따라서 500개의 노드가 있는 트리를 모델에 전송하면 각 키에 대해 500번 토큰이 소비됩니다. - 상세 목록:
children를 통해 모든 하위 ID를 개별적으로 나열하면 특히 많은 다운스트림 이벤트를 트리거하는 작업의 경우 엄청난 수의 토큰이 사용됩니다.
실적을 위한 AI 지원에 사용되는 모든 데이터에 토큰 효율적인 형식을 구현하는 것은 단계별 프로세스였습니다.
첫 번째 반복
Performance의 AI 지원 작업을 시작할 때 Google은 배송 속도를 최적화했습니다. 토큰 최적화에 대한 Google의 접근 방식은 기본적이었으며 중괄호와 쉼표에서 원본 JSON을 삭제하여 다음과 같은 형식이 되었습니다.
allUrls = [...]

Node: 1 - update
Selected: false
Duration: 200
Self Time: 50
Children:
   2 - animate

Node: 2 - animate
Selected: true
Duration: 150
Self Time: 20
URL: 0
Children:
   3 - calculatePosition
   5 - applyStyles
   6 - applyStyles
   7 - calculateLayout
   10 - applyStyles
   11 - applyStyles
   12 - applyStyles

Node: 3 - calculatePosition
Selected: false
Duration: 15
Self Time: 2
URL: 0
Children:
   4 - getBoundingClientRect

...
하지만 이 첫 번째 버전은 원시 JSON에 비해 약간 개선된 수준에 불과했습니다. 여전히 ID와 이름이 있는 하위 노드를 명시적으로 나열하고 각 줄 앞에 설명이 포함된 반복 키(Node:, Selected:, Duration:, …)를 추가했습니다.
하위 노드 목록 최적화
추가 최적화를 위한 다음 단계로 노드 하위 요소의 이름(이전 예시의 calculatePosition, applyStyles, …)을 삭제했습니다. AI 어시스턴트는 함수 호출을 통해 모든 노드에 액세스할 수 있고 이 정보는 이미 노드 헤드(Node: 3 - calculatePosition)에 있으므로 이 정보를 반복할 필요가 없습니다. 이렇게 하면 Children를 간단한 정수 목록으로 축소할 수 있습니다.
Node: 2 - animate
Selected: true
Duration: 150
Self Time: 20
URL: 0
Children: 3, 5, 6, 7, 10, 11, 12

..
이전보다 크게 개선되었지만 여전히 최적화할 여지가 있었습니다. 이전 예시를 보면 Children는 거의 순차적이며 4, 8, 9만 누락된 것을 확인할 수 있습니다.
그 이유는 첫 번째 시도에서 깊이 우선 탐색(DFS) 알고리즘을 사용하여 성능 트레이스의 트리 데이터를 직렬화했기 때문입니다. 이로 인해 동위 노드의 ID가 순차적이지 않게 되어 모든 ID를 개별적으로 나열해야 했습니다.
너비 우선 검색(BFS)을 사용하여 트리를 다시 색인 생성하면 순차 ID를 얻을 수 있으므로 또 다른 최적화가 가능하다는 것을 알게 되었습니다. 이제 개별 ID를 나열하는 대신 원래 예시의 3-9와 같이 단일 압축 범위로 수백 개의 하위 요소를 나타낼 수 있습니다.
최적화된 Children 목록이 있는 최종 노드 표기법은 다음과 같습니다.
allUrls = [...]

Node: 2 - animate
Selected: true
Duration: 150
Self Time: 20
URL: 0
Children: 3-9
키 수 줄이기
노드 목록을 최적화한 후 중복 키로 이동했습니다. 먼저 이전 형식에서 모든 키를 삭제했습니다. 그 결과는 다음과 같습니다.
allUrls = [...]

2;animate;150;20;0;3-10
토큰 효율성이 높지만 이 데이터를 이해하는 방법에 대한 안내를 Gemini에 제공해야 했습니다. 따라서 Gemini에 호출 트리를 처음 보낼 때 다음 프롬프트를 포함했습니다.
...
Each call frame is presented in the following format:

'id;name;duration;selfTime;urlIndex;childRange;[S]'

Key definitions:

*   id: A unique numerical identifier for the call frame.
*   name: A concise string describing the call frame (e.g., 'Evaluate Script', 'render', 'fetchData').
*   duration: The total execution time of the call frame, including its children.
*   selfTime: The time spent directly within the call frame, excluding its children's execution.
*   urlIndex: Index referencing the "All URLs" list. Empty if no specific script URL is associated.
*   childRange: Specifies the direct children of this node using their IDs. If empty ('' or 'S' at the end), the node has no children. If a single number (e.g., '4'), the node has one child with that ID. If in the format 'firstId-lastId' (e.g., '4-5'), it indicates a consecutive range of child IDs from 'firstId' to 'lastId', inclusive.
*   S: **Optional marker.** The letter 'S' appears at the end of the line **only** for the single call frame selected by the user.

....
이 형식 설명에는 토큰 비용이 발생하지만 전체 대화에 대해 한 번만 지불하는 정적 비용입니다. 이 비용은 이전 최적화를 통해 얻은 절감액보다 적습니다.
결론
토큰 사용량 최적화는 AI를 사용하여 빌드할 때 중요한 고려사항입니다. 원시 JSON에서 특수한 맞춤 형식으로 전환하고, 너비 우선 탐색을 사용하여 트리를 다시 색인 생성하고, 도구 호출을 사용하여 필요에 따라 데이터를 가져옴으로써 Chrome DevTools의 AI 어시스턴스가 소비하는 토큰의 양을 크게 줄였습니다.
이러한 최적화는 성능 트레이스에 AI 지원을 사용 설정하기 위한 전제 조건이었습니다. 그렇지 않으면 제한된 컨텍스트 윈도우로 인해 방대한 양의 데이터를 처리할 수 없습니다. 하지만 최적화된 형식을 사용하면 더 긴 대화 기록을 유지하고 노이즈에 압도되지 않고 더 정확하고 상황에 맞는 답변을 제공할 수 있는 성능 에이전트를 사용할 수 있습니다.
이러한 기법이 AI를 설계할 때 자체 데이터 구조를 다시 살펴보는 데 도움이 되기를 바랍니다. 웹 애플리케이션에서 AI를 시작하려면 web.dev에서 AI 알아보기를 참고하세요.