


게시일: 2026년 11월 12일
이번 주에 Google은 코딩 에이전트가 기존의 임시방편 대신 최신 웹 플랫폼 기능을 사용할 수 있도록 지원하는 오픈소스 기능인 Modern Web Guidance 1.0을 출시했습니다. 이 게시물에서는 토큰을 낭비하지 않고 작업에 가장 관련성 높은 가이드를 찾는 로컬 검색엔진을 살펴봅니다.
엔지니어에게 코딩 에이전트를 위해 1.7MB의 마크다운 텍스트로 기술 자료를 빌드했다고 말하면 엔지니어는 두 가지 질문을 할 것입니다.
- "이 작업으로 컨텍스트 윈도우에 얼마나 많은 토큰이 추가될까?"
- "어떤 종류의 비대한 벡터 데이터베이스가 필요한가요?"
지난 6개월 동안 로컬 검색 엔진을 세 번이나 다시 구축했습니다. C++ 바인딩 507MB에서 TensorFlow.js를 사용하는 순수 JavaScript 23MB로 줄인 다음, 쿼리 임베딩이 7줄의 for 루프인 7MB 패키지로 줄였습니다. 이 모든 과정에서 정확성은 개선되었습니다.
에이전트형 RAG 및 단계적 공개
200개가 넘는 HTML/CSS/Web API 가이드가 포함된 1.7MB의 마크다운 텍스트를 AGENTS.md에 덤프하는 것은 실용적이지 않습니다. Google은 점진적 공개를 지향하지만, 마크다운 색인은 대규모 환경에서 토큰 효율성이 떨어진다는 점을 알고 있습니다.
이 문제를 해결하기 위해 검색 CLI를 기반으로 하는 에이전트형 RAG를 사용합니다.
- 에이전트는 사용 중이 아닐 때 스킬 설명(약 205개 토큰)만 확인합니다. 설명은 에이전트가 관련 프런트엔드 작업에서 기술을 호출하도록 Anthropic의 기술 트리거 가이드라인을 따릅니다.
- 프런트엔드 작업에서 에이전트는 CLI를 사용하여 검색할 수 있습니다(
modern-web-guidance search "animate height auto"). 관련 일치 항목 10개(토큰 약 530개)가 반환됩니다. - 에이전트는
modern-web-guidance retrieve animate-to-intrinsic-sizes를 실행하여 전체 가이드(약 800개 토큰)를 가져옵니다. 이제 호환성, 대체, 기법에 관한 구현 권장사항이 포함되어 있습니다.
MCP 서버나 웹 검색 대신 CLI 스킬을 사용하는 이유는 무엇인가요?
- MCP 도구는 토큰을 낭비하거나 트리거 메커니즘이 불안정합니다(동적 도구 탐색으로 인해). 스킬 설명은 효과를 극대화하도록 최적화되어 있으며 에이전트가 적절한 경우에만 가이드를 사용할 수 있도록 합니다.
- 기본 제공 웹 검색은 최신 선별된
DO/DO NOT구현 패턴이 아닌 2015년 Stack Overflow 답변 및 참조 문서를 표시합니다. 또한 네트워크를 통해 실행하는 데 몇 초가 걸리고 오프라인 샌드박스에서는 실패하는 반면, 로컬 CLI는 CPU에서 밀리초 단위로 실행됩니다.
1세대: 507MB C++ 프로토타입
Modern Web Guidance의 첫 번째 버전은 LanceDB, Apache Arrow, Transformers.js와 onnxruntime-native를 사용하는 로컬 RAG 스택을 사용했습니다.
개발 머신에서는 잘 작동했지만 에이전트 기술에는 적합하지 않았습니다.
- 프로젝트에 기술을 추가하거나 에이전트가
npx로 기술을 호출할 때, 아키텍처에 종속된.node바이너리를 다운로드하는npm install또는 클라우드 샌드박스에서 일상적으로 실패하는node-gypC++ 컴파일을 기다릴 필요가 없습니다. - 추출된
node_modules디렉터리의 크기는 507MB입니다.
2세대: TensorFlow.js를 23MB로 축소
Node가 실행되는 모든 곳에서 네이티브 컴파일 없이 즉시 실행되기를 원했습니다. 이에 따라 4월에 네이티브 스택을 대체하여 @tensorflow/tfjs에서 all-MiniLM-L6-v2를 실행하는 순수 자바스크립트 CPU 엔진을 도입했습니다.
- esbuild에서
onnxruntime-node를 shimmed out하고 Hugging Face 토크나이저를 작은 인트리 BERT WordPiece 토크나이저로 대체했습니다(토큰 ID 불일치 0개). - 소스 맵을 살펴본 후
@tensorflow/tfjs-backend-cpu의 400개 이상의 모듈을 MiniLM이 실제로 사용하는 26개의 커널로 정리하여 JS 엔진을 6MB에서 830KB로 축소했습니다. - 빌드 시간 gzip 벡터 및 약 200개의 모든 가이드에 대한 인메모리
<1 ms내적 스캔을 위해 LanceDB를 삭제했습니다. retrieve및list가 10밀리초 이내에 완료되도록 임베더를import()호출 뒤에 배치합니다.
이렇게 하면 런타임 종속 항목 없이 npm 패키지를 23MB로 줄일 수 있습니다. 이 기능을 출시한 후 상담사들은 약 750,000건의 검색을 실행했습니다.
프로덕션에서 MiniLM가 중단된 위치
몇 달 후, 에이전트에 이 기능이 설치되어 있음에도 불구하고 여전히 기존 코드를 작성하는 사례를 살펴보았습니다.
한 Codex 실행에서 개발자가 삭제 확인 메시지를 요청했습니다. HTML <dialog closedby="any">를 사용하여 접근성 높은 확인 모달을 빌드하는 방법에 관한 전체 가이드가 있습니다.
에이전트는 올바른 조치를 취하고 다음을 검색했습니다.
npx modern-web-guidance@latest search "confirm destructive action"
CLI에서 []을(를) 반환했습니다. 그래서 상담사는 어깨를 으쓱하며 window.confirm()라고 작성했습니다.
빈 결과가 반환된 이유는 무엇인가요? 로그와 임베딩을 자세히 살펴보니 두 가지 검색 격차가 눈에 띄었습니다.
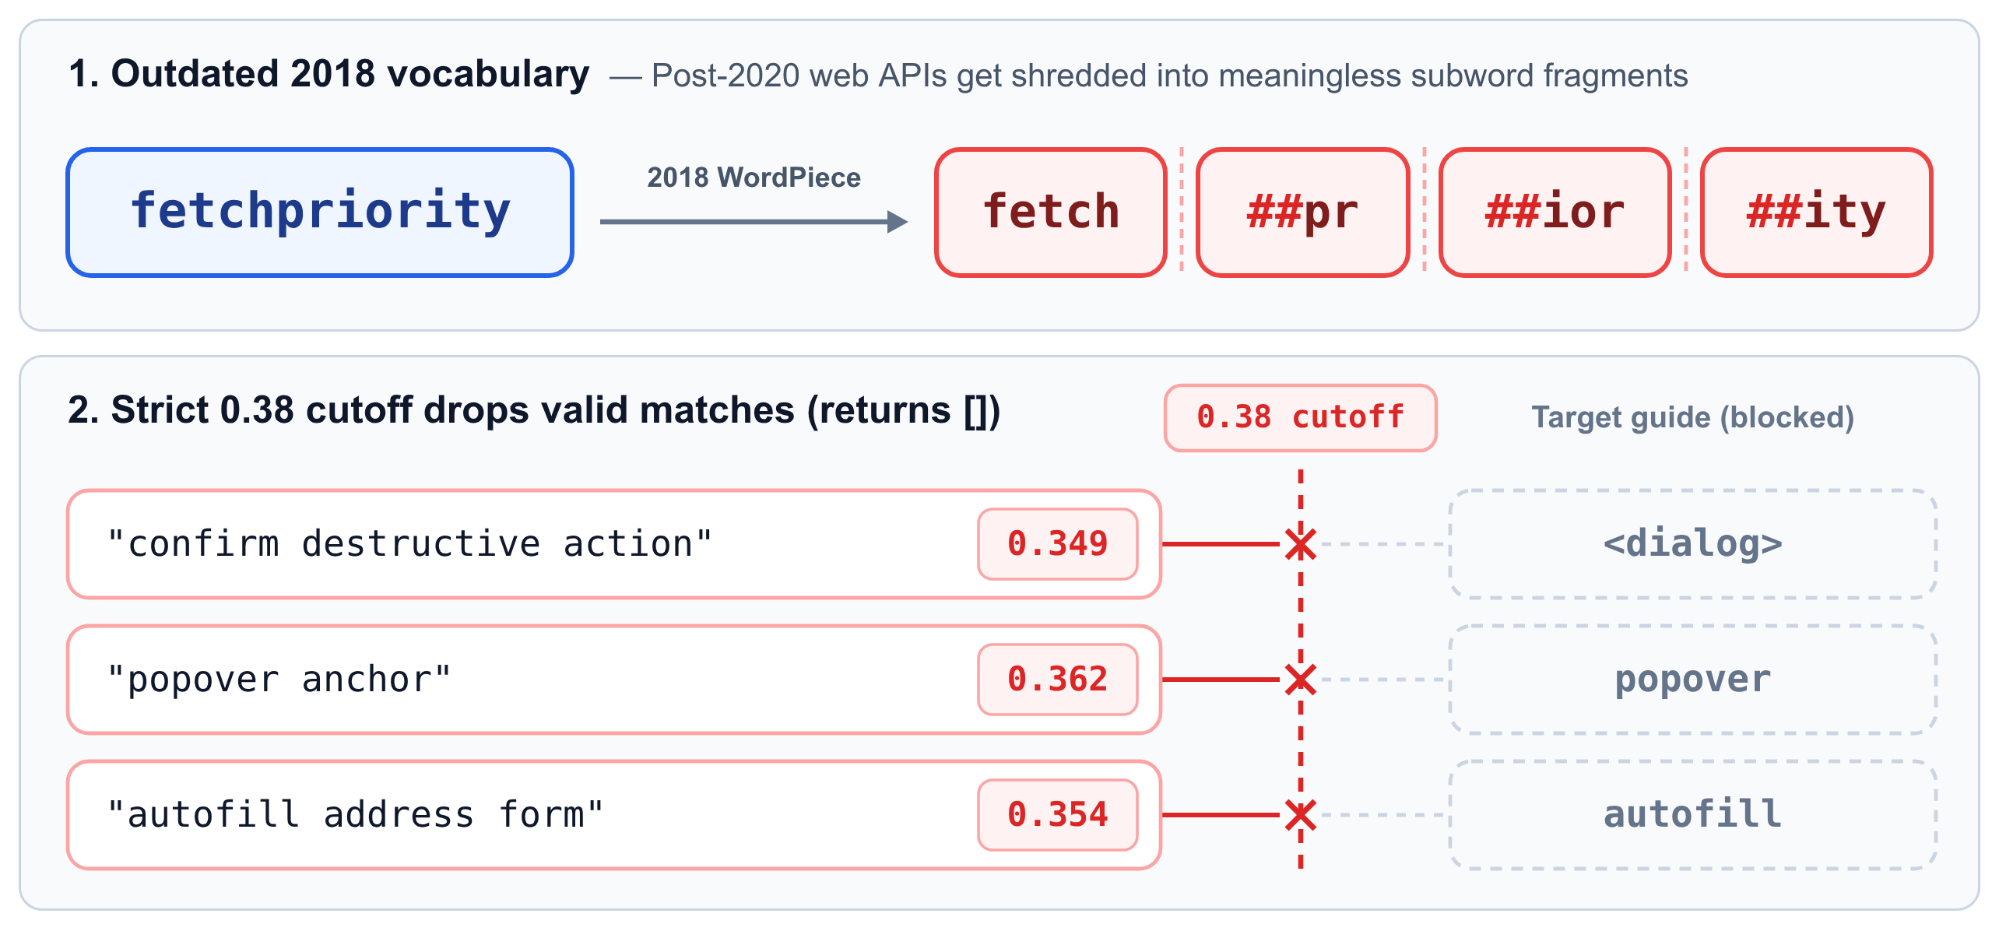
all-MiniLM-L6-v2는 2018~2020년경에 학습되었으므로 WordPiece 어휘는 2020년 이후의 웹 API가 존재한다는 사실을 전혀 알지 못합니다. 상담사가fetchpriority,popover또는startViewTransition를 검색하면 2018 토크나이저는fetchpriority를fetch·##pr·##ior·##ity라는 의미 없는 하위 단어 4개로 분할합니다.- 범위를 벗어난 쿼리가 무작위 가이드를 반환하지 않도록 하기 위해 이전 PR에서 엄격한
0.38코사인 유사도 기준을 추가했습니다. MiniLM은 3단어 구문"confirm destructive action"를0.38이상의"dialog"에 연결할 수 없었기 때문에(0.349점수,"popover anchor"는0.362,"autofill address form"는0.354) 게이트는 유효한 일치를 삭제했습니다. 더 나쁜 것은search가[]를 반환할 때마다 기술 안내가 에이전트에게modern-web-guidance list로 대체하도록 지시하여 약 200개의 가이드 설명(약 1,500개의 낭비된 토큰)을 모두 컨텍스트에 덤프했다는 것입니다.
검색 수정: 실제 원격 분석, 하이브리드 검색, 결과 10개 반환
원래 벤치마크는 가이드 자체에서 생성된 850개의 합성 쿼리였는데, 이 쿼리는 가이드 문구와 너무 밀접하게 일치하여 이러한 실패를 포착할 수 없었습니다. 이에 따라 Google은 선택 해제된 CLI 원격 분석(에이전트의 2~5단어 search 인수만 로깅하고 사용자 프롬프트나 저장소 코드는 로깅하지 않으며 DISABLE_TELEMETRY=1를 준수함)에서 샘플링한 4,000개의 실시간 검색과 Claude Code, Codex CLI, Gemini CLI 전반의 야간 에이전트 평가에서 추출한 1,029개의 검색을 기반으로 새로운 평가 도구(pnpm benchmark:rag)를 구축했습니다.
보류된 쿼리에 대해 Git 기록을 재생한 결과 0.38 기준점으로 인해 빈 [] 응답이 8배 급증한 것으로 나타났습니다. 벤치마크를 설정한 후 임베딩 모델을 수정하기 전에 두 가지 빠른 개선사항을 적용했습니다.
- 하이브리드 키워드 + 시맨틱 검색: 밀집 벡터는 정확한 API 이름(
:user-invalid,showModal,details-name)을 흐리게 처리하는 반면, 키워드 검색은 에이전트가 API 이름을 모를 때 의도 쿼리를 놓칩니다. 복수형 어간 추출을 사용하는 종속 항목이 없는 BM25(아는 사람은 아는) 키워드 색인을 추가하고, 각 가이드의web-feature-ids를 색인화하고, BM25를 시맨틱 순위와 결합했습니다. 이제search는 시맨틱 유사성이<0.30이고 BM25의 키워드 일치 항목이 0인 경우에만[]를 반환합니다. - 상세한 결과 5개 대신 간결한 결과 10개: 스킬 안내에서 이미 상담사에게
similarity및tokenCount를 무시하라고 안내했습니다. 사용되지 않는 필드를 제거하면 간결한{id, description}결과 10개를 상세한 결과 5개와 정확히 동일한 약 530개의 토큰 예산에 맞출 수 있습니다.
// Before: 5 verbose results (~105 tokens each = ~525 tokens)
{
  "id": "dialog",
  "category": "html",
  "description": "Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby.",
  "featuresUsed": ["dialog", "dialog-closedby"],
  "tokenCount": 780,
  "similarity": 0.49
}
// After: 10 compact results (~53 tokens each = ~530 tokens)
{"id":"dialog","description":"Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby."}
이 두 가지 변경사항을 통해 홀드아웃 원격 분석 쿼리의 검색 적중률이 80.6% 에서 94.7%로 향상되었습니다. 이는 Hit@K(예상 가이드가 상위 K개 결과에 표시되는지 여부)로 측정되었습니다.
3세대: 사전 준비된 임베딩 및 7줄 for 루프
실제 상담사 검색의 86.7% 가 2~5단어(중앙값: 3단어)에 불과한 것으로 나타나 94.7%의 적중률에서도 원격 분석 결과는 현저한 불일치를 보였습니다. 상담사가 3단어 구문을 검색할 때마다 Node는 TensorFlow.js를 부팅하고 22.6MB 신경망을 파싱하며 770ms의 콜드 스타트 지연 시간과 346MB의 최대 RAM을 소모했습니다.
신경망 없이 3단어 검색어를 임베딩하는 더 가벼운 방법이 있는지 묻자 Antigravity 에이전트는 Model2Vec, Tokenlearn, Matryoshka 차원, Adagrad와 같은 익숙하지 않은 ML 정제 기법을 제시했습니다. (자세한 내용은 검색 품질 페이지를 참고하세요.)
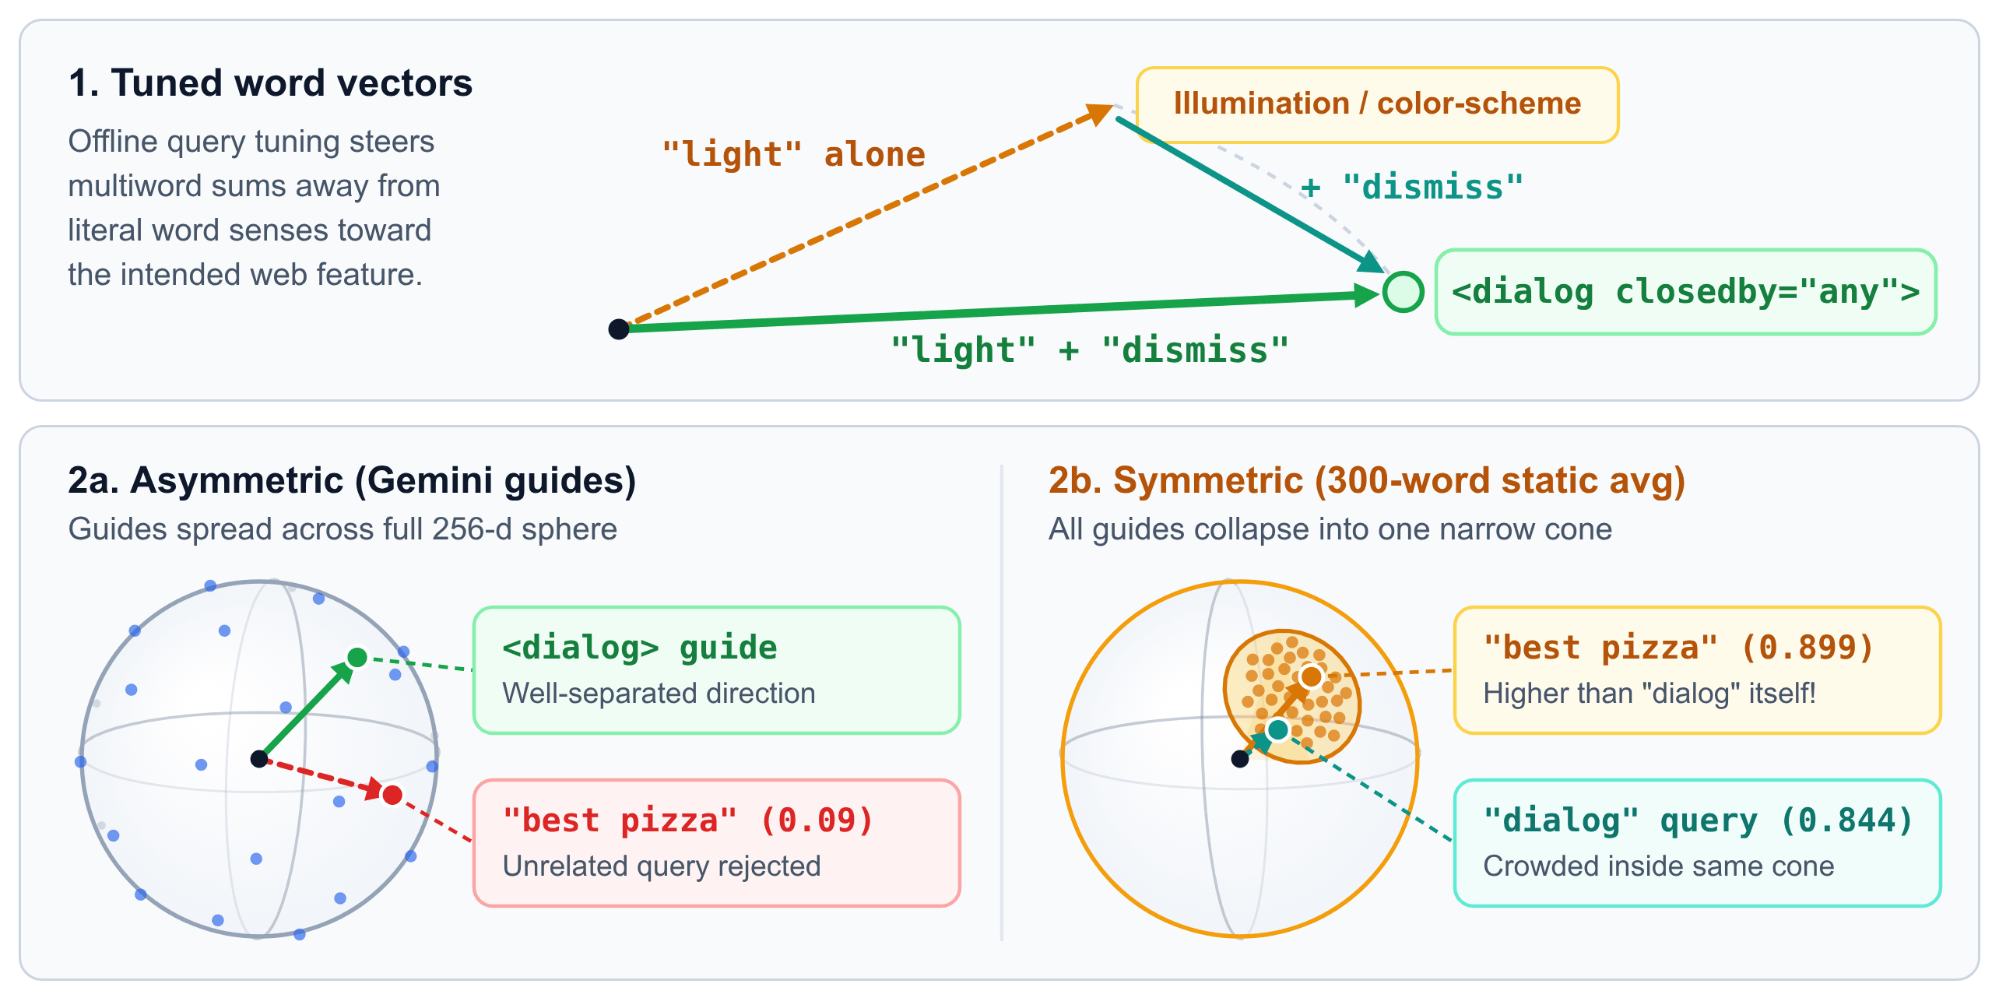
표준 로컬 RAG는 사용자의 CPU에서 동일한 소형 모델을 통해 문서와 쿼리를 모두 강제로 처리합니다. 하지만 npm 출시 버전을 잘라낸 후에도 약 200개의 가이드는 변경되지 않으므로 작은 2018 모델로 임베딩할 이유가 없습니다. 대신 embed-guide-chunks.ts는 gemini-embedding-001를 사용하여 클라우드에서 출시 시점에 모든 가이드 벡터를 미리 준비하고 바이너리 256차원 Int8 벡터(guide-chunks.i8, 335 KB gzip 압축)로 제공합니다.
오프라인 상태에서 API 키를 사용하지 않는 CLI가 사용자의 실시간 쿼리를 어떻게 정확히 동일한 Gemini 벡터 공간에 투영할 수 있을까요? 에이전트 쿼리는 거의 항상 2~5단어이므로 런타임에 트랜스포머가 필요하지 않습니다. 알려진 단어(table)의 벡터 참고표와 이를 합산하는 스마트한 방법만 있으면 됩니다. 런타임 시 전체 23MB TensorFlow.js 파이프라인은 static-embedder.ts에서 7줄의 for 루프로 축소됩니다.
// Each word's weight and Int8 scale are pre-folded into `scales[i]`
for (const [i, f] of enc) {
  const wt = scales[i] * f;
  const offset = i * 256;
  for (let k = 0; k < 256; k++) {
    out[k] += wt * table[offset + k];
  }
}
이 참고표(train-query-words.ts)를 빌드하기 위해 29,165개의 단어 어휘(fetchpriority, light-dismiss, popover, scrollytelling와 같은 최신 웹 용어가 독립적인 전체 단어임)를 가져와 gemini-embedding-001로 임베딩하고 33,000개의 실제 웹 검색어에 대해 단어 벡터를 오프라인으로 조정하여 여러 단어 조합이 올바른 위치에 배치되도록 했습니다(예: "light" + "dismiss"는 조명이나 색 구성표가 아닌 <dialog closedby="any">를 가리킴). Int8(query-words.i8)로 압축된 전체 참고표는 5.3 MB gzip으로 압축됩니다.
정적 참고표를 사용하여 가이드도 삽입하고 Cloud Build 단계를 건너뛰는 것은 어떨까요? 처음에는 이 방법을 시도했지만 전체 단락에서 문제가 발생했습니다. 검색어 3개를 합산하면 정확도가 유지되지만, 전체 가이드에서 수백 개의 단어를 평균화하면 모든 가이드가 일반적인 영어 평균에 가까운 좁은 범위로 축소됩니다. 예를 들어 "best pizza in new york"는 dialog 가이드와 0.899의 코사인 유사도를 기록했는데, 이는 검색어 "dialog" 자체의 유사도인 0.844보다 높았습니다. 3단어 정적 검색어 조회(query-words.i8)를 전체 모델 Gemini 가이드 임베딩(guide-chunks.i8)과 페어링하면 클라우드 수준의 정확도를 얻을 수 있으며, 검색어는 여전히 30µs 내에 오프라인으로 실행됩니다.
3세대에 걸친 스코어보드
출시 단계 전반에서 Hit@K는 전체 문서 임베딩을 사용한 78.2%에서 정적 Int8 임베딩 도구를 사용한 95.4%로 증가했습니다(클라우드 gemini-embedding-001 API를 사용한 96.9%와 비교).
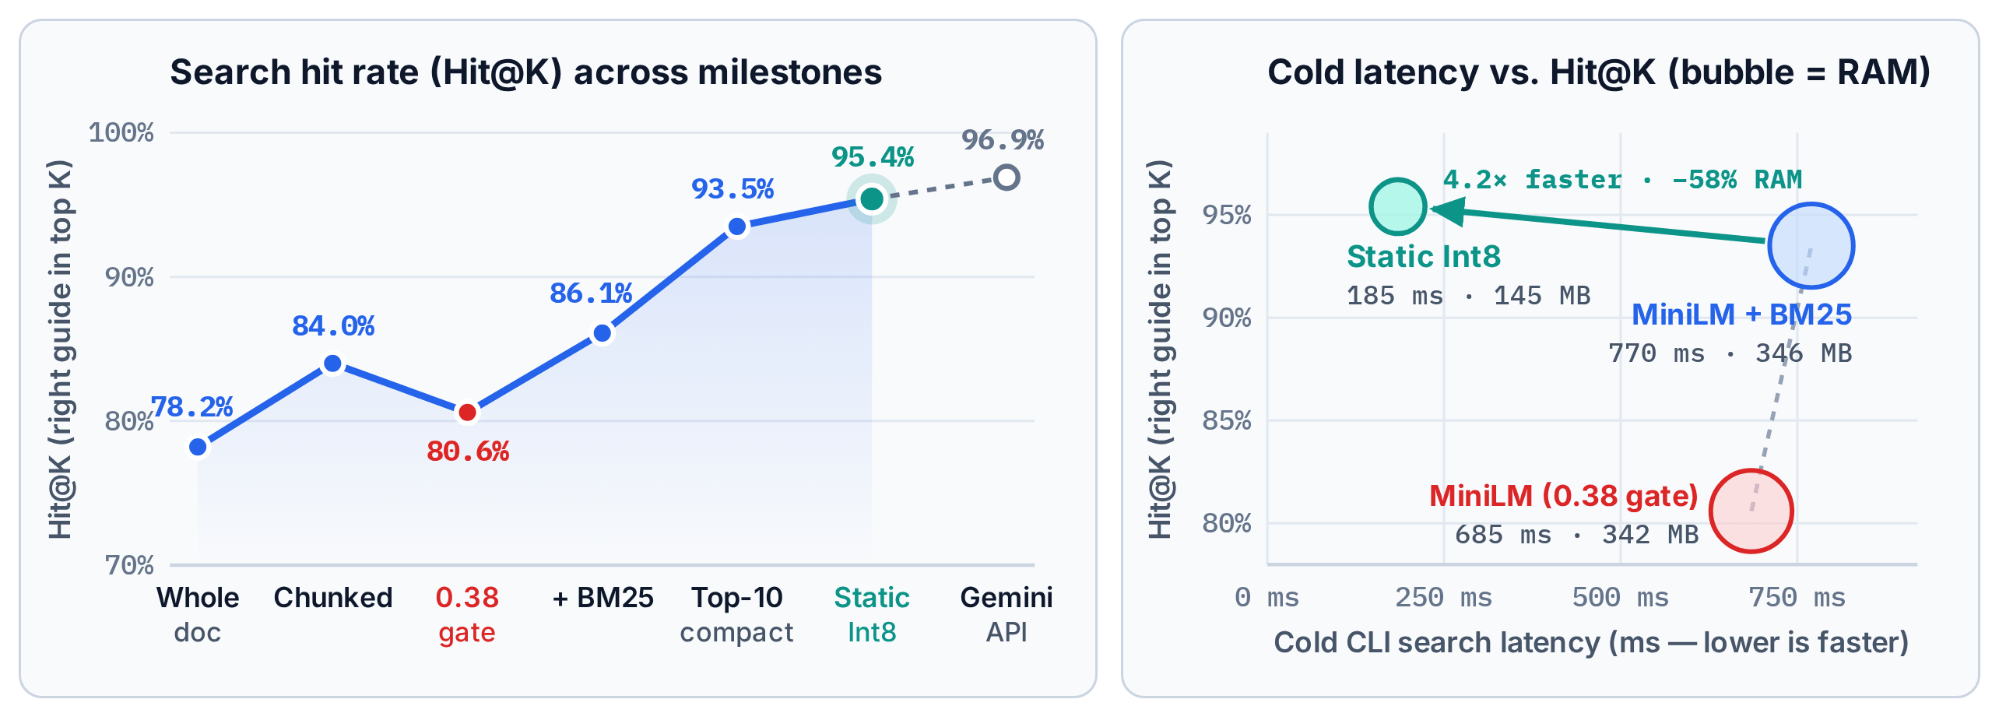
정적 임베더를 적용한 후 세 세대의 성능은 다음과 같습니다.
그리고 이전에 손상된 Codex 쿼리를 실행하면 다음과 같습니다.
npx modern-web-guidance@latest search "confirm destructive action"
dialog 가이드가 목록 상단에 다시 표시됩니다.
(검색 품질 대시보드에서 모든 마일스톤, 검색어 길이, K 범위에 걸쳐 대화형 차트를 살펴볼 수 있습니다.)
코드는 저렴하지만 측정은 작업입니다.
에이전트는 몇 분 만에 BM25 순위 지정기 또는 단어 벡터 증류 스크립트를 작성할 수 있습니다. 후보 구현을 생성하는 것은 더 이상 병목 현상이 아닙니다. 변경사항이 실제로 도움이 되었는지(또는 0.38 게이트처럼 프로덕션 검색의 9% 를 조용히 중단시켰는지)를 파악하는 것이 거의 모든 작업입니다.
이 시스템에 접근한 방식은 다음과 같습니다.
- 북극성 목표를 정의하고 단일 구현보다 측정 도구에 투자합니다. Google은 검색기를 작성하는 것보다
pnpm benchmark:rag를 빌드하고, 5,000개의 실제 쿼리를 선별하고, 사람의 평가에 맞춰 자동 채점을 보정하는 데 훨씬 더 많은 시간을 할애했습니다. - 품질을 판단하는 기준을 수립하고 실제 데이터가 반영되면 이 기준이 발전할 것으로 예상합니다. 이를 '측정 우선'이라고 부르지만 이는 절반만 맞는 말입니다. 첫날에 기본적인 정답 확인을 작성할 수 있지만, 실제 실패를 검사하기 전에 진공 상태에서 좋은 기준표를 설계할 수는 없습니다(Shankar 등은 Who Validates the Validators?에서 이를 기준 드리프트라고 부름). 에이전트가 1,500토큰
list대체를 트리거하는 것을 보고 회상과 함께 토큰 비대화에 페널티를 적용하게 되었습니다. - 신뢰할 수 있는 측정값을 확보한 후에는 다양한 구현을 적극적으로 실험하고 스코어보드를 통해 아키텍처 논쟁을 해결하세요. 벤치마크가 5,000개의 쿼리를 몇 초 만에 평가하면 7줄의
Int8루프가 23MB 트랜스포머보다 나은지 여부를 PR에서 논쟁할 필요가 없습니다. 오후에 다섯 가지 접근 방식을 시도해 보고 가장 효과적인 방식을 선택하세요.
물론 모든 코드(임베더, 디스틸러, 벤치마크 하네스 포함)는 오픈소스입니다.