


Opublikowano: 12 listopada 2026 r.
W tym tygodniu wprowadziliśmy Przewodnik po współczesnych technologiach internetowych 1.0, czyli umiejętność open source, która pomaga agentom kodującym korzystać z nowoczesnych funkcji platform internetowych zamiast starszych rozwiązań. W tym poście przyjrzymy się lokalnej wyszukiwarce, która znajduje najbardziej odpowiedni przewodnik do danego zadania, nie marnując przy tym tokenów.
Jeśli powiesz inżynierowi, że utworzyłeś bazę wiedzy z 1,7 MB tekstu w formacie Markdown dla jego agenta kodującego, zada on 2 pytania:
- „Ile tokenów zostanie zrzuconych do mojego okna kontekstu?”
- „Jakiej wektorowej bazy danych wymaga?”
W ciągu ostatnich 6 miesięcy 3-krotnie przebudowaliśmy nasz lokalny mechanizm pobierania. Zaczęliśmy od 507 MB powiązań C++, potem zeszliśmy do 23 MB czystego kodu JavaScript przy użyciu TensorFlow.js, a następnie do pakietu o rozmiarze 7 MB, w którym wektory dystrybucyjne zapytań to 7-wierszowa pętla for, a jednocześnie poprawiliśmy dokładność.
Agentowa RAG i stopniowe odkrywanie
Wrzucenie do AGENTS.md 1,7 MB tekstu w formacie Markdown zawierającego ponad 200 przewodników po HTML/CSS/Web API nie jest praktyczne. Wierzymy w stopniowe ujawnianie informacji, ale wiemy, że indeks Markdown przestanie być efektywny pod względem tokenów na dużą skalę.
Aby rozwiązać ten problem, używamy agentowej RAG obsługiwanej przez interfejs wiersza poleceń wyszukiwania:
- W stanie spoczynku agent widzi tylko opis umiejętności (~205 tokenów). Opis jest zgodny z wytycznymi Anthropic dotyczącymi aktywowania umiejętności, dzięki czemu agent wywołuje umiejętność w przypadku odpowiednich zadań frontendu.
- W przypadku zadań związanych z frontendem agent może użyć interfejsu wiersza poleceń, aby wyszukać:
modern-web-guidance search "animate height auto", co daje 10 trafnych dopasowań (~530 tokenów). - Agent uruchamia
modern-web-guidance retrieve animate-to-intrinsic-sizes, aby pobrać cały przewodnik (około 800 tokenów). Teraz zawiera sprawdzone metody implementacji dotyczące zgodności, kreacji zastępczych i techniki.
Dlaczego umiejętność CLI, a nie serwer MCP lub wyszukiwanie w internecie?
- Narzędzia MCP marnują tokeny lub mają zawodne mechanizmy aktywacji (ze względu na dynamiczne wykrywanie narzędzi). Opis umiejętności jest zoptymalizowany pod kątem skuteczności i umożliwia agentowi korzystanie ze wskazówek tylko wtedy, gdy jest to konieczne.
- Wbudowana wyszukiwarka internetowa wyświetla odpowiedzi ze Stack Overflow z 2015 roku i dokumentację referencyjną, a nie aktualne, wyselekcjonowane wzorce implementacji
DO/DO NOT. Ponadto zajmuje to kilka sekund w sieci i nie działa w piaskownicach offline, podczas gdy lokalny interfejs wiersza poleceń działa na procesorze w milisekundy.
Generacja 1: prototyp w C++ o rozmiarze 507 MB
Pierwsza wersja Przewodnika po współczesnych technologiach internetowych korzystała z lokalnego stosu RAG: LanceDB, Apache Arrow i Transformers.js z onnxruntime-native.
Działało to dobrze na komputerze używanym do programowania, ale nie pasowało do umiejętności agenta:
- Gdy dodajesz umiejętność do projektu (lub agent wywołuje ją za pomocą
npx), nie oczekujesz, że będziesz czekać na pobranie przeznpm installplików binarnych.nodezależnych od architektury lub na kompilacjęnode-gypC++, która zwykle kończy się niepowodzeniem w piaskownicach w chmurze. - Wyodrębniony katalog
node_modulesmiał rozmiar 507 MB.
Gen 2: zmniejszanie TensorFlow.js do 23 MB
Chcieliśmy, aby nie było kompilacji natywnej i aby kod był wykonywany natychmiast wszędzie tam, gdzie działa Node. Dlatego w kwietniu zastąpiliśmy stos natywny silnikiem procesora opartym wyłącznie na języku JavaScript, który działa w all-MiniLM-L6-v2 na @tensorflow/tfjs:
- Zastąpiliśmy
onnxruntime-nodew esbuild i tokenizator Hugging Face niewielkim tokenizatorem BERT WordPiece w drzewie (0 niezgodności identyfikatorów tokenów). - Po przeanalizowaniu mapy źródłowej zmniejszyliśmy liczbę modułów
@tensorflow/tfjs-backend-cpuz ponad 400 do 26 jąder, których faktycznie używa MiniLM, co pozwoliło zmniejszyć silnik JS z 6 MB do 830 KB. - Zrezygnowaliśmy z LanceDB na rzecz wektorów skompresowanych gzipem w czasie kompilacji i skanowania iloczynu skalarnego
<1 msw pamięci we wszystkich około 200 przewodnikach. - Umieść kod do umieszczenia za wywołaniem
import(), aby funkcjeretrieveilistkończyły działanie w czasie krótszym niż 10 milisekund.
Dzięki temu pakiet npm został zmniejszony do 23 MB bez zależności w czasie działania. Udostępniliśmy go, a agenci przeprowadzili w nim około 750 tysięcy wyszukiwań.
Gdzie MiniLM przestało działać w wersji produkcyjnej
Po kilku miesiącach przyjrzeliśmy się trajektoriom, w których agenty miały zainstalowaną umiejętność, ale nadal pisały starszy kod.
W jednym uruchomieniu Codex programista poprosił o wyświetlenie prośby o potwierdzenie usunięcia. Mamy cały przewodnik na temat tworzenia dostępnych okien modalnych potwierdzenia za pomocą kodu HTML <dialog closedby="any">.
Pracownik obsługi klienta postąpił prawidłowo i wyszukał:
npx modern-web-guidance@latest search "confirm destructive action"
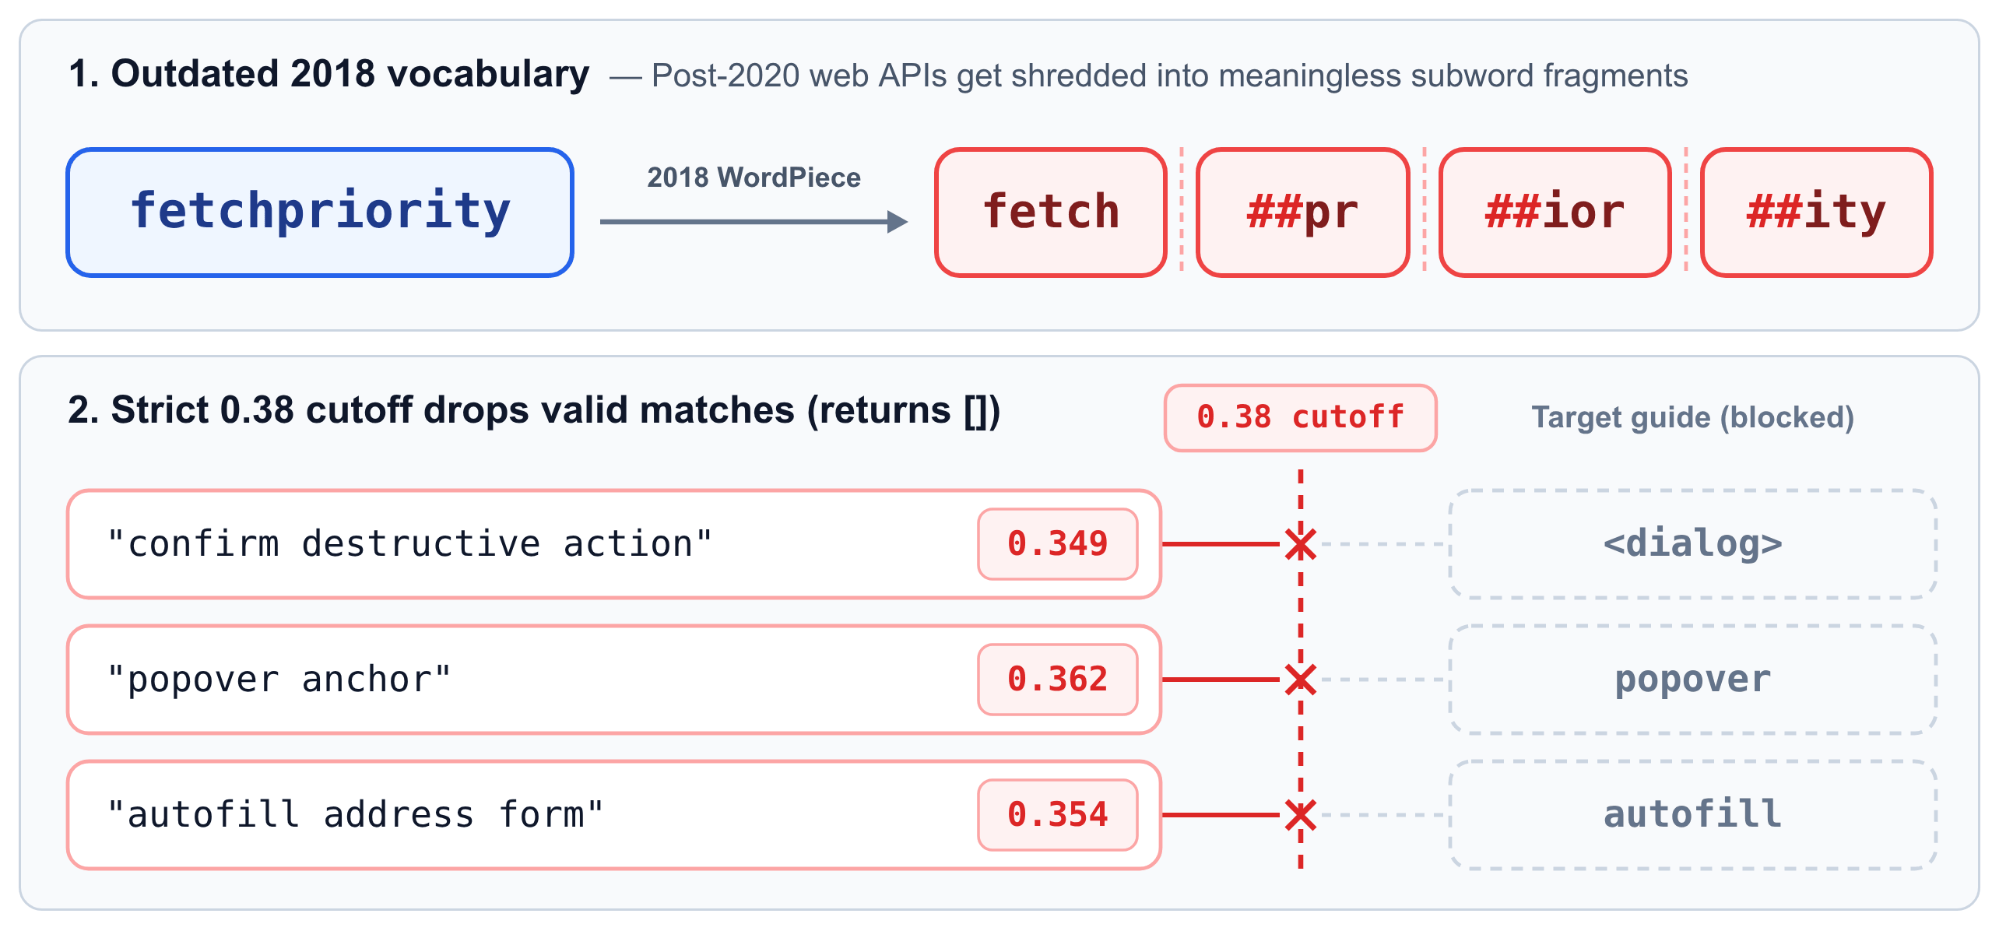
Interfejs wiersza poleceń zwrócił []. Agent wzruszył ramionami i napisał window.confirm().
Dlaczego nie zwróciła żadnych wyników? Gdy przeanalizowaliśmy logi i wektory dystrybucyjne, zauważyliśmy 2 luki w pobieraniu:
- Model
all-MiniLM-L6-v2został wytrenowany w latach 2018–2020, więc jego słownik WordPiece dosłownie nie wie o istnieniu interfejsów API sieci Web po 2020 roku. Gdy agent wyszukujefetchpriority,popoverlubstartViewTransition, tokenizator z 2018 r. dzielifetchpriorityna 4 pozbawione znaczenia podwyrazy:fetch·##pr·##ior·##ity. - Aby zapobiec zwracaniu losowych przewodników w przypadku zapytań spoza zakresu, we wcześniejszym PR dodano rygorystyczny próg podobieństwa cosinusowego na poziomie
0.38. Ponieważ model MiniLM nie był w stanie połączyć 3-wyrazowego wyrażenia"confirm destructive action"z"dialog"powyżej0.38(wynik0.349, podczas gdy"popover anchor"uzyskał0.362, a"autofill address form"–0.354), bramka odrzuciła prawidłowe dopasowania. Co gorsza, gdysearchzwracało[], instrukcje umiejętności nakazywały agentowi powrót domodern-web-guidance list, co powodowało zrzucenie wszystkich ok. 200 opisów przewodników (ok. 1500 zmarnowanych tokenów) do kontekstu.
Naprawianie pobierania: rzeczywiste dane telemetryczne, wyszukiwanie hybrydowe i zwracanie 10 wyników
Nasz pierwotny test porównawczy obejmował 850 zapytań syntetycznych wygenerowanych na podstawie samych przewodników, które były zbyt podobne do sformułowań w przewodnikach, aby można było wykryć te błędy. Dlatego stworzyliśmy nowy zestaw do oceny (pnpm benchmark:rag) obejmujący około 4000 wyszukiwań na żywo pobranych z danych telemetrycznych interfejsu wiersza poleceń z opcją rezygnacji (które rejestrują tylko argument search agenta składający się z 2–5 słów, nigdy prompty użytkownika ani kod repozytorium, i przestrzegają DISABLE_TELEMETRY=1) oraz 1029 wyszukiwań wydobytych z nocnych ocen agentów w Claude Code, Codex CLI i interfejsie wiersza poleceń Gemini.
Odtworzenie historii git w odniesieniu do tych odłożonych zapytań wykazało, że wartość graniczna 0.38 spowodowała 8-krotny wzrost liczby pustych odpowiedzi []. Po ustaleniu punktu odniesienia wprowadziliśmy 2 szybkie ulepszenia, zanim zajęliśmy się modelem wektorów dystrybucyjnych:
- Wyszukiwanie hybrydowe (słowa kluczowe + wyszukiwanie semantyczne): wektory gęste zacierają dokładne nazwy interfejsów API (
:user-invalid,showModal,details-name), a wyszukiwanie słów kluczowych pomija zapytania dotyczące intencji, gdy agent nie zna nazwy interfejsu API. Dodaliśmy indeks słów kluczowych BM25 (jeśli wiesz, o co chodzi, to wiesz) bez zależności, z rdzeniami w liczbie mnogiej, zindeksowaliśmyweb-feature-idskażdego przewodnika i połączyliśmy BM25 z rankingiem semantycznym. Terazsearchzwraca[]tylko wtedy, gdy podobieństwo semantyczne wynosi<0.30i BM25 nie ma trafień słów kluczowych. - 10 krótkich wyników zamiast 5 szczegółowych: instrukcje dotyczące umiejętności już nakazywały agentom ignorowanie
similarityitokenCount. Dzięki usunięciu tych nieużywanych pól możemy zmieścić 10 wyników kompaktowych{id, description}w tym samym budżecie ok. 530 tokenów co 5 wyników szczegółowych:
// Before: 5 verbose results (~105 tokens each = ~525 tokens)
{
  "id": "dialog",
  "category": "html",
  "description": "Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby.",
  "featuresUsed": ["dialog", "dialog-closedby"],
  "tokenCount": 780,
  "similarity": 0.49
}
// After: 10 compact results (~53 tokens each = ~530 tokens)
{"id":"dialog","description":"Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby."}
Te 2 zmiany pozwoliły zwiększyć współczynnik trafień w wyszukiwarce w przypadku zapytań telemetrycznych z 80,6% do 94,7%, mierzony jako Hit@K (czy oczekiwany przewodnik pojawia się w pierwszych K wynikach).
Generacja 3: gotowe wektory dystrybucyjne i 7-wierszowa pętla for
Nawet przy współczynniku trafień na poziomie 94.7% nasze dane telemetryczne wykazały rażącą rozbieżność: 86, 7% wyszukiwań pracowników obsługi klienta zawierało tylko od 2 do 5 słów (mediana: 3 słowa). Za każdym razem, gdy agent wyszukiwał 3-wyrazową frazę, Node uruchamiał TensorFlow.js, analizował sieć neuronową o rozmiarze 22,6 MB i zużywał 770 ms na czas oczekiwania na uruchomienie oraz 346 MB pamięci RAM w szczytowym momencie.
Gdy zapytaliśmy, czy istnieje lżejszy sposób na osadzanie 3-wyrazowych zapytań bez sieci neuronowej, nasz agent Antigravity zaproponował szereg nieznanych technik destylacji ML: Model2Vec, Tokenlearn, wymiary Matryoshka, Adagrad. (Jeśli chcesz poznać szczegóły techniczne, znajdziesz je na naszej stronie poświęconej jakości wyszukiwania).
Standardowa lokalna technika RAG wymusza przetwarzanie zarówno dokumentów, jak i zapytań przez ten sam mały model na procesorze użytkownika. Jednak nasze około 200 przewodników nie zmienia się po wydaniu wersji npm, więc nie ma powodu, aby umieszczać je w niewielkim modelu z 2018 roku. Zamiast tego embed-guide-chunks.ts wstępnie przygotowuje wszystkie wektory przewodnika w momencie wydania w chmurze za pomocą gemini-embedding-001 i dostarcza je jako binarne 256-wymiarowe wektory Int8 (guide-chunks.i8, 335 KB skompresowane gzipem).
Jak interfejs wiersza poleceń działający offline i bez klucza interfejsu API może przekształcić zapytanie użytkownika na żywo w dokładnie tę samą przestrzeń wektorową Gemini? Ponieważ zapytania agentów prawie zawsze składają się z 2–5 słów, nie potrzebujemy transformatora w czasie działania. Potrzebujemy tylko tabeli przeglądowej wektorów dla znanych słów (table) i inteligentnego sposobu ich sumowania. W czasie działania cały potok TensorFlow.js o rozmiarze 23 MB zostaje skompresowany do 7-wierszowej pętli for w static-embedder.ts:
// Each word's weight and Int8 scale are pre-folded into `scales[i]`
for (const [i, f] of enc) {
  const wt = scales[i] * f;
  const offset = i * 256;
  for (let k = 0; k < 256; k++) {
    out[k] += wt * table[offset + k];
  }
}
Aby utworzyć tę tabelę przeglądową (train-query-words.ts), wzięliśmy słownik zawierający 29 165 słów (w którym nowoczesne terminy internetowe, takie jak fetchpriority, light-dismiss, popover i scrollytelling, są samodzielnymi całymi słowami), osadziliśmy je za pomocą gemini-embedding-001 i dostosowaliśmy wektory słów offline do 33 000 rzeczywistych zapytań internetowych, aby kombinacje wielowyrazowe trafiały we właściwe miejsce (np. "light" + "dismiss" wskazuje na <dialog closedby="any">, a nie na oświetlenie czy schematy kolorów). Skompresowana do Int8 (query-words.i8) cała tabela przeglądowa ma rozmiar 5.3 MB po skompresowaniu gzip.
Dlaczego nie użyć tej statycznej tabeli przeglądowej do umieszczenia przewodników i pominąć krok Cloud Build? Najpierw wypróbowaliśmy to rozwiązanie, ale nie sprawdziło się w przypadku całych akapitów: sumowanie 3 słów zapytania działa dobrze, ale uśrednianie setek słów w całym przewodniku powoduje, że każdy przewodnik jest sprowadzany do wąskiego stożka w pobliżu ogólnej średniej dla języka angielskiego (do tego stopnia, że podobieństwo cosinusowe między "best pizza in new york" a naszym przewodnikiem dialog wyniosło 0.899, czyli więcej niż w przypadku samego zapytania "dialog", które uzyskało wynik 0.844). Połączenie 3-słownych statycznych wyszukiwań zapytań (query-words.i8) z pełnymi wektorami dystrybucyjnymi przewodnika Gemini (guide-chunks.i8) zapewnia dokładność na poziomie chmury, a zapytania nadal działają offline w 30 µs.
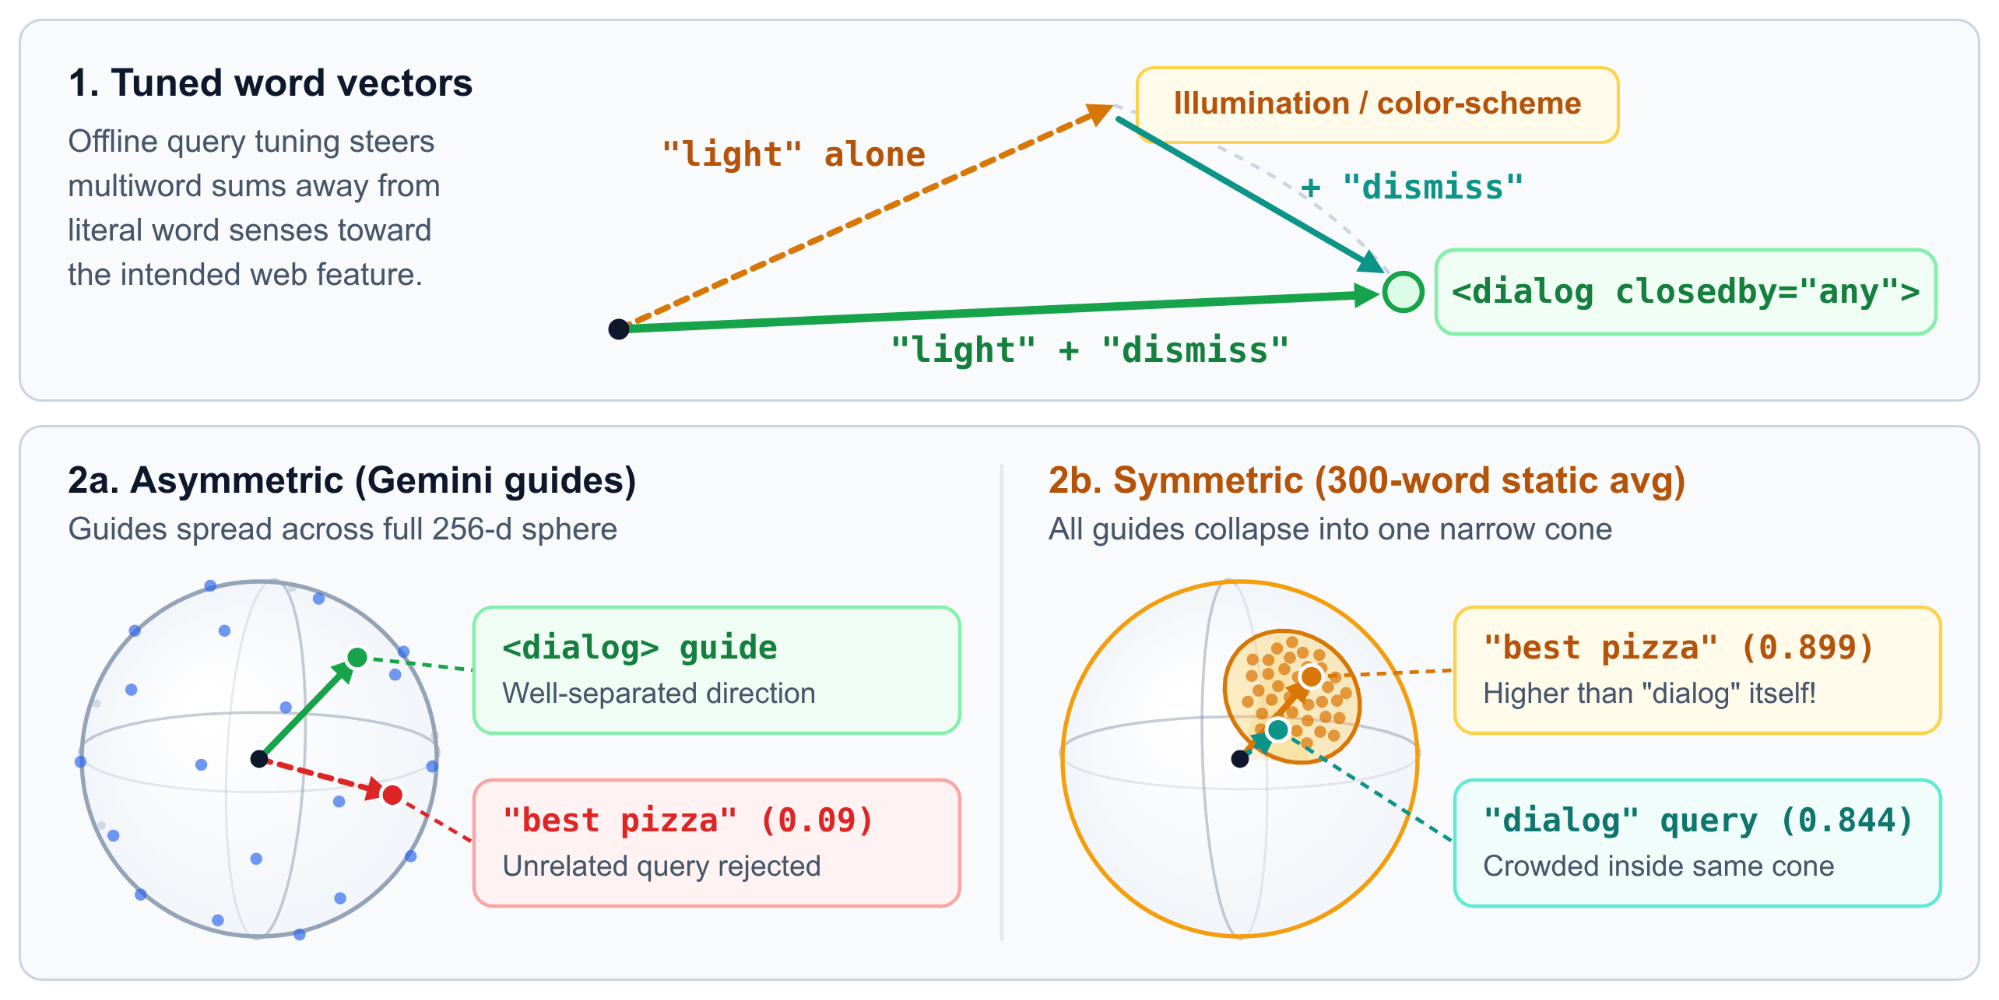
Tabela wyników dla wszystkich 3 generacji
W przypadku kolejnych wersji Hit@K wzrosła z 78,2% przy wektorach dystrybucyjnych całego dokumentu do 95,4% przy statycznym wektoryzatorze Int8 (w porównaniu z 96,9% przy Cloud APIs gemini-embedding-001):
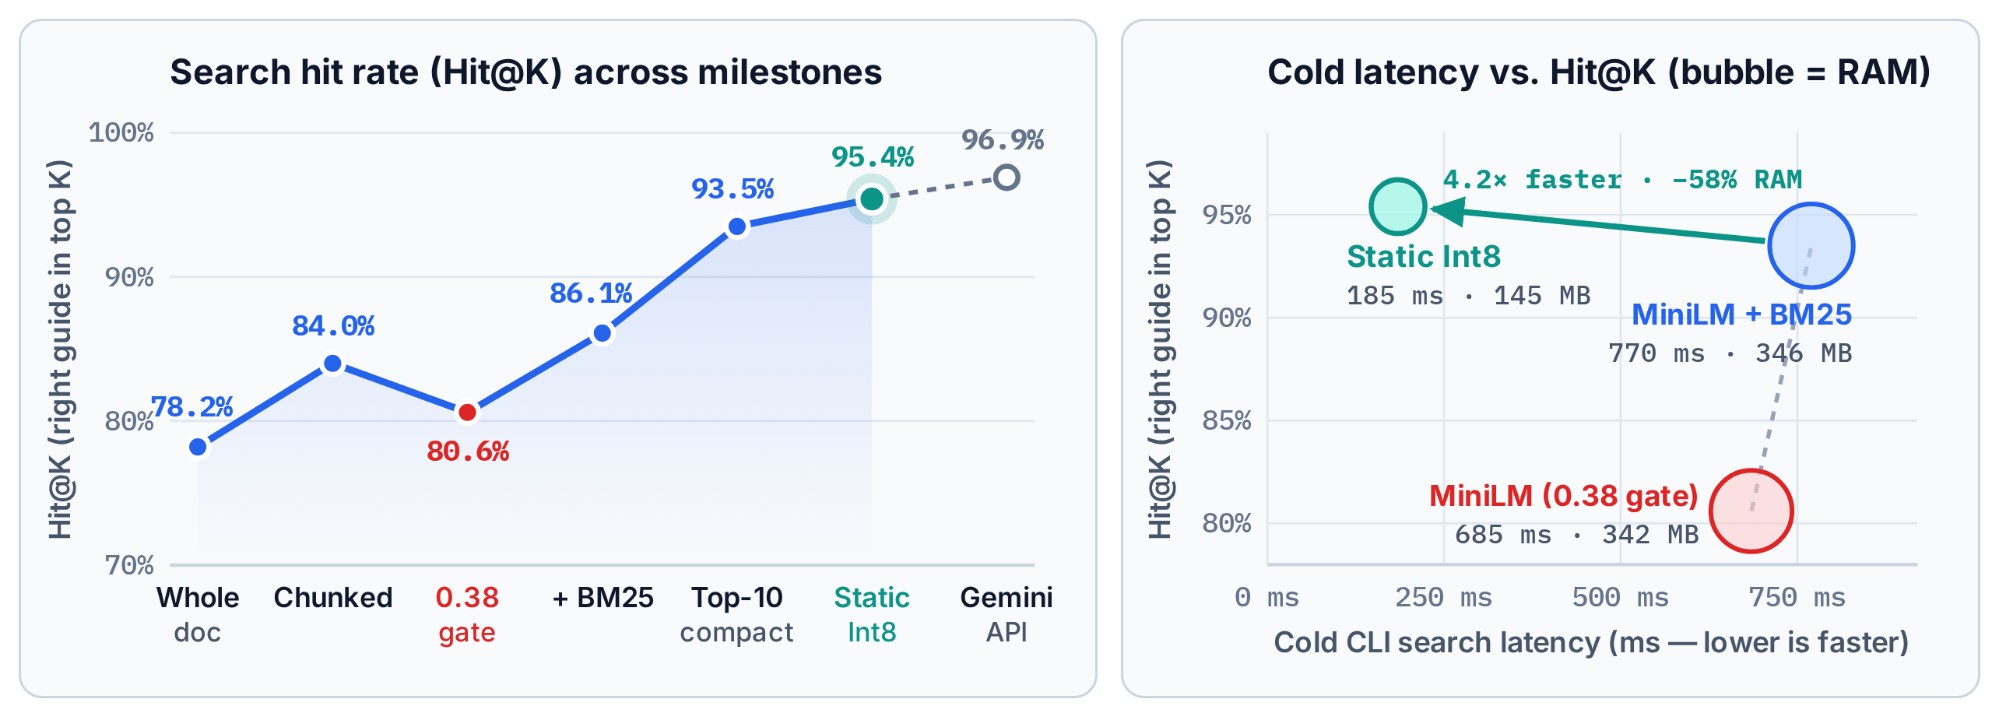
Oto jak wyglądają te 3 generacje po wprowadzeniu statycznego osadzania:
Jeśli uruchomisz wcześniejsze nieprawidłowe zapytanie Codex:
npx modern-web-guidance@latest search "confirm destructive action"
Przewodnik dialog pojawi się na górze listy.
(Interaktywne wykresy dotyczące wszystkich etapów, długości zapytań i horyzontów K możesz przeglądać w panelu jakości wyszukiwania).
Kod jest tani, pomiary to praca
Agent może w kilka minut napisać skrypt do rankingu BM25 lub destylacji wektorów słów. Generowanie implementacji kandydatów nie jest już wąskim gardłem. Wiedza o tym, czy zmiana faktycznie pomogła (czy też po cichu zepsuła 9% wyszukiwań produkcyjnych, jak to miało miejsce w przypadku bramki 0.38), to prawie cała praca.
Oto jak podeszliśmy do tego systemu:
- Określ cel nadrzędny i zainwestuj w narzędzia pomiarowe, a nie w pojedyncze wdrożenie. Poświęciliśmy znacznie więcej czasu na utworzenie
pnpm benchmark:rag, wybranie 5000 rzeczywistych zapytań i skalibrowanie automatycznej oceny względem ocen wystawianych przez ludzi niż na napisanie jakiegokolwiek retrievera. - Opracuj zestaw kryteriów, według których Ty i Twoi agenci będziecie oceniać jakość, i oczekuj, że będzie on ewoluować, gdy zaczniecie korzystać z rzeczywistych danych. Nazywa się to „pomiarem na pierwszym miejscu”, co jest tylko częściowo słuszne: pierwszego dnia możesz napisać podstawowe testy ze znanymi odpowiedziami, ale nie możesz zaprojektować dobrej rubryki w próżni, zanim nie przeanalizujesz rzeczywistych błędów (Shankar i inni nazywają to dryfem kryteriów w artykule Who Validates the Validators?). Zauważyliśmy, że agenty wywołują kreacje zastępcze
listo rozmiarze 1500 tokenów, co zmusiło nas do karania za nadmierną liczbę tokenów i za przywołanie. - Po wprowadzeniu wiarygodnych pomiarów eksperymentuj intensywnie z różnymi implementacjami i pozwól, aby tablica wyników rozstrzygała debaty na temat architektury. Gdy test porównawczy ocenia 5000 zapytań w kilka sekund,nie musisz się spierać w PR-ach o to, czy 7-wierszowa pętla
Int8może pokonać transformator o rozmiarze 23 MB. Wypróbuj 5 podejść w jedno popołudnie i wybierz najlepsze.
Cały kod (w tym kod osadzający, destylujący i testujący) jest oczywiście open source.