


Publicado em: 12 de novembro de 2026
Esta semana, lançamos o Modern Web Guidance 1.0, uma habilidade de código aberto que ajuda os agentes de programação a usar recursos modernos da plataforma da Web em vez de soluções alternativas legadas. Nesta postagem, vamos analisar o mecanismo de pesquisa local que encontra o guia mais relevante para sua tarefa, sem desperdiçar tokens.
Se você disser a um engenheiro que criou uma base de conhecimento com 1,7 MB de texto Markdown para o agente de programação dele, ele vai fazer duas perguntas:
- "Quantos tokens isso vai despejar na minha janela de contexto?"
- "Que tipo de banco de dados vetorial inchado ele exige?"
Nos últimos seis meses, reconstruímos nosso mecanismo de recuperação local três vezes. Passamos de 507 MB de vinculações em C++ para 23 MB de JavaScript puro usando o TensorFlow.js e, em seguida, para um pacote de 7 MB em que o embedding de consulta é um loop for de 7 linhas, tudo isso melhorando a precisão.
RAG agêntica e divulgação progressiva
Não é prático despejar 1,7 MB de texto Markdown com mais de 200 guias de HTML/CSS/API da Web em AGENTS.md. Acreditamos na divulgação progressiva, mas sabemos que um índice Markdown deixará de ser eficiente em termos de tokens em grande escala.
Para resolver isso, usamos a RAG agêntica com o suporte de uma CLI de pesquisa:
- Em repouso, o agente só vê a descrição da habilidade (~205 tokens). A descrição segue as diretrizes de acionamento de habilidades da Anthropic para que o agente invoque a habilidade em tarefas de front-end relevantes.
- Em tarefas de front-end, o agente pode usar a CLI para pesquisar:
modern-web-guidance search "animate height auto", recebendo 10 correspondências relevantes (~530 tokens). - O agente executa
modern-web-guidance retrieve animate-to-intrinsic-sizespara extrair todo o guia (cerca de 800 tokens). Agora, ele está equipado com as práticas recomendadas de implementação para compatibilidade, substitutos e técnica.
Por que uma habilidade da CLI em vez de um servidor MCP ou uma pesquisa na Web?
- As ferramentas do MCP desperdiçam tokens ou têm mecanismos de acionamento não confiáveis (devido à descoberta dinâmica de ferramentas). A descrição da habilidade é otimizada para máxima eficácia e permite que o agente consuma orientações apenas quando apropriado.
- A pesquisa na Web integrada mostra respostas do Stack Overflow de 2015 e documentos de referência, em vez de padrões de implementação atualizados e selecionados do
DO/DO NOT. Além disso, leva segundos na rede e falha em sandboxes off-line, enquanto a CLI local é executada na CPU em milissegundos.
Geração 1: o protótipo em C++ de 507 MB
A primeira versão do Modern Web Guidance usava uma pilha RAG local: LanceDB, Apache Arrow e Transformers.js com onnxruntime-native.
Funcionou bem em uma máquina de desenvolvimento, mas não se encaixou bem como uma habilidade de agente:
- Ao adicionar uma habilidade a um projeto (ou quando um agente a invoca com
npx), você não espera que umnpm installfaça o download de binários.nodedependentes da arquitetura ou que uma compilação C++node-gypfalhe rotineiramente em sandboxes de nuvem. - O diretório
node_modulesextraído tinha 507 MB.
Geração 2: reduzir o TensorFlow.js para 23 MB
Queríamos zero compilação nativa e execução instantânea em qualquer lugar em que o Node seja executado. Por isso, em abril, substituímos a pilha nativa por um mecanismo de CPU em JavaScript puro que executa all-MiniLM-L6-v2 no @tensorflow/tfjs:
- Remoção de
onnxruntime-nodeem esbuild e substituição do tokenizador do Hugging Face por um tokenizador BERT WordPiece pequeno na árvore (0 incompatibilidades de ID de token). - Depois de explorar o mapa de origem, reduzimos os mais de 400 módulos do
@tensorflow/tfjs-backend-cpupara os 26 kernels que o MiniLM realmente usa, reduzindo o mecanismo JS de 6 MB para 830 KB. - O LanceDB foi descartado para vetores compactados com gzip no momento da criação e uma verificação de produto escalar
<1 msna memória em todos os cerca de 200 guias. - Coloque o incorporador atrás de uma chamada
import()para queretrieveelistterminem em menos de dez milissegundos.
Isso reduziu o pacote npm para 23 MB sem dependências de execução. Nós o enviamos, e os agentes realizaram cerca de 750.000 pesquisas nele.
Onde o MiniLM falhou na produção
Alguns meses depois, analisamos as trajetórias em que os agentes tinham a habilidade instalada, mas ainda escreviam código legado.
Em uma execução do Codex, um desenvolvedor pediu uma solicitação de confirmação de exclusão. Temos um guia completo sobre como criar modais de confirmação acessíveis com HTML <dialog closedby="any">.
O agente fez a coisa certa e pesquisou:
npx modern-web-guidance@latest search "confirm destructive action"
A CLI retornou []. Então, o agente deu de ombros e escreveu window.confirm().
Por que ela retornou vazia? Quando analisamos os registros e os embeddings, duas lacunas de recuperação se destacaram:
- O
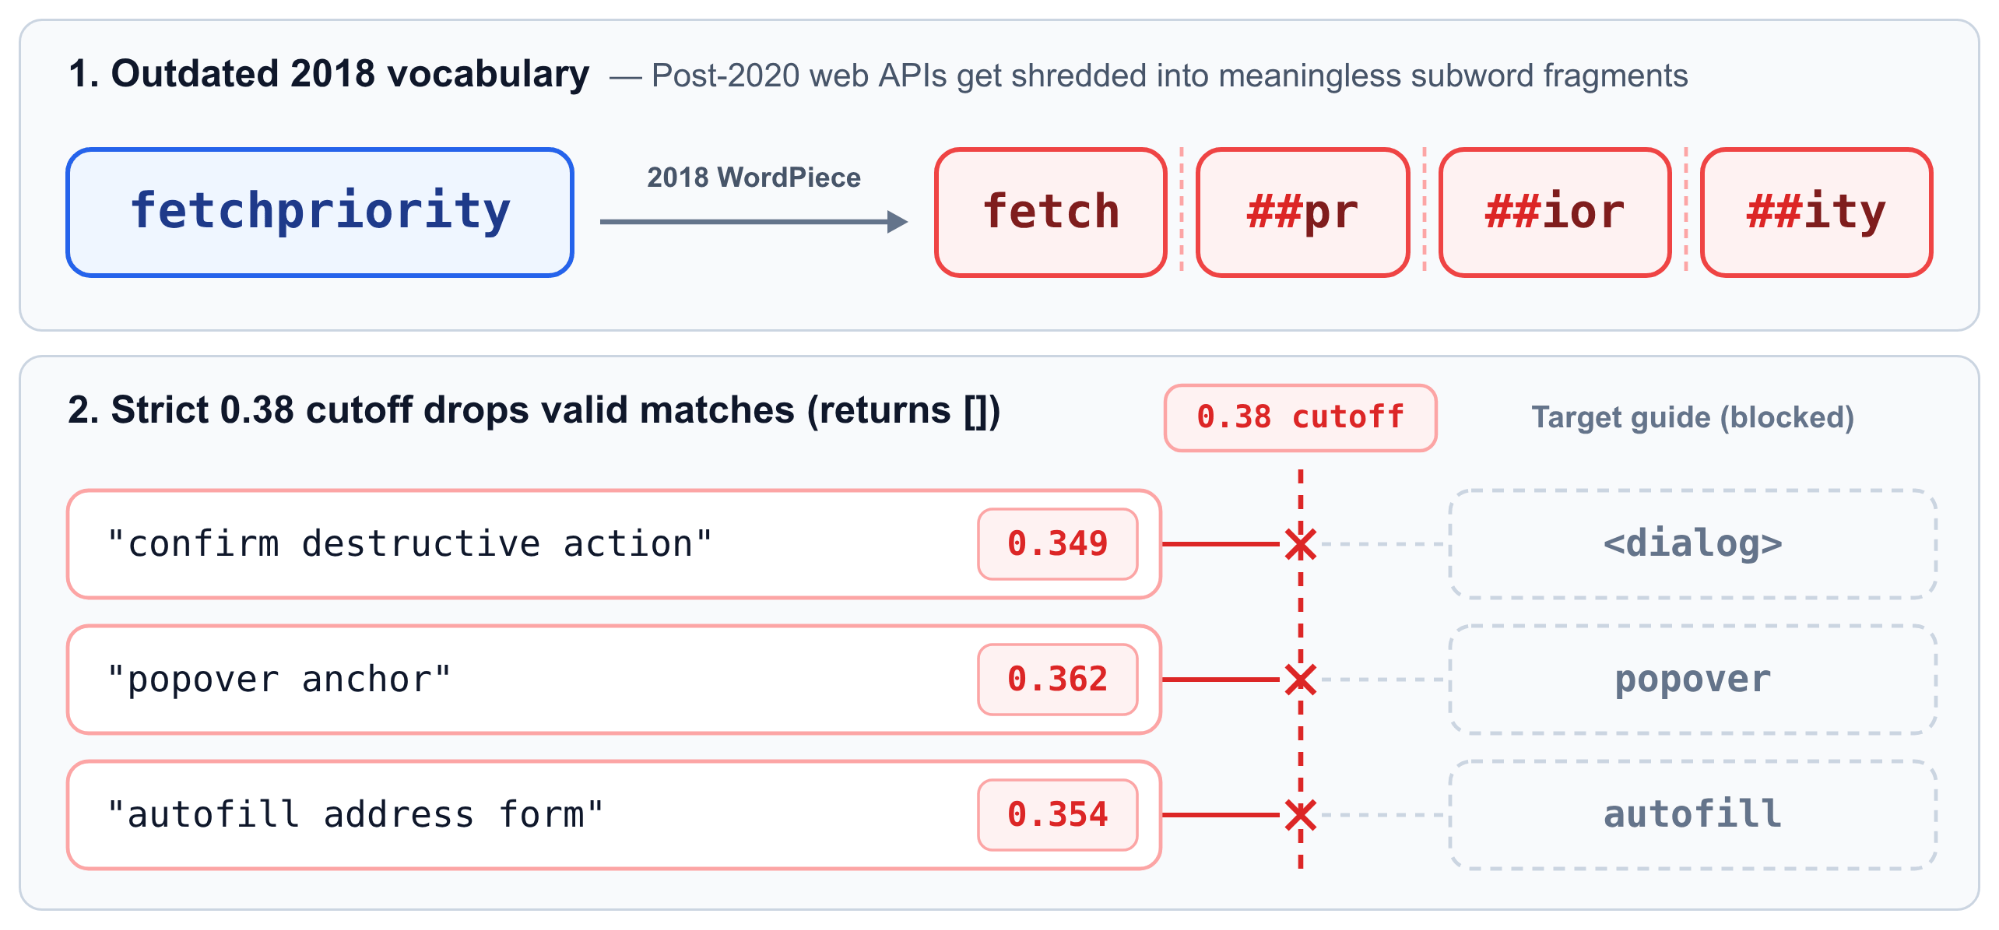
all-MiniLM-L6-v2foi treinado entre 2018 e 2020, então o vocabulário do WordPiece literalmente não sabe que as APIs da Web pós-2020 existem. Quando um agente pesquisafetchpriority,popoveroustartViewTransition, o tokenizador de 2018 dividefetchpriorityem quatro subpalavras sem sentido:fetch·##pr·##ior·##ity. - Para evitar que consultas fora do escopo retornem guias aleatórios, uma solicitação de envio anterior adicionou um limite estrito de similaridade de cosseno de
0.38. Como o MiniLM não conseguiu conectar a frase de três palavras"confirm destructive action"a"dialog"acima de0.38(pontuação0.349, enquanto"popover anchor"recebeu0.362e"autofill address form"recebeu0.354), o portão descartou as correspondências válidas. Pior ainda, sempre quesearchretornava[], as instruções de habilidade diziam ao agente para usarmodern-web-guidance list, despejando todas as cerca de 200 descrições de guias (~1.500 tokens desperdiçados) no contexto.
Como corrigir a recuperação: telemetria real, pesquisa híbrida e retorno de 10 resultados
Nosso comparativo original era de 850 consultas sintéticas geradas com base nos próprios guias, que correspondiam muito à frase do guia para detectar essas falhas. Por isso, criamos um novo conjunto de avaliação (pnpm benchmark:rag) com cerca de 4.000 Pesquisas Live amostradas da telemetria da CLI (que registra apenas o argumento search de 2 a 5 palavras do agente, nunca os comandos do usuário ou o código do repositório, e respeita DISABLE_TELEMETRY=1), além de 1.029 pesquisas extraídas de avaliações noturnas do agente no Claude Code, na Codex CLI e na CLI do Gemini.
Ao reproduzir nosso histórico do Git em relação a essas consultas retidas, mostramos que o corte de 0.38 havia aumentado as respostas vazias de [] em 8 vezes. Com o comparativo de mercado em vigor, fizemos duas melhorias rápidas antes de tocar no modelo de embedding:
- Pesquisa híbrida de palavras-chave + pesquisa semântica: os vetores densos confundem nomes de APIs exatos (
:user-invalid,showModal,details-name), enquanto a pesquisa de palavras-chave não encontra consultas de intent quando o agente não sabe o nome da API. Adicionamos um índice de palavras-chave BM25 (se você sabe, sabe) com zero dependência e derivação de plural, indexamos oweb-feature-idsde cada guia e fundimos o BM25 com a classificação semântica. Agora,searchsó retorna[]quando a similaridade semântica é<0.30e o BM25 não tem correspondências de palavras-chave. - 10 resultados compactos em vez de 5 detalhados: as instruções de habilidade já diziam aos agentes para ignorar
similarityetokenCount. Ao remover esses campos não utilizados, conseguimos incluir 10 resultados compactos do{id, description}no mesmo orçamento de aproximadamente 530 tokens que 5 resultados detalhados:
// Before: 5 verbose results (~105 tokens each = ~525 tokens)
{
  "id": "dialog",
  "category": "html",
  "description": "Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby.",
  "featuresUsed": ["dialog", "dialog-closedby"],
  "tokenCount": 780,
  "similarity": 0.49
}
// After: 10 compact results (~53 tokens each = ~530 tokens)
{"id":"dialog","description":"Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby."}
Juntas, essas duas mudanças aumentaram nossa taxa de acerto de pesquisa em consultas de telemetria retidas de 80,6% para 94,7%, medida como Hit@K (se o guia esperado aparece nos principais resultados de K).
Geração 3: embeddings pré-criados e um loop for de sete linhas
Mesmo com uma taxa de acerto de 94.7%, nossa telemetria mostrou uma incompatibilidade gritante: 86,7% das pesquisas de agentes humanos tinham apenas de 2 a 5 palavras (mediana: 3 palavras). Toda vez que um agente pesquisava uma frase de três palavras, o Node inicializava o TensorFlow.js, analisava uma rede neural de 22, 6 MB e consumia 770 ms de latência de inicialização a frio e 346 MB de pico de RAM.
Quando perguntamos se havia uma maneira mais leve de incorporar consultas de três palavras sem uma rede neural, nosso agente do Antigravity voltou com uma pilha de técnicas de destilação de ML desconhecidas: Model2Vec, Tokenlearn, dimensões Matryoshka, Adagrad. Se quiser saber mais detalhes técnicos, acesse nossa página de qualidade da pesquisa.
A RAG local padrão força os documentos e as consultas a passarem pelo mesmo modelo pequeno na CPU do usuário. Mas nossos cerca de 200 guias não mudam depois que lançamos uma versão do npm. Por isso, não há motivo para incorporá-los a um modelo pequeno de 2018. Em vez disso, o embed-guide-chunks.ts pré-processa todos os nossos vetores de guia no momento do lançamento na nuvem usando o gemini-embedding-001 e os envia como vetores Int8 binários de 256 dimensões (guide-chunks.i8, 335 KB compactados com gzip).
Como um projeto de CLI off-line, sem chave de API, projeta a consulta em tempo real de um usuário nesse mesmo espaço vetorial do Gemini? Como as consultas de agentes quase sempre têm de duas a cinco palavras, não precisamos de um transformador no ambiente de execução. Só precisamos de uma tabela de consulta de vetores para palavras conhecidas (table) e uma maneira inteligente de somá-los. No ambiente de execução, todo o pipeline de 23 MB do TensorFlow.js é reduzido a um loop for de sete linhas em static-embedder.ts:
// Each word's weight and Int8 scale are pre-folded into `scales[i]`
for (const [i, f] of enc) {
  const wt = scales[i] * f;
  const offset = i * 256;
  for (let k = 0; k < 256; k++) {
    out[k] += wt * table[offset + k];
  }
}
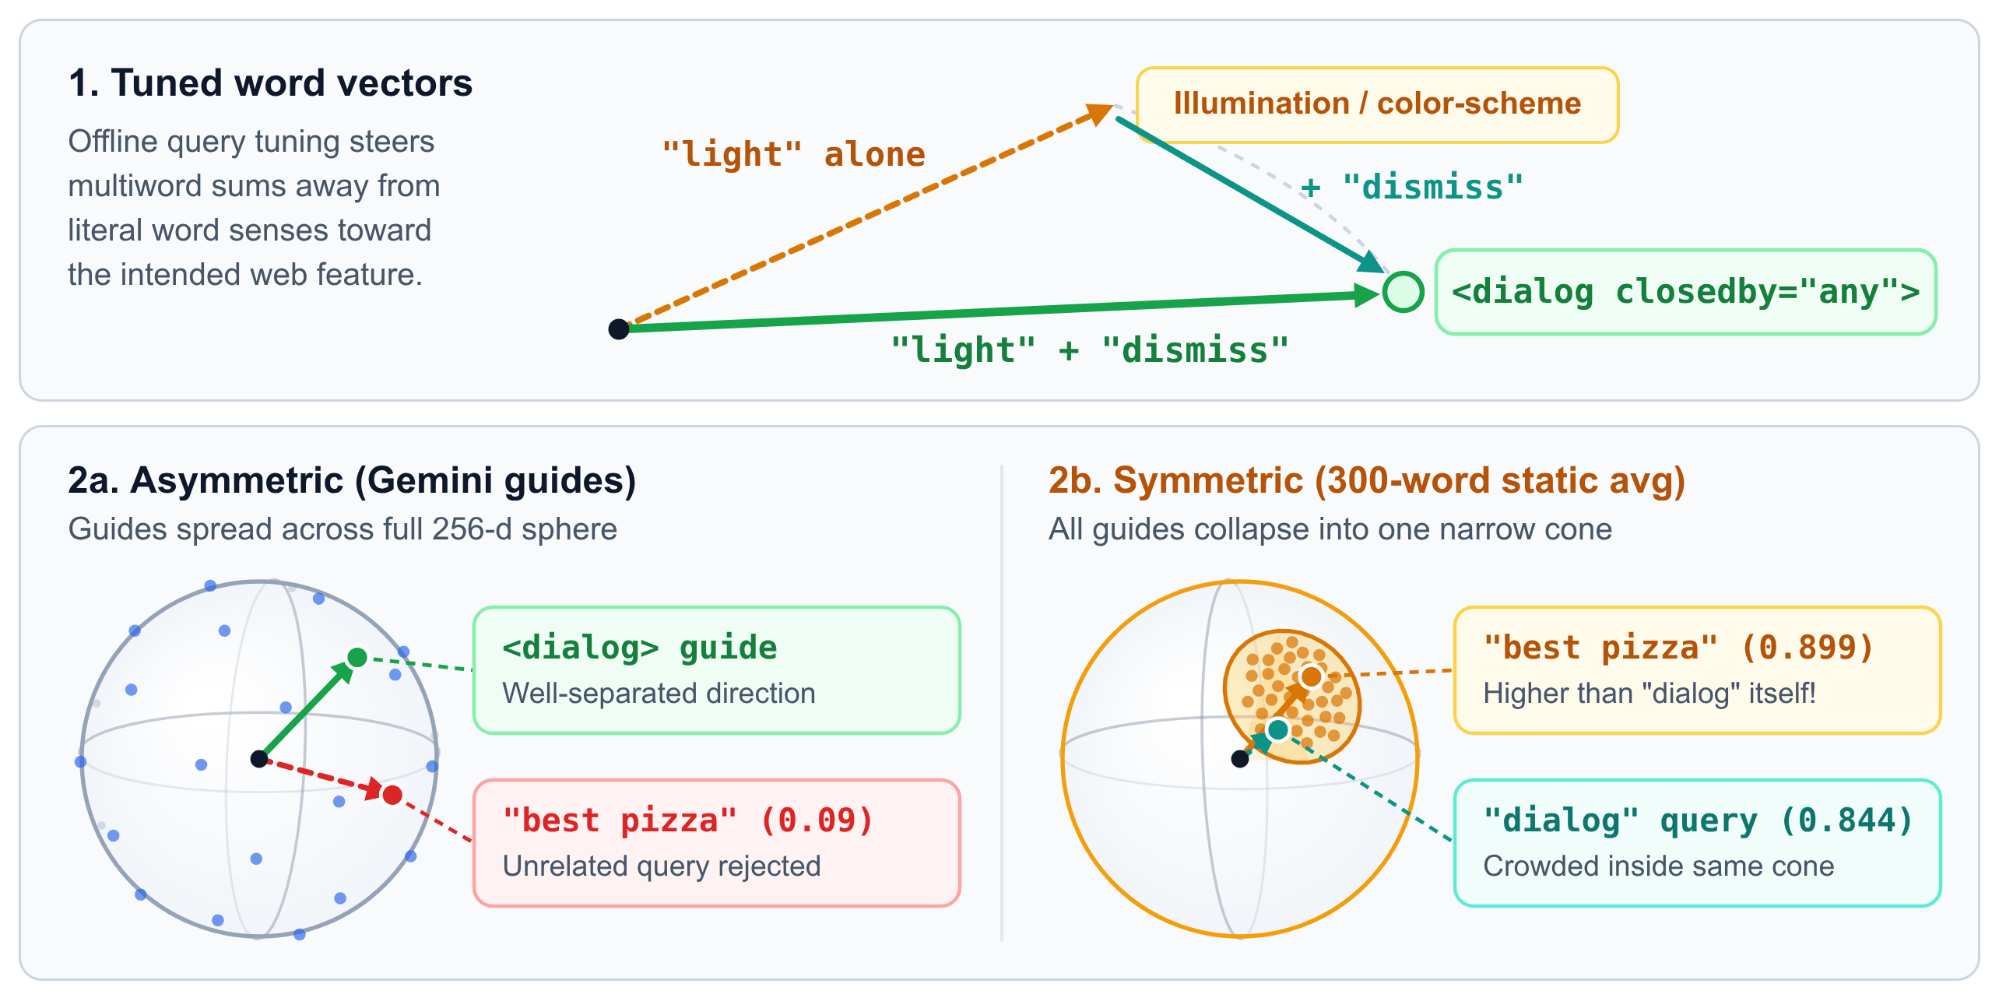
Para criar essa tabela de consulta (train-query-words.ts), usamos um vocabulário de 29.165 palavras (em que termos modernos da Web, como fetchpriority, light-dismiss, popover e scrollytelling, são palavras inteiras independentes), incorporamos essas palavras com gemini-embedding-001 e ajustamos os vetores de palavras off-line em relação a 33.000 consultas reais da Web para que as combinações de várias palavras fiquem no lugar certo (por exemplo, "light" + "dismiss" aponta para <dialog closedby="any">, não para iluminação ou esquemas de cores). Compactada para Int8 (query-words.i8), a tabela de consulta inteira é compactada com gzip em 5.3 MB.
Por que não usar essa tabela de consulta estática para incorporar os guias também e pular a etapa do Cloud Build? Tentamos isso primeiro, mas não funcionou com parágrafos completos: somar três palavras de consulta funciona bem, mas calcular a média de centenas de palavras em um guia inteiro faz com que todos os guias se concentrem em um intervalo estreito perto da média genérica do inglês. Isso chegou ao ponto em que "best pizza in new york" teve uma similaridade de cosseno de 0.899 com nosso guia de dialog, maior do que a própria consulta "dialog", que foi de 0.844. Combinar pesquisas de consulta estáticas de três palavras (query-words.i8) com embeddings de guias do Gemini de modelo completo (guide-chunks.i8) nos dá uma precisão de nível de nuvem, enquanto as consultas ainda são executadas off-line em 30 µs.
O placar das três gerações
Ao longo dos nossos marcos de lançamento, o Hit@K aumentou de 78,2% com embeddings de documentos inteiros para 95,4% com o incorporador estático Int8 (em comparação com 96,9% com as APIs do Cloud gemini-embedding-001):
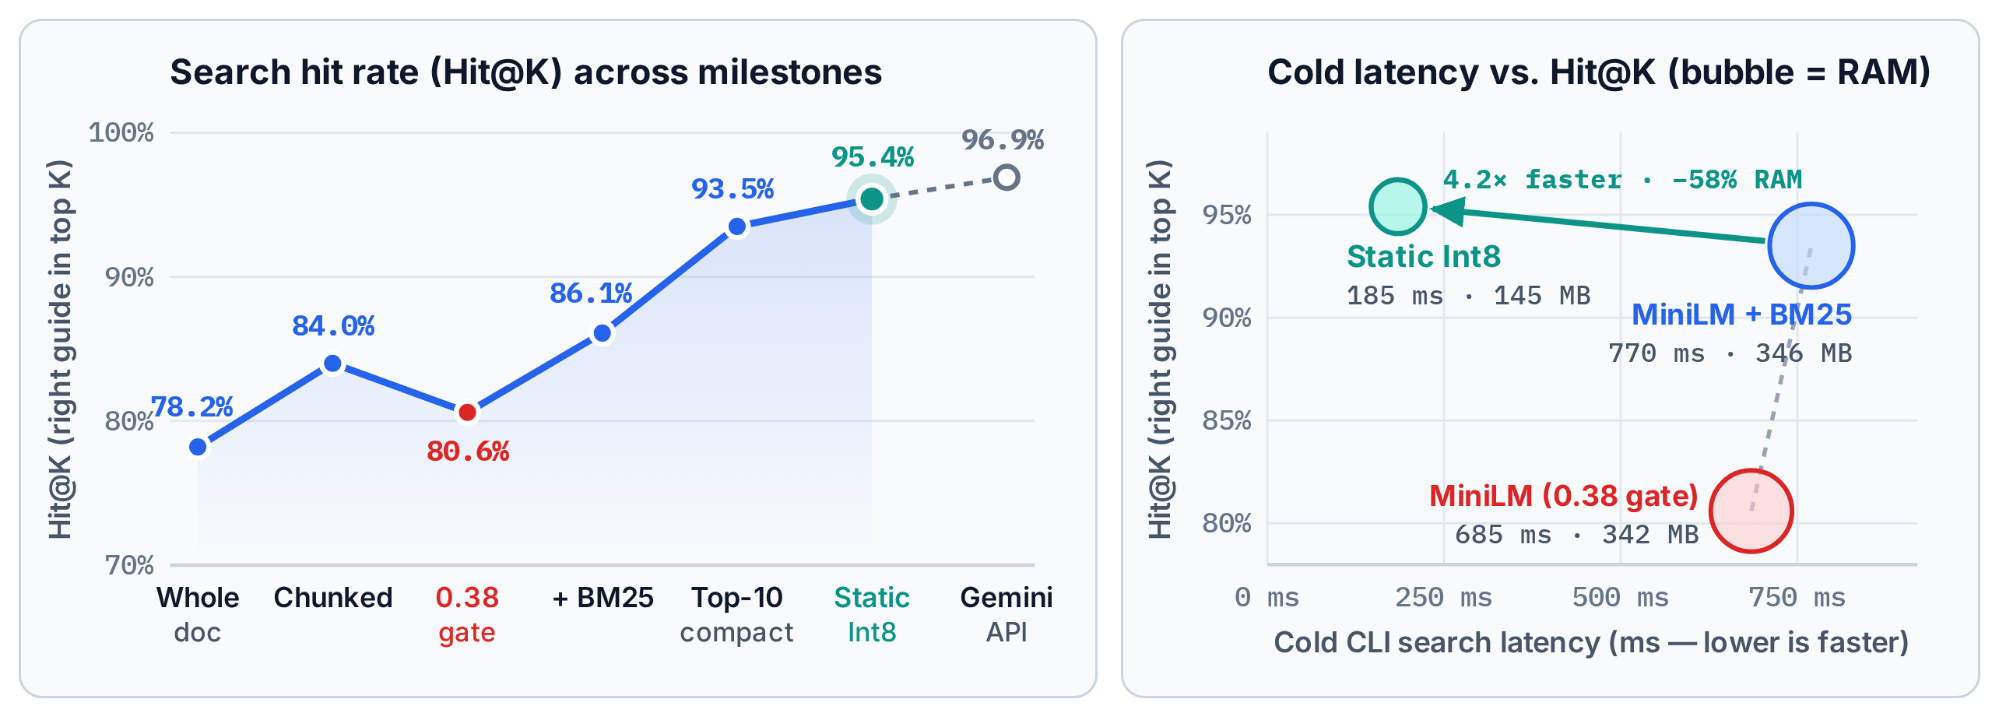
Veja como as três gerações se comparam após o lançamento do incorporador estático:
E se você executar aquela consulta do Codex que não funcionou:
npx modern-web-guidance@latest search "confirm destructive action"
O guia dialog volta para o topo da lista.
(Você pode conferir os gráficos interativos de todos os marcos, tamanhos de consulta e horizontes K no nosso Painel de Qualidade da Pesquisa.)
O código é barato; o trabalho é medir
Um agente pode escrever um classificador BM25 ou um script de destilação de vetor de palavras em minutos. A geração de implementações candidatas não é mais o gargalo. Saber se uma mudança realmente ajudou (ou se quebrou silenciosamente 9% das pesquisas de produção, como aconteceu com o portão 0.38) é quase todo o trabalho.
Veja como abordamos esse sistema:
- Defina o objetivo principal e invista no conjunto de medição em vez de uma única implementação. Passamos muito mais tempo criando o
pnpm benchmark:rag, selecionando 5.000 consultas reais e calibrando nossa classificação automatizada em relação às classificações humanas do que escrevendo qualquer recuperador. - Crie uma rubrica para que você e seus agentes avaliem a qualidade e esperem que ela evolua quando atingir dados reais. As pessoas chamam isso de "medição em primeiro lugar", o que é apenas metade da verdade: você pode escrever verificações básicas de respostas conhecidas no primeiro dia, mas não pode criar uma boa rubrica no vácuo antes de inspecionar falhas reais (Shankar et al. chamam isso de desvio de critérios em Who Validates the Validators?). Ver os agentes acionarem substitutos de 1.500 tokens
listfoi o que nos forçou a penalizar o excesso de tokens junto com o recall. - Com medições confiáveis, teste diferentes implementações e deixe que o placar resolva os debates sobre arquitetura. Depois que um comparativo de mercado avalia 5.000 consultas em segundos, você não precisa mais discutir em PRs se um loop
Int8de 7 linhas pode superar um transformador de 23 MB. Teste cinco abordagens em uma tarde e mantenha a vencedora.
Todo o código (incluindo o incorporador, o destilador e o harness de comparativo de mercado) é de código aberto, é claro.