


Opublikowano: 11 listopada 2026 r.
W tym tygodniu opublikowaliśmy wersję 1.0 Przewodnika po współczesnych technologiach internetowych, czyli zestawu umiejętności, które pozwalają agentom kodującym korzystać bezpośrednio z wiedzy o platformie internetowej, sprawdzonych metod i danych o zgodności z przeglądarkami. Naszym celem w przypadku Przewodnika po współczesnych technologiach internetowych jest pomoc deweloperom korzystającym z agentów kodowania AI w pełnym wykorzystaniu możliwości nowoczesnej platformy internetowej, co ostatecznie poprawi wrażenia użytkowników.
Od czasu, gdy w maju po raz pierwszy udostępniliśmy wczesną wersję przedpremierową Przewodnika po współczesnych technologiach internetowych, agenty kodujące stają się coraz lepsze i pojawiło się wiele niesamowitych nowych modeli granicznych. Jednym z najczęściej zadawanych pytań jest: czy te nowe modele graniczne nie stosują już sprawdzonych metod tworzenia stron internetowych?
Niestety odpowiedź brzmi „nie” – i wiemy, że tak jest, ponieważ to sprawdziliśmy.
Każdy przewodnik po współczesnych technologiach internetowych definiuje zestaw oczekiwań, które muszą zostać spełnione, jeśli sprawdzone metody opisane w przewodniku zostały prawidłowo zastosowane. Nasz pakiet ewaluacyjny testuje te przewodniki, przekazując tego samego prompta agentowi z zainstalowanym Przewodnikiem po współczesnych technologiach internetowych (agent z przewodnikiem) i innemu agentowi bez zainstalowanego Przewodnika po współczesnych technologiach internetowych (agent bez przewodnika). Dane wyjściowe obu uruchomień są sprawdzane pod kątem oczekiwań określonych w przewodniku.
Porównując wskaźniki zdawalności w przypadku testów z instrukcjami i bez nich, można zauważyć, że modele AI – nawet najnowsze modele graniczne – nie zawsze samodzielnie stosują sprawdzone metody tworzenia nowoczesnych stron internetowych.
Średnio agenty kodowania bez wskazówek przechodzą tylko około 50% testów w naszym pakiecie ewaluacyjnym, podczas gdy przy użyciu Przewodnika po współczesnych technologiach internetowych jest to około 90%.
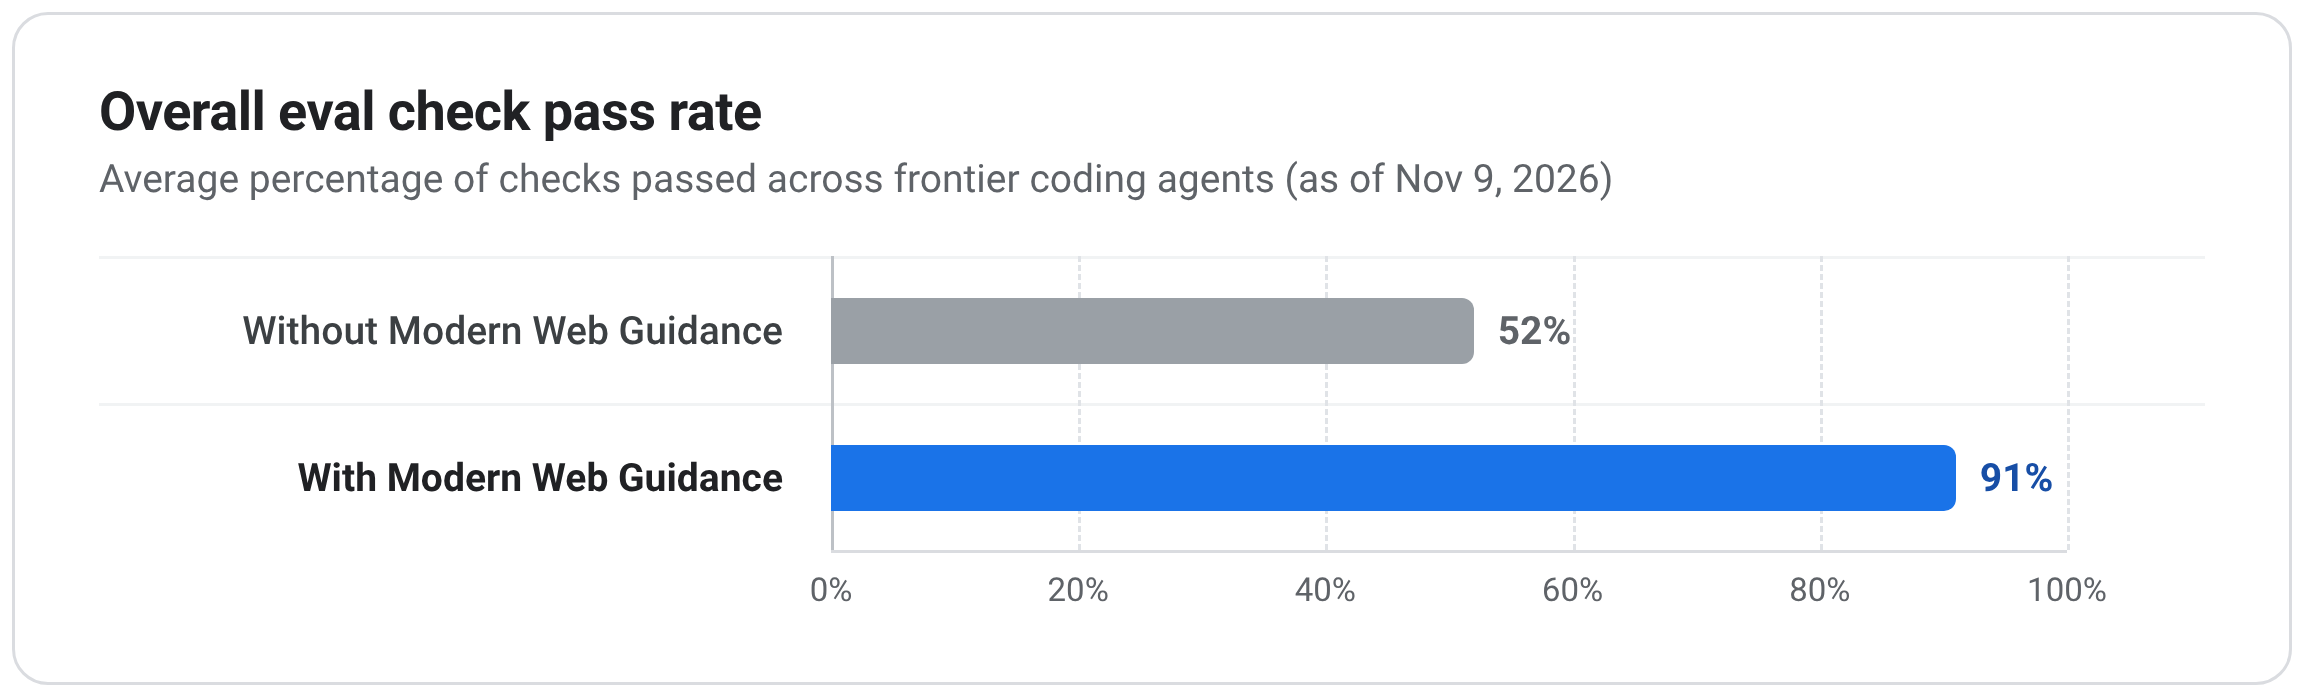
Możesz sprawdzić nasz panel oceny, aby zobaczyć pełną listę konkretnych testów, które przeprowadzamy w przypadku każdego przewodnika, oraz wyniki poszczególnych modeli.
W tym poście przedstawiamy 10 najbardziej problematycznych obszarów, w których modele AI stale popełniają błędy, w kluczowych dyscyplinach, z którymi programiści stron internetowych najczęściej spotykają się w codziennej pracy, takich jak ułatwienia dostępu, wrażenia użytkownika, wydajność i bezpieczeństwo.
1. Ułatwienia dostępu: zaznaczenie klawiatury i zarządzanie inert
W przypadku osób, które poruszają się po interfejsie za pomocą klawiatury lub czytnika ekranu, przewidywalna kolejność zaznaczania elementów jest kluczowa dla użyteczności interaktywnych interfejsów użytkownika. Bez tego fokus może przechodzić do ukrytych treści w tle lub zatrzymywać się na dziesiątkach dodatkowych pozycji tabulacji.
Zarządzanie fokusem i inert to jeden z największych problemów z ułatwieniami dostępu w naszych ocenach i jeden z obszarów, który najbardziej poprawia się dzięki Przewodnikowi po współczesnych technologiach internetowych. Najczęstsze błędy to:
- Nie przenoszą zaznaczenia do nowo otwartych widoków i zapominają o przywróceniu zaznaczenia na elemencie wyzwalającym podczas powrotu.
- Poleganie na ręcznych pułapkach kart JavaScript i
aria-modal="true"w niestandardowych oknach modalnych zamiast używania okna modalnego<dialog>lub oznaczania treści w tleinert. - Udostępnianie każdego elementu na pasku narzędzi lub w siatce kierunkowej jako osobnego punktu tabulacji zamiast używania pojedynczego punktu tabulacji z ruchomym atrybutem
tabindex. - tworzenie niestandardowych konturów
:focus-visible, które nie mają współczynnika kontrastu 3:1 w stosunku do sąsiadujących teł;
2. Ułatwienia dostępu: obsługa ograniczonego ruchu
Nieoczekiwany ruch strony i animacje na dużą skalę nie tylko rozpraszają uwagę, ale u użytkowników z zaburzeniami przedsionkowymi lub wrażliwością na ruch mogą wywoływać zawroty głowy, nudności lub bóle głowy.
Modele AI zwykle pamiętają o sprawdzeniu, czy prefers-reduced-motion, gdy dodają standardowe przejścia CSS lub animacje klatek kluczowych. Jednak podczas korzystania z nowszych funkcji, takich jak płynne przewijanie, przejścia widoku czy animacje sterowane przewijaniem, często zapominają o ograniczeniu ruchu lub popełniają błędy podczas wdrażania:
- Ustawianie
scroll-behavior:smoothglobalnie i bezwarunkowo w elemencie głównym. - Używanie animacji CSS opartych na przewijaniu bez sprawdzania, czy ruch jest ograniczony.
- Usunięcie czasu trwania
transitionw elementach karuzeli, aby ograniczyć ruch podczas przewijania, ale zapomnienie o usunięciu właściwości przekształcenia, co powoduje, że elementy zmieniają rozmiar podczas przewijania. - Zastosowanie ogólnego resetowania czasu trwania
0.01msw przypadku*,*::beforei*::after, gdy aktywny jest ograniczony ruch, co powoduje usunięcie wszystkich niezbędnych przejść bez ruchu (potrzebnych do komunikowania zmian stanu interfejsu). - Włączanie przejść między dokumentami bezwarunkowo i zastępowanie animacji
::view-transition-*, gdy aktywny jest ograniczony ruch, zamiast ograniczania reguły@view-transitiondo sprawdzania ograniczonego ruchu.
3. Ułatwienia dostępu: sprawdzanie poprawności formularza, wskazówki dotyczące formatu i stany autouzupełniania
Formularze są podstawą najważniejszych ścieżek użytkowników w internecie. Niewielki problem z formularzem płatności może mieć duży wpływ na wyniki finansowe firmy.
Podczas tworzenia formularzy modele AI dobrze radzą sobie z podstawowymi kwestiami. Często jednak nie uwzględniają drobnych, ale istotnych szczegółów, takich jak błędy weryfikacji, prawidłowe umieszczanie obiektów zastępczych i wskazówek dotyczących formatu oraz prawidłowa integracja z menedżerami haseł i funkcjami autouzupełniania:
- Ponowne wdrożenie CSS
:user-invalidz niestandardową weryfikacją JavaScriptublur, która często oznacza niezmienione polarequired, gdy tylko użytkownicy przejdą obok nich za pomocą klawisza Tab. - Utrata synchronizacji
aria-invalidz widocznymi błędami, przedwczesne ustawieniearia-invalid="true"nablurlub stylizowanie:user-invalidw CSS bez synchronizacjiaria-invalidw JavaScript. - Poleganie na znikającym tekście
placeholder, aby wyświetlić wymagane formaty (np.MM/YYw polu daty ważności karty) zamiast renderowania stałej wskazówki połączonej zaria-describedby. - Umieszczanie wskazówek dotyczących formatu i reguł haseł pod polem
<input>(zamiast nad nim), gdzie mogą zostać zasłonięte przez klawiatury mobilne i wyskakujące okienka autouzupełniania, gdy użytkownik musi je przeczytać. - Wyróżnianie danych wejściowych
:autofillprzez zmianę samego koloru obramowania zamiast połączenia koloru ze wskazówką niekolorową, która nie zmienia układu (np. wstawkabox-shadow).
4. Wrażenia użytkownika: gesty przesuwania i dotykania
Agenty dobrze radzą sobie z implementacją gestów dotykowych za pomocą imperatywnego kodu JavaScript i pisaniem własnej niestandardowej logiki fizyki. Te implementacje działają, ale interakcje dotykowe oparte na JavaScript rzadko są tak płynne, jak oczekują tego użytkownicy aplikacji natywnych.
Wiele z tych interakcji można zaimplementować za pomocą CSS i natywnych interfejsów API przewijania, co pozwala przeglądarce na uruchamianie fizyki gestów poza wątkiem głównym. Jednak w naszych ocenach modele AI często pomijają te funkcje:
- Zaimplementuj gesty przesunięcia w celu odrzucenia lub wyświetlenia za pomocą detektorów
pointermovelubtouchmovezamiast przewijania z przyciąganiem w CSS. - Pominięcie
overscroll-behavior-x:nonew interfejsach z przesuwaniem kart, co może przypadkowo wywołać przejście wstecz lub do przodu w przeglądarce podczas zbyt mocnego przesunięcia. - Efekty postępu przesunięcia są wywoływane w głównym wątku w wywołaniach zwrotnych JavaScriptu zamiast przy użyciu animacji sterowanych przewijaniem.
- Nieprawidłowa obsługa zaznaczenia klawiaturą w panelach z akcjami przesuwania opartymi na przewijaniu.
5. Wrażenia użytkownika: okna, wyskakujące okienka i przejścia w górnej warstwie
W naszych ocenach modele często korzystają z imperatywnych obejść JavaScriptu podczas animowania, odrzucania lub przewijania okien modalnych i wyskakujących okienek.
Zamiast polegać na nowoczesnych funkcjach HTML i CSS stworzonych z myślą o nakładkach w górnej warstwie, agenci często ręcznie tworzą maszyny stanów wejścia i wyjścia, punkty zaczepienia historii i blokady przewijania treści, które są trudniejsze w utrzymaniu i podatne na drobne błędy interfejsu.
Jeśli te interakcje będą działać prawidłowo, mogą zmienić wrażenie niestabilności w dopracowane działanie, któremu użytkownicy ufają. Oto najczęstsze błędy, które obserwujemy:
- Tworzenie niestandardowych nakładek
position:fixedz ręcznymi modułami obsługi kliknięć poza nakładką w celu jej zamknięcia zamiast używaniapopover. - Tworzenie animacji wejścia i wyjścia przez przełączanie klas przejść CSS i koordynowanie ich z detektorami
requestAnimationFrame()itransitionend(z rezerwowymisetTimeout()) zamiast robienia tego w czystym CSS z@starting-styleitransition-behavior. - Blokowanie przewijania strony za otwartym oknem modalnym przez ustawienie
overflow:hiddenna<html>zamiast używania elementu<dialog>do ograniczania przewijania. - Dodanie detektorów
popstatedo wykrywania gestów cofania na Androidzie i zamykania otwartych okien modalnych zamiast używania natywnej funkcji zamykania przyciskiem Wstecz elementu modalnego<dialog>.
6. Wrażenia użytkownika: tryb ciemny i elementy sterujące dostosowane do motywu
Użytkownicy włączają tryb ciemny, aby zmniejszyć zmęczenie oczu i odblaski, więc jasny biały błysk podczas wczytywania strony, nieostylowane elementy sterujące formularza lub przełącznik, który nie jest zsynchronizowany z ustawieniami systemu operacyjnego, natychmiast psują wrażenia.
Przełącznik trybu ciemnego może wydawać się prosty, ale modele bez wskazówek w naszych ocenach konsekwentnie pomijają kluczowe szczegóły platformy potrzebne do prawidłowego przełączania motywów i natywnych elementów sterujących formularzy:
- Brak
<meta name="color-scheme" content="light dark">w<head>, co powoduje, że użytkownicy trybu ciemnego widzą biały błysk podczas ładowania zewnętrznych arkuszy stylów. - Stylizowanie ciemnych motywów lub komponentów z ciemną powierzchnią za pomocą spersonalizowanych kolorów bez ustawiania właściwości
color-scheme, co powoduje, że natywne paski przewijania i elementy sterujące formularza pozostają w trybie jasnym. - Pomijanie funkcji CSS
light-dark()podczas definiowania tokenów kolorów dostosowujących się do motywu, które automatycznie podążają za aktywnymcolor-scheme. - Udostępnianie tylko przełącznika trybu jasnego lub ciemnego, który ustawia wyraźne zastąpienie w aplikacji
localStoragebez możliwości powrotu do domyślnego ustawienia systemu operacyjnego. - Zapomnienie o dodaniu detektora zdarzeń
storage, co powoduje, że inne otwarte karty nie są synchronizowane, gdy użytkownik zmienia motywy.
7. Wydajność: szybkość i płynność działania
Użytkownicy spędzają większość czasu na stronie internetowej po jej wczytaniu, więc powolne interakcje i niestabilne przejścia mogą być dla nich równie uciążliwe jak powolne wczytywanie początkowe.
W naszych testach modele zwykle stosują klasyczne sprawdzone metody dotyczące czasu wczytywania, które od lat są promowane w narzędziach takich jak Lighthouse, i zwykle wiedzą, jak przenieść oczywiste, obciążające pętle do Web Workera. Największe problemy sprawia im responsywność głównego wątku, która jest niezbędna do optymalizacji INP: izolowanie pracy nad układem, planowanie zadań według priorytetu oraz korzystanie z nowych funkcji HTML i CSS, które wykonują renderowanie poza głównym wątkiem.
Na przykład agenci często:
- Używanie niestandardowych kolejek
setTimeout()do zadań w tle lub o niskim priorytecie zamiast nadawania priorytetu zadaniom widocznym dla użytkownika za pomocąscheduler.postTask()lub korzystania z kontynuacji zadań za pomocąscheduler.yield(), gdy przeglądarka to obsługuje. - tworzenie złożonych układów (np. gęstych siatek danych) bez stosowania
content-visibility:autoicontain-intrinsic-size, co oznacza, że aktualizacje po interakcjach użytkownika powodują ponowne renderowanie całej strony; - Ukrywanie nieaktywnych widoków SPA za pomocą
display:none(lub ich usuwanie) zamiast używaniacontent-visibility:hidden(w połączeniu zinert). Pierwsza metoda niszczy stan renderowania w pamięci podręcznej, więc powrót powoduje pełne renderowanie układu i wyświetlanie. - Wstrzymywanie animacji
<canvas>poza ekranem i pętli w tle za pomocą wywołań zwrotnych Intersection Observer zamiast parowaniacontent-visibility:autoze zdarzeniemcontentvisibilityautostatechange(jeśli jest dostępne), co powoduje pominięcie marginesu wstępnego renderowania przeglądarki, zanim elementy zostaną przewinięte do widoku. - Tworzenie wskazówek interfejsu dotyczących możliwości przewijania za pomocą detektorów zdarzeń
scroll, które wymuszają ciągłe obliczenia układu, zamiast używania zapytań o stan przewijania CSS, gdy są dostępne (z zastępczymi obserwatorami przecięcia).
8. Wydajność: przesunięcia układu i migotanie obrazu
Nieoczekiwane przesunięcia układu rozpraszają czytelnika i mogą spowodować, że kliknie on nieoczekiwane przyciski – czasem z nieodwracalnymi konsekwencjami.
Modele niezawodnie dodają atrybuty width i height do standardowych elementów <img>, aby zapobiegać przesunięciom układu, ale konsekwentnie pomijają inne typowe źródła przesunięć układu i błysków przed renderowaniem z elementów <video>, zamian czcionek internetowych, pasków narzędzi przeglądarek mobilnych i eksperymentów po stronie klienta – wszystkie te czynniki mogą wpływać na CLS.
- pominięcie jawnych atrybutów
widthiheightw elementach<video>(co powoduje, że niezaładowane odtwarzacze mają domyślnie wartość300×150i zmieniają układ po załadowaniu metadanych) lub stylizowanie elementów opakowania multimediów zamiast ustawiania atrybutówaspect-ratioiobject-fitbezpośrednio w elementach multimediów. - Parowanie czcionek internetowych z czcionkami zastępczymi systemu bez
font-size-adjust, co powoduje, że akapity i nagłówki są widocznie przeformatowywane, gdy czcionki internetowe są zamieniane. - Używanie statycznych jednostek
vhzamiast dynamicznych lub małych jednostek widocznego obszaru (dvh,svh) do określania rozmiaru sekcji hero i układów pełnoekranowych, co powoduje przeskakiwanie treści podczas rozwijania i zwijania pasków narzędzi przeglądarki mobilnej. - Ukrywanie treści za pomocą starszych fragmentów kodu
opacity:0lubvisibility:hiddenzapobiegających migotaniu i kilkusekundowych limitów czasu w przypadku testów A/B po stronie klienta (opóźnianie LCP i pozostawianie niewidocznych elementów jako klikalnych) zamiast używania skryptów zblocking="render", gdy są dostępne. - Uruchamianie przejść między widokami dokumentów przed przeanalizowaniem krytycznych znaczników części strony widocznej na ekranie zamiast wstrzymywania pierwszego renderowania za pomocą
rel="expect"iblocking="render", co powoduje, że częściowo przeanalizowane elementy pojawiają się w połowie przejścia.
9. Bezpieczeństwo: ochrona przed atakami typu DOM XSS i sanityzacja kodu HTML
Pojedyncza luka w zabezpieczeniach typu cross-site scripting (XSS) umożliwia atakującemu uruchomienie dowolnego kodu w przeglądarkach użytkowników, kradzież danych sesji lub podejmowanie działań w ich imieniu. Dlatego tak ważne są zabezpieczenia wymuszane przez przeglądarkę, takie jak bezpieczne czyszczenie kodu HTML, typy zaufane i ścisłe zasady CSP.
Modele rzadko proaktywnie rozwiązują te problemy z bezpieczeństwem. Na przykład w przypadku wszystkich zadań w naszym pełnym pakiecie ewaluacyjnym modele nie dodawały nagłówka Content Security Policy (CSP) ani nagłówka izolacji od zasobów z innych domen bez wyraźnego polecenia.
Nawet gdy prompty bezpośrednio proszą o bezpieczeństwo, modele bez wskazówek nadal nie przechodzą ponad połowy naszych kontroli bezpieczeństwa, sięgając po niestabilne niestandardowe rozwiązania zastępcze lub niekompletne zasady. Widać to wyraźnie podczas obrony przed DOM XSS:
- Pisanie własnych modułów do oczyszczania danych na liście dozwolonych
DOMParser– jako zastępczychsetHTML()lub w ramach zasad typów zaufanych – zamiast używania sprawdzonej biblioteki, takiej jak DOMPurify, gdy natywne oczyszczanie danych jest niedostępne. - Zamiast używać natywnego interfejsu
setHTML(), gdy jest obsługiwany, i ładować DOMPurify tylko jako rozwiązanie zastępcze, ładujesz DOMPurify przy każdym wczytaniu strony. - Rejestrowanie zezwalających zasad zaufanych typów przekazywania (
(input) => input), które osłabiają egzekwowanie ujścia. - Połączenie zaufanych typów na stronach statycznych z zasadami CSP
script-src 'self'z listą dozwolonych hostów zamiast blokowania skryptów wbudowanych za pomocą skrótów SHA-256. - Pominięcie
'strict-dynamic'i'report-sample'podczas konfigurowaniascript-srczasad Content Security Policy opartych na liczbie jednorazowej.
10. Bezpieczeństwo: logowanie za pomocą klucza dostępu, ponowne uwierzytelnianie i cykl życia danych logowania
Klucze dostępu zwiększają bezpieczeństwo użytkowników i liczbę konwersji polegających na logowaniu się w przypadku firm, ale ich wdrażanie (nawet z pomocą agentów) jest trudne.
WebAuthn ma określone interfejsy API do serializacji, wykrywania możliwości i sygnalizacji, które modele bez wskazówek prawie całkowicie pomijają w naszych testach. Jeśli poprosisz model AI o dodanie logowania za pomocą klucza dostępu, zarządzania nim lub ponownego uwierzytelniania, często napisze on ręczne funkcje pomocnicze kodowania bajtów, pominie sprawdzanie możliwości w interfejsie zarządzania lub pozostawi dane logowania niezsynchronizowane z menedżerami haseł:
- Ręczne tworzenie funkcji pomocniczych do konwersji
atob()ibtoa()na Base64URL – jako ścieżki głównej lub nadmiarowego kodu zastępczego – zamiast polegania na wbudowanych metodach serializacji, takich jakparseCreationOptionsFromJSON(),parseRequestOptionsFromJSON()icredential.toJSON(). - pomijanie
PublicKeyCredential.signalUnknownCredential()podczas logowania, gdy serwer zgłasza nieznany identyfikator danych logowania, co powoduje pozostawienie usuniętych lub unieważnionych kluczy dostępu w menedżerach haseł użytkowników; - Pomijam
PublicKeyCredential.getClientCapabilities()przed renderowaniem interfejsu tworzenia kluczy dostępu i zarządzania nimi. - Pominięcie parametrów
AbortControlleriAbortSignalpodczas rozpoczynania żądań ponownego uwierzytelniania za pomocą klucza dostępu. - Przekazywanie opcji testowania origin
mediation:"immediate"zamiastuiMode:"immediate"w celu usprawnienia próśb o zalogowanie się.
Wypełnianie luk
Te 10 obszarów to tylko niektóre z nich. Spodziewamy się, że luki w wiedzy będą się z czasem zmieniać. Modele będą się rozwijać, a platforma internetowa będzie ewoluować.
Dobra wiadomość jest taka, że Przewodnik po współczesnych technologiach internetowych rozwiązuje wszystkie te problemy i będzie nadal rozwijany wraz z platformą.
Aby zacząć korzystać z Przewodnika po współczesnych technologiach internetowych, uruchom to polecenie lub wyszukaj go na platformie handlowej wtyczek agenta:
npx modern-web-guidance@latest install
Czy zdarzyło Ci się, że modele popełniły błędy w innych zadaniach związanych z tworzeniem stron internetowych? Prosimy o informacje. Zgłoś problem w repozytorium GitHub Przewodnika po współczesnych technologiach internetowych lub pomóż nam rozwiązać te problemy dla innych deweloperów, wnosząc wkład w projekt.