


Veröffentlicht: 30. Januar 2026
Bei der Entwicklung der KI-Unterstützung für die Leistung bestand die größte technische Herausforderung darin, Gemini so zu konfigurieren, dass es mit den in den DevTools aufgezeichneten Leistungs-Traces funktioniert.
Large Language Models (LLMs) arbeiten innerhalb eines „Kontextfensters“, das die Menge an Informationen, die sie gleichzeitig verarbeiten können, streng begrenzt. Diese Kapazität wird in Tokens gemessen. Bei Gemini-Modellen entspricht ein Token ungefähr einer Gruppe von vier Zeichen.
Leistungs-Traces sind riesige JSON-Dateien, die oft mehrere Megabyte groß sind. Wenn Sie einen Roh-Trace senden, wird das Kontextfenster eines Modells sofort ausgeschöpft und es bleibt kein Platz für Ihre Fragen.
Damit die KI-Unterstützung für die Leistung möglich ist, mussten wir ein System entwickeln, das die Menge an nützlichen Daten für ein LLM bei minimaler Tokennutzung maximiert. In diesem Blog erfahren Sie mehr über die Techniken, die wir dafür verwendet haben, und wie Sie sie für Ihre eigenen Projekte übernehmen können.
Anfänglichen Kontext anpassen
Die Fehlerbehebung bei der Leistung einer Website ist eine komplexe Aufgabe. Entwickler können sich entweder den vollständigen Trace ansehen, um den Kontext zu verstehen, oder sich auf die Core Web Vitals und die zugehörigen Zeitspannen des Trace konzentrieren. Sie können sich auch die Details ansehen und sich auf einzelne Ereignisse wie Klicks oder Scrollvorgänge und die zugehörigen Aufrufstacks konzentrieren.
Um den Debugging-Prozess zu unterstützen, muss die KI-Unterstützung von DevTools diese Entwickler-Journeys berücksichtigen und nur mit den relevanten Daten arbeiten, um Ratschläge zu geben, die auf den Fokus des Entwicklers zugeschnitten sind. Anstatt immer den vollständigen Trace zu senden, haben wir eine KI-Unterstützung entwickelt, die die Daten basierend auf Ihrer Debugging-Aufgabe aufteilt:
| Debugging-Aufgabe | Daten, die ursprünglich an die KI-Unterstützung gesendet wurden |
|---|---|
| Über einen Leistungs-Trace chatten | Trace-Zusammenfassung: Ein textbasierter Bericht, der allgemeine Informationen aus der Trace- und Debugging-Sitzung enthält. Enthält die Seiten-URL, Drosselungsbedingungen, wichtige Leistungsmesswerte (LCP, INP, CLS), eine Liste der verfügbaren Statistiken und, falls verfügbar, eine CrUX-Zusammenfassung. |
| Über eine Leistungsstatistik chatten | Trace-Zusammenfassung und Name der ausgewählten Leistungsstatistik. |
| Über eine Aufgabe aus einem Trace chatten | Trace-Zusammenfassung und der serialisierte Aufrufbaum, in dem sich die ausgewählte Aufgabe befindet. |
| Chat zu einer Netzwerkanfrage | Trace-Zusammenfassung sowie ausgewählter Anfrageschlüssel und Zeitstempel |
| Trace-Annotationen generieren | Der serialisierte Aufrufbaum, in dem sich die ausgewählte Aufgabe befindet. Der serialisierte Baum gibt an, welche Aufgabe ausgewählt ist. |
Die Trace-Zusammenfassung wird fast immer gesendet, um Gemini, dem zugrunde liegenden Modell der KI-Unterstützung, einen ersten Kontext zu bieten. Bei KI-generierten Annotationen wird sie weggelassen.
KI Tools zur Verfügung stellen
Die KI-Unterstützung in den Entwicklertools fungiert als Agent. Das bedeutet, dass er basierend auf dem ursprünglichen Prompt des Entwicklers und dem ursprünglichen Kontext, der mit ihm geteilt wurde, selbstständig weitere Daten abfragen kann. Damit die KI-Unterstützung mehr Daten abfragen kann, haben wir ihr eine Reihe vordefinierter Funktionen zur Verfügung gestellt, die sie aufrufen kann. Ein Muster, das als Funktionsaufruf oder Toolnutzung bezeichnet wird.
Basierend auf den zuvor beschriebenen Debugging-Prozessen haben wir eine Reihe von detaillierten Funktionen für den KI-Agenten definiert. Diese Funktionen gehen auf Details ein, die basierend auf dem ursprünglichen Kontext als wichtig erachtet werden, ähnlich wie ein menschlicher Entwickler das Leistungs-Debugging angehen würde. Die Funktionen sind:
| Funktion | Beschreibung |
|---|---|
getInsightDetails(name) |
Gibt detaillierte Informationen zu einer bestimmten Leistungsstatistik zurück (z. B. Details dazu,warum LCP gekennzeichnet wurde). |
getEventByKey(key) |
Gibt detaillierte Properties für ein einzelnes, bestimmtes Ereignis zurück. |
getMainThreadTrackSummary(start, end) |
Gibt eine Zusammenfassung der Hauptthread-Aktivität für die angegebenen Grenzen zurück, einschließlich Top-down-, Bottom-up- und Drittanbieter-Zusammenfassungen. |
getNetworkTrackSummary(start, end) |
Gibt eine Zusammenfassung der Netzwerkaktivität für die angegebenen Zeitgrenzen zurück. |
getDetailedCallTree(event_key) |
Gibt die vollständige Aufrufhierarchie für ein bestimmtes Hauptthread-Ereignis im Leistungstrace zurück. |
getFunctionCode(url, line, col) |
Gibt den Quellcode für eine Funktion zurück, die an einem bestimmten Ort in einer Ressource definiert ist, und fügt Laufzeit-Leistungsdaten aus dem Leistungs-Trace hinzu |
getResourceContent(url) |
Gibt den Inhalt einer von der Seite verwendeten Textressource zurück (z. B. HTML oder CSS). |
Durch die strikte Beschränkung des Datenabrufs auf diese Funktionsaufrufe wird sichergestellt, dass nur relevante Informationen in einem klar definierten Format in das Kontextfenster gelangen. So wird die Tokennutzung optimiert.
Beispiel für einen Agentenvorgang
Sehen wir uns ein praktisches Beispiel dafür an, wie die KI-Unterstützung Funktionsaufrufe verwendet, um weitere Informationen abzurufen. Nach einem ersten Prompt wie „Warum ist diese Anfrage langsam?“ Die KI-Unterstützung kann die folgenden Funktionen schrittweise aufrufen:
getEventByKey: Ruft die detaillierte Zeitaufschlüsselung (TTFB, Downloadzeit) der vom Nutzer ausgewählten Anfrage ab.getMainThreadTrackSummary: Prüfen Sie, ob der Hauptthread beschäftigt (blockiert) war, als die Anfrage hätte gestartet werden sollen.getNetworkTrackSummary: Analysieren Sie, ob andere Ressourcen gleichzeitig um Bandbreite konkurriert haben.getInsightDetails: Prüfen Sie, ob in der Trace-Zusammenfassung bereits eine Statistik im Zusammenhang mit dieser Anfrage als Engpass erwähnt wird.
Durch die Kombination der Ergebnisse dieser Aufrufe kann die KI-Unterstützung dann eine Diagnose erstellen und umsetzbare Schritte vorschlagen, z. B. Codeverbesserungen mit getFunctionCode oder die Optimierung des Ressourcenladens basierend auf getResourceContent.
Das Abrufen relevanter Daten ist jedoch nur die halbe Miete. Auch wenn Funktionen detaillierte Daten liefern, können die von diesen Funktionen zurückgegebenen Daten sehr umfangreich sein. Ein weiteres Beispiel: getDetailedCallTree kann einen Baum mit Hunderten von Knoten zurückgeben. In Standard-JSON wären das viele { und } nur für die Verschachtelung!
Daher ist ein Format erforderlich, das dicht genug ist, um token-effizient zu sein, aber dennoch strukturiert genug, damit ein LLM es verstehen und referenzieren kann.
Daten serialisieren
Sehen wir uns genauer an, wie wir diese Herausforderung angegangen sind. Wir verwenden dazu das Beispiel des Aufrufbaums, da Aufrufbäume den Großteil der Daten in einem Leistungstrace ausmachen. Die folgenden Beispiele zeigen eine einzelne Aufgabe in einem Aufrufstack im JSON-Format:
{
  "id": 2,
  "name": "animate",
  "selected": true,
  "duration": 150,
  "selfTime": 20,
  "children": [3, 5, 6, 7, 10, 11, 12]
}
Ein Leistungs-Trace kann Tausende davon enthalten, wie im folgenden Screenshot zu sehen ist. Jedes kleine farbige Kästchen wird mit dieser Objektstruktur dargestellt.
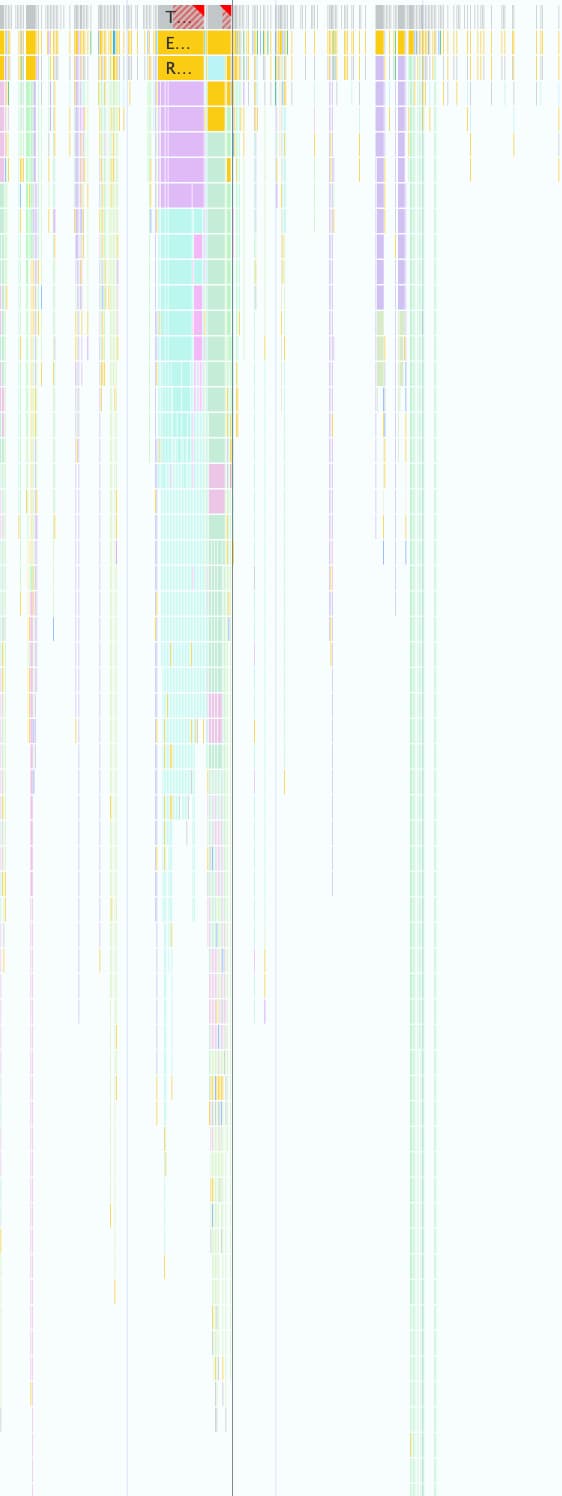
Dieses Format eignet sich gut für die programmatische Arbeit in den Entwicklertools, ist aber aus folgenden Gründen für LLMs nicht geeignet:
- Redundante Schlüssel: Strings wie
"duration","selfTime"und"children"werden für jeden einzelnen Knoten im Aufrufbaum wiederholt. Ein Baum mit 500 Knoten, der an ein Modell gesendet wird, würde also für jeden dieser Schlüssel 500-mal Tokens verbrauchen. - Ausführliche Listen: Wenn Sie jede untergeordnete ID einzeln über
childrenauflisten, werden sehr viele Tokens verbraucht, insbesondere bei Aufgaben, die viele nachgelagerte Ereignisse auslösen.
Die Implementierung eines token-effizienten Formats für alle Daten, die mit der KI-Unterstützung für die Leistung verwendet werden, war ein schrittweiser Prozess.
Erste Iteration
Als wir mit der Arbeit an der KI-Unterstützung für die Leistung begonnen haben, haben wir die Versandgeschwindigkeit optimiert. Unser Ansatz zur Tokenoptimierung war einfach. Wir haben die geschweiften Klammern und Kommas aus dem ursprünglichen JSON-Code entfernt, was zu einem Format wie dem folgenden führte:
allUrls = [...]

Node: 1 - update
Selected: false
Duration: 200
Self Time: 50
Children:
   2 - animate

Node: 2 - animate
Selected: true
Duration: 150
Self Time: 20
URL: 0
Children:
   3 - calculatePosition
   5 - applyStyles
   6 - applyStyles
   7 - calculateLayout
   10 - applyStyles
   11 - applyStyles
   12 - applyStyles

Node: 3 - calculatePosition
Selected: false
Duration: 15
Self Time: 2
URL: 0
Children:
   4 - getBoundingClientRect

...
Diese erste Version war jedoch nur eine geringfügige Verbesserung gegenüber Roh-JSON. Es wurden weiterhin explizit untergeordnete Knoten mit IDs und Namen aufgelistet und vor jeder Zeile beschreibende, wiederholte Schlüssel (Node:, Selected:, Duration:, …) vorangestellt.
Listen untergeordneter Knoten optimieren
Als nächsten Schritt zur weiteren Optimierung haben wir die Namen für untergeordnete Knoten entfernt (calculatePosition, applyStyles, … im vorherigen Beispiel). Da die KI-Unterstützung über Funktionsaufrufe Zugriff auf alle Knoten hat und diese Informationen bereits im Knotenkopf (Node: 3 - calculatePosition) enthalten sind, müssen sie nicht wiederholt werden., Dadurch konnten wir die Children auf eine einfache Liste von Ganzzahlen reduzieren:
Node: 2 - animate
Selected: true
Duration: 150
Self Time: 20
URL: 0
Children: 3, 5, 6, 7, 10, 11, 12

..
Dies war zwar eine deutliche Verbesserung gegenüber dem vorherigen Zustand, aber es gab noch weiteren Optimierungsbedarf. Wenn Sie sich das vorherige Beispiel ansehen, fällt Ihnen vielleicht auf, dass Children fast sequenziell ist und nur 4, 8 und 9 fehlen.
Der Grund dafür ist, dass wir bei unserem ersten Versuch einen DFS-Algorithmus (Depth-First Search) verwendet haben, um Baumdaten aus dem Leistungstrace zu serialisieren. Dies führte zu nicht sequenziellen IDs für gleichgeordnete Knoten, sodass wir jede ID einzeln auflisten mussten.
Wir haben festgestellt, dass wir durch die Neuindexierung des Baums mit der Breitensuche (Breadth-First Search, BFS) stattdessen sequenzielle IDs erhalten würden, was eine weitere Optimierung ermöglicht. Anstatt einzelne IDs aufzulisten, können wir jetzt sogar Hunderte von untergeordneten Elementen mit einem einzigen kompakten Bereich darstellen, z. B. 3-9 für das ursprüngliche Beispiel.
Die endgültige Knotennotation mit der optimierten Children-Liste sieht so aus:
allUrls = [...]

Node: 2 - animate
Selected: true
Duration: 150
Self Time: 20
URL: 0
Children: 3-9
Anzahl der Schlüssel reduzieren
Nachdem die Knotenlisten optimiert waren, haben wir uns den redundanten Schlüsseln zugewandt. Zuerst haben wir alle Schlüssel aus dem vorherigen Format entfernt, was zu Folgendem führte:
allUrls = [...]

2;animate;150;20;0;3-10
Das ist zwar token-effizient, aber wir mussten Gemini trotzdem Anweisungen geben, wie diese Daten zu verstehen sind. Als wir Gemini zum ersten Mal einen Aufrufbaum gesendet haben, haben wir den folgenden Prompt eingefügt:
...
Each call frame is presented in the following format:

'id;name;duration;selfTime;urlIndex;childRange;[S]'

Key definitions:

*   id: A unique numerical identifier for the call frame.
*   name: A concise string describing the call frame (e.g., 'Evaluate Script', 'render', 'fetchData').
*   duration: The total execution time of the call frame, including its children.
*   selfTime: The time spent directly within the call frame, excluding its children's execution.
*   urlIndex: Index referencing the "All URLs" list. Empty if no specific script URL is associated.
*   childRange: Specifies the direct children of this node using their IDs. If empty ('' or 'S' at the end), the node has no children. If a single number (e.g., '4'), the node has one child with that ID. If in the format 'firstId-lastId' (e.g., '4-5'), it indicates a consecutive range of child IDs from 'firstId' to 'lastId', inclusive.
*   S: **Optional marker.** The letter 'S' appears at the end of the line **only** for the single call frame selected by the user.

....
Diese Formatbeschreibung verursacht zwar Tokenkosten, aber es handelt sich um statische Kosten, die nur einmal für die gesamte Unterhaltung anfallen. Die Kosten werden durch die Einsparungen aus den vorherigen Optimierungen ausgeglichen.
Fazit
Die Optimierung der Tokennutzung ist ein wichtiger Aspekt bei der Entwicklung mit KI. Durch die Umstellung von Roh-JSON auf ein spezielles benutzerdefiniertes Format, die Neuindexierung von Bäumen mit Breitensuche und die Verwendung von Toolaufrufen zum Abrufen von Daten bei Bedarf konnten wir die Anzahl der Tokens, die die KI-Unterstützung in den Chrome-Entwicklertools verbraucht, erheblich reduzieren.
Diese Optimierungen waren eine Voraussetzung für die Aktivierung der KI-Unterstützung für Leistungs-Traces. Aufgrund des begrenzten Kontextfensters könnte es sonst die schiere Datenmenge nicht verarbeiten. Das optimierte Format ermöglicht jedoch einen leistungsstarken KI-Agenten, der einen längeren Unterhaltungsverlauf beibehalten und genauere, kontextbezogene Antworten liefern kann, ohne von irrelevanten Informationen überfordert zu werden.
Wir hoffen, dass diese Techniken Sie dazu inspirieren, Ihre eigenen Datenstrukturen beim Entwerfen von KI-Anwendungen noch einmal zu überdenken. Informationen zu den ersten Schritten mit KI in Webanwendungen finden Sie unter Learn AI auf web.dev.