


Gepubliceerd: 30 januari 2026
Toen we AI-ondersteuning voor prestaties ontwikkelden, was de belangrijkste technische uitdaging om Gemini soepel te laten werken met prestatietraces die zijn opgenomen in DevTools.
Grote taalmodellen (LLM's) werken binnen een 'contextvenster'. Dit verwijst naar een strikte limiet voor de hoeveelheid informatie die ze tegelijk kunnen verwerken. Deze capaciteit wordt gemeten in tokens. Voor Gemini-modellen is één token ongeveer een groep van vier tekens.
Prestatietraceringen zijn enorme json-bestanden, die vaak uit meerdere megabytes bestaan. Als je een onbewerkte trace stuurt, wordt het contextvenster van een model onmiddellijk uitgeput en blijft er geen ruimte over voor je vragen.
Om AI-ondersteuning voor Performance mogelijk te maken, moesten we een systeem ontwerpen dat de hoeveelheid nuttige gegevens voor een LLM maximaliseert met een minimaal tokengebruik. In deze blog leer je meer over de technieken die we hiervoor hebben gebruikt en hoe je deze kunt toepassen op je eigen projecten.
De eerste context aanpassen
Fouten opsporen in de prestaties van een website is een complexe taak. Een ontwikkelaar kan de hele trace bekijken voor context, zich richten op Core Web Vitals en gerelateerde perioden van de trace, of zelfs de details induiken en zich richten op afzonderlijke gebeurtenissen zoals klikken of scrollen en de bijbehorende aanroepstacks.
Om het foutopsporingsproces te ondersteunen, moet de AI-assistentie van DevTools overeenkomen met die ontwikkelaarstrajecten en alleen werken met de relevante gegevens om advies te geven dat specifiek is voor de focus van de ontwikkelaar. In plaats van altijd de volledige trace te sturen, hebben we AI-ondersteuning ontwikkeld om de gegevens op te splitsen op basis van je foutopsporingstaak:
| Foutopsporingstaak | Gegevens die in eerste instantie naar AI-assistentie zijn gestuurd |
|---|---|
| Chatten over een prestatietracering | Trace-overzicht: Een tekstgebaseerd rapport met informatie op hoog niveau van de trace- en foutopsporingssessie. Bevat de pagina-URL, beperkingsvoorwaarden, belangrijke prestatiestatistieken (LCP, INP, CLS), een lijst met beschikbare inzichten en, indien beschikbaar, een CrUX-overzicht. |
| Chatten over een prestatie-inzicht | Overzicht van de trace en de naam van het geselecteerde prestatie-inzicht. |
| Chatten over een taak uit een trace | Trace-overzicht en de geserialiseerde aanroepstructuur waarin de geselecteerde taak zich bevindt. |
| Chatten over een netwerkverzoek | Trace-overzicht en de geselecteerde verzoeksleutel en tijdstempel |
| Traceerannotaties genereren | De geserialiseerde aanroepstructuur waarin de geselecteerde taak zich bevindt. De geserialiseerde structuur geeft aan welke taak is geselecteerd. |
Het trace-overzicht wordt bijna altijd gestuurd om de eerste context te bieden aan Gemini, het onderliggende model van AI-ondersteuning. Voor AI-gegenereerde annotaties wordt dit weggelaten.
AI tools geven
AI-ondersteuning in DevTools werkt als een agent. Dit betekent dat het model autonoom query's kan uitvoeren voor meer gegevens, op basis van de eerste prompt van de ontwikkelaar en de eerste context die met het model is gedeeld. We hebben AI-assistentie een reeks vooraf gedefinieerde functies gegeven die kunnen worden aangeroepen om meer gegevens op te vragen. Een patroon dat bekendstaat als functieaanroep of toolgebruik.
Op basis van de eerder beschreven foutopsporingstrajecten hebben we een reeks gedetailleerde functies voor de agent gedefinieerd. Deze functies gaan dieper in op specifieke details die belangrijk worden geacht op basis van de oorspronkelijke context, vergelijkbaar met hoe een menselijke ontwikkelaar prestatieproblemen zou aanpakken. De functies zijn:
| Functie | Beschrijving |
|---|---|
getInsightDetails(name) |
Retourneert gedetailleerde informatie over een specifiek prestatie-inzicht (bijvoorbeeld informatie over waarom LCP is gemarkeerd). |
getEventByKey(key) |
Retourneert gedetailleerde property's voor één specifieke gebeurtenis. |
getMainThreadTrackSummary(start, end) |
Retourneert een samenvatting van de hoofdthreadactiviteit voor de opgegeven grenzen, waaronder samenvattingen van boven naar beneden, van beneden naar boven en van derden. |
getNetworkTrackSummary(start, end) |
Retourneert een overzicht van de netwerkactiviteit voor de aangegeven tijdsgrenzen. |
getDetailedCallTree(event_key) |
Retourneert de volledige aanroepstructuur voor een specifieke gebeurtenis in de hoofdthread in de prestatietracering |
getFunctionCode(url, line, col) |
Retourneert de broncode voor een functie die is gedefinieerd op een specifieke locatie in een bron, geannoteerd met runtime-prestatiegegevens uit de prestatietrace |
getResourceContent(url) |
Retourneert de content van een tekstbron die door de pagina wordt gebruikt (bijvoorbeeld HTML of CSS). |
Door het ophalen van gegevens strikt te beperken tot deze functieaanroepen, zorgen we dat alleen relevante informatie in een goed gedefinieerde indeling in het contextvenster terechtkomt, waardoor het tokengebruik wordt geoptimaliseerd.
Voorbeeld van een agentbewerking
Laten we een praktisch voorbeeld bekijken van hoe AI-assistentie functieaanroepen gebruikt om meer informatie op te halen. Na een eerste prompt van 'Waarom is dit verzoek traag?', AI-ondersteuning kan de volgende functies incrementeel aanroepen:
getEventByKey: Haal de gedetailleerde uitsplitsing van de timing (TTFB, downloadtijd) op van het specifieke verzoek dat de gebruiker heeft geselecteerd.getMainThreadTrackSummary: Controleer of de hoofdthread bezet (geblokkeerd) was toen het verzoek had moeten beginnen.getNetworkTrackSummary: Analyseer of andere bronnen tegelijkertijd om bandbreedte concurreerden.getInsightDetails: Controleer of het Trace-overzicht al een inzicht vermeldt dat gerelateerd is aan dit verzoek als knelpunt.
Door de resultaten van deze aanroepen te combineren, kan AI-ondersteuning een diagnose stellen en actiegerichte stappen voorstellen, zoals codeverbeteringen voorstellen met getFunctionCode of het laden van bronnen optimaliseren op basis van getResourceContent.
Maar het ophalen van relevante gegevens is maar de helft van de uitdaging. Zelfs met functies die gedetailleerde gegevens bieden, kunnen de gegevens die door die functies worden geretourneerd, groot zijn. Een ander voorbeeld: getDetailedCallTree kan een boom met honderden nodes retourneren. In standaard JSON zou dit veel { en } zijn, alleen al voor nesten.
Er is daarom behoefte aan een indeling die compact genoeg is om token-efficiënt te zijn, maar nog steeds gestructureerd genoeg is voor een LLM om te begrijpen en naar te verwijzen.
De gegevens serialiseren
Laten we dieper ingaan op hoe we deze uitdaging hebben aangepakt, door verder te gaan met het voorbeeld van de aanroepstructuur, omdat aanroepstructuren het grootste deel van de gegevens in een prestatietrace vormen. Ter referentie: De volgende voorbeelden tonen één taak in een aanroepstack in JSON:
{
  "id": 2,
  "name": "animate",
  "selected": true,
  "duration": 150,
  "selfTime": 20,
  "children": [3, 5, 6, 7, 10, 11, 12]
}
Eén prestatietrace kan er duizenden bevatten, zoals in het volgende screenshot wordt getoond. Elk klein gekleurd vakje wordt weergegeven met deze objectstructuur.
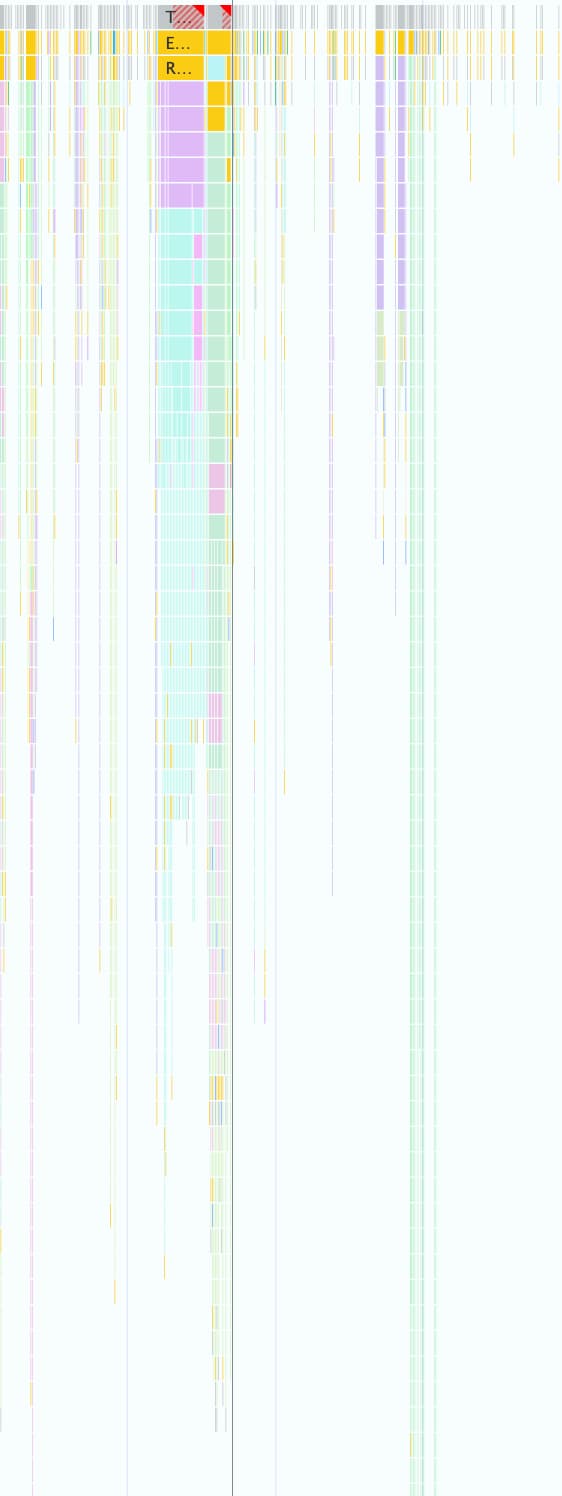
Deze indeling is goed om programmatisch mee te werken in DevTools, maar is verspilling voor LLM's om de volgende redenen:
- Redundante sleutels: Tekenreeksen zoals
"duration","selfTime"en"children"worden herhaald voor elke node in de aanroepstructuur. Een boom met 500 nodes die naar een model wordt gestuurd, verbruikt dus 500 keer tokens voor elk van die sleutels. - Uitgebreide lijsten: Als je elke onderliggende ID afzonderlijk vermeldt via
children, verbruik je een enorm aantal tokens, vooral voor taken die veel downstream-gebeurtenissen activeren.
De implementatie van een token-efficiënte indeling voor alle gegevens die worden gebruikt met AI-ondersteuning voor prestaties was een stapsgewijs proces.
Eerste iteratie
Toen we begonnen met de ontwikkeling van AI-ondersteuning voor Prestaties, hebben we geoptimaliseerd voor verzendsnelheid. Onze aanpak voor tokenoptimalisatie was eenvoudig. We hebben de oorspronkelijke json ontdaan van accolades en komma's, wat resulteerde in een indeling zoals deze:
allUrls = [...]

Node: 1 - update
Selected: false
Duration: 200
Self Time: 50
Children:
   2 - animate

Node: 2 - animate
Selected: true
Duration: 150
Self Time: 20
URL: 0
Children:
   3 - calculatePosition
   5 - applyStyles
   6 - applyStyles
   7 - calculateLayout
   10 - applyStyles
   11 - applyStyles
   12 - applyStyles

Node: 3 - calculatePosition
Selected: false
Duration: 15
Self Time: 2
URL: 0
Children:
   4 - getBoundingClientRect

...
Maar deze eerste versie was maar een kleine verbetering ten opzichte van onbewerkte json. De onderliggende nodes werden nog steeds expliciet vermeld met ID's en namen, en er werden beschrijvende, herhaalde sleutels (Node:, Selected:, Duration:, …) vóór elke regel geplaatst.
Lijsten met onderliggende nodes optimaliseren
Als volgende stap om verder te optimaliseren, hebben we de namen voor onderliggende nodes verwijderd (calculatePosition, applyStyles, … in het vorige voorbeeld). Omdat AI-ondersteuning toegang heeft tot alle nodes via functieaanroepen en deze informatie al in de nodekop (Node: 3 - calculatePosition) staat, hoef je deze informatie niet te herhalen., Hierdoor konden we de Children samenvouwen tot een eenvoudige lijst met gehele getallen:
Node: 2 - animate
Selected: true
Duration: 150
Self Time: 20
URL: 0
Children: 3, 5, 6, 7, 10, 11, 12

..
Hoewel dit een duidelijke verbetering was ten opzichte van de eerdere situatie, was er nog steeds ruimte voor optimalisatie. Als je naar het vorige voorbeeld kijkt, zie je misschien dat Children bijna opeenvolgend is. Alleen 4, 8 en 9 ontbreken.
De reden is dat we in onze eerste poging een Depth-First Search (DFS)-algoritme hebben gebruikt om boomgegevens uit de prestatietrace te serialiseren. Dit leidde tot niet-opeenvolgende ID's voor onderliggende nodes, waardoor we elke ID afzonderlijk moesten vermelden.
We realiseerden ons dat als we de boom opnieuw indexeerden met Breadth-First Search (BFS), we opeenvolgende ID's zouden krijgen, waardoor een andere optimalisatie mogelijk werd. In plaats van afzonderlijke ID's te vermelden, kunnen we nu zelfs honderden kinderen vertegenwoordigen met één compact bereik, zoals 3-9 voor het oorspronkelijke voorbeeld.
De uiteindelijke knooppuntnotatie met de geoptimaliseerde lijst Children ziet er zo uit:
allUrls = [...]

Node: 2 - animate
Selected: true
Duration: 150
Self Time: 20
URL: 0
Children: 3-9
Het aantal sleutels verminderen
Nadat we de knooppuntlijsten hadden geoptimaliseerd, gingen we verder met de overbodige sleutels. We zijn begonnen door alle sleutels uit de vorige indeling te verwijderen, wat resulteerde in dit:
allUrls = [...]

2;animate;150;20;0;3-10
Hoewel dit token-efficiënt is, moesten we Gemini nog steeds instructies geven over hoe deze gegevens moesten worden begrepen. De eerste keer dat we een belboom naar Gemini stuurden, hebben we de volgende prompt toegevoegd:
...
Each call frame is presented in the following format:

'id;name;duration;selfTime;urlIndex;childRange;[S]'

Key definitions:

*   id: A unique numerical identifier for the call frame.
*   name: A concise string describing the call frame (e.g., 'Evaluate Script', 'render', 'fetchData').
*   duration: The total execution time of the call frame, including its children.
*   selfTime: The time spent directly within the call frame, excluding its children's execution.
*   urlIndex: Index referencing the "All URLs" list. Empty if no specific script URL is associated.
*   childRange: Specifies the direct children of this node using their IDs. If empty ('' or 'S' at the end), the node has no children. If a single number (e.g., '4'), the node has one child with that ID. If in the format 'firstId-lastId' (e.g., '4-5'), it indicates a consecutive range of child IDs from 'firstId' to 'lastId', inclusive.
*   S: **Optional marker.** The letter 'S' appears at the end of the line **only** for the single call frame selected by the user.

....
Hoewel deze beschrijving van de indeling een tokenkost met zich meebrengt, is dit een statische kost die één keer wordt betaald voor het hele gesprek. De kosten worden gecompenseerd door de besparingen die zijn behaald met de eerdere optimalisaties.
Conclusie
Het optimaliseren van het tokengebruik is een cruciale overweging bij het bouwen met AI. Door over te stappen van onbewerkte JSON naar een gespecialiseerde aangepaste indeling, bomen opnieuw te indexeren met Breadth-First Search en tool-aanroepen te gebruiken om gegevens on demand op te halen, hebben we de hoeveelheid tokens die AI-ondersteuning in Chrome DevTools verbruikt aanzienlijk verminderd.
Deze optimalisaties waren een vereiste om AI-assistentie voor prestatietraces aan te zetten. Vanwege het beperkte contextvenster kan het anders de enorme hoeveelheid gegevens niet verwerken. Maar de geoptimaliseerde indeling maakt een prestatie-agent mogelijk die een langere gespreksgeschiedenis kan bijhouden en nauwkeurigere, contextbewuste antwoorden kan geven zonder overweldigd te worden door ruis.
We hopen dat deze technieken je inspireren om je eigen gegevensstructuren nog eens goed te bekijken als je ontwerpt voor AI. Ga naar Learn AI op web.dev om aan de slag te gaan met AI in web-apps.