


تاريخ النشر: 12 نوفمبر 2026
أطلقنا هذا الأسبوع الإصدار 1.0 من إرشادات الويب الحديث، وهي مهارة مفتوحة المصدر تساعد وكلاء الترميز في استخدام ميزات منصات الويب الحديثة بدلاً من الحلول البديلة القديمة. يستعرض هذا المنشور محرك البحث المحلي الذي يعثر على الدليل الأكثر صلة بمهمتك، بدون إهدار الرموز المميزة.
إذا أخبرت مهندسًا بأنّك أنشأت قاعدة معرفية تحتوي على 1.7 ميغابايت من نص Markdown لوكيل الترميز الخاص به، فسيطرَح سؤالَين:
- "كم عدد الرموز المميّزة التي سيتم إضافتها إلى قدرة الاستيعاب؟"
- "ما نوع قاعدة بيانات المتجهات الضخمة التي يتطلبها؟"
على مدار الأشهر الستة الماضية، أعدنا إنشاء محرّك الاسترجاع المحلي ثلاث مرات. انتقلنا من 507 ميغابايت من عمليات ربط C++ إلى 23 ميغابايت من JavaScript الخالصة باستخدام TensorFlow.js، ثم إلى حزمة بحجم 7 ميغابايت حيث يكون تضمين طلب البحث عبارة عن حلقة for من 7 أسطر، مع تحسين الدقة في الوقت نفسه.
التوليد المعزّز بالاسترجاع (RAG) المستند إلى الذكاء الاصطناعي الوكيل والإفصاح التدريجي
إنّ إدخال 1.7 ميغابايت من نص Markdown يحتوي على أكثر من 200 دليل حول HTML وCSS وWeb API في AGENTS.md ليس أمرًا عمليًا. نحن نؤمن بالإفصاح التدريجي، ولكننا نعلم أنّ فهرس Markdown سيتوقف عن كونه فعّالاً من حيث الرموز المميّزة على نطاق واسع.
لحلّ هذه المشكلة، نستخدم التوليد المعزَّز بالاسترجاع (RAG) المستند إلى الوكلاء والمدعوم بواجهة سطر أوامر (CLI) للبحث:
- في وضع السكون، يرى الوكيل وصف المهارة فقط (حوالي 205 رمز مميّز). يتبع الوصف إرشادات Anthropic بشأن تفعيل المهارات لكي يستدعي الوكيل المهارة في المهام ذات الصلة بالواجهة الأمامية.
- في مهام الواجهة الأمامية، يمكن للوكيل استخدام واجهة سطر الأوامر للبحث عن:
modern-web-guidance search "animate height auto"، والحصول على 10 نتائج مطابقة ذات صلة (حوالي 530 رمزًا مميزًا). - يُشغّل الوكيل
modern-web-guidance retrieve animate-to-intrinsic-sizesلسحب الدليل بالكامل (حوالي 800 رمز مميّز). وهي مجهّزة الآن بأفضل ممارسات التنفيذ للتوافق والحلول البديلة والتقنية.
لماذا نستخدم مهارة CLI بدلاً من خادم MCP أو بحث الويب؟
- تؤدي أدوات MCP إما إلى إهدار الرموز المميّزة أو استخدام آليات تفعيل غير موثوقة (بسبب الاكتشاف الديناميكي للأدوات). تم تحسين وصف المهارة ليكون موجزًا وفعّالاً، ما يتيح للوكيل استخدام الإرشادات فقط عند الحاجة.
- يعرض البحث المضمّن في الويب إجابات Stack Overflow ومستندات مرجعية من عام 2015 بدلاً من أنماط تنفيذ
DO/DO NOTالحديثة والمنظَّمة. ويستغرق أيضًا ثوانٍ عبر الشبكة ويتعذّر إجراؤه في بيئات الاختبار المعزولة بلا إنترنت، في حين أنّ واجهة سطر الأوامر المحلية تعمل على وحدة المعالجة المركزية (CPU) في أجزاء من الثانية.
الجيل الأول: نموذج أوّلي بلغة C++ بحجم 507 ميغابايت
استخدم الإصدار الأول من إرشادات الويب الحديث حزمة RAG محلية: LanceDB وApache Arrow وTransformers.js مع onnxruntime-native.
كانت تعمل بشكل جيد على جهاز المطوّر، ولكنها لم تكن مناسبة لمهارة الوكيل:
- عند إضافة مهارة إلى مشروع (أو يستدعيها وكيل باستخدام
npx)، لا تتوقّع الانتظار حتى يتمnpm installتنزيل ملفات ثنائية.nodeتعتمد على البنية أو تجميعnode-gypC++ الذي يفشل بشكل روتيني في بيئات الاختبار المعزولة في السحابة الإلكترونية. - بلغ حجم دليل
node_modulesالذي تم استخراجه 507 ميغابايت.
الجيل الثاني: تقليص حجم TensorFlow.js إلى 23 ميغابايت
أردنا أن نلغي الحاجة إلى التجميع الأصلي وأن نتيح التنفيذ الفوري في أي مكان يتم فيه تشغيل Node. لذلك، في أبريل، استبدلنا حزمة الرموز البرمجية الأصلية بمحرّك وحدة معالجة مركزية (CPU) مستند إلى JavaScript فقط يشغّل all-MiniLM-L6-v2 على @tensorflow/tfjs:
- تمت إزالة
onnxruntime-nodeفي esbuild واستبدال أداة ترميز Hugging Face بأداة ترميز BERT WordPiece صغيرة داخل الشجرة (0 عدم تطابق في معرّفات الرموز المميّزة). - بعد استكشاف بعض خرائط المصدر، تم تقليص أكثر من 400 وحدة في
@tensorflow/tfjs-backend-cpuإلى 26 نواة يستخدمها MiniLM فعليًا، ما أدى إلى تقليص حجم محرّك JS من 6 ميغابايت إلى 830 كيلوبايت. - تم استبعاد LanceDB لصالح المتجهات المضغوطة بتنسيق gzip في وقت الإنشاء وفحص حاصل الضرب القياسي
<1 msفي الذاكرة لجميع الأدلة التي يبلغ عددها 200 تقريبًا. - يجب وضع أداة التضمين خلف طلب
import()لكي ينتهيretrieveوlistفي أقل من عشرة أجزاء من الثانية.
أدى ذلك إلى تقليل حجم حزمة npm إلى 23 ميغابايت بدون أي تبعيات لوقت التشغيل. أطلقنا هذه الميزة، وأجرى الوكلاء حوالي 750,000 عملية بحث باستخدامها.
أين حدثت مشكلة في MiniLM في قناة الإصدار العلني؟
بعد بضعة أشهر، نظرنا في المسارات التي تم فيها تثبيت المهارة لدى الوكلاء ولكنهم استمروا في كتابة الرموز البرمجية القديمة.
في إحدى عمليات تشغيل Codex، طلب أحد المطوّرين رسالة تأكيد الحذف. لدينا دليل كامل حول إنشاء نوافذ تأكيد مشروطة يسهل الوصول إليها باستخدام HTML <dialog closedby="any">.
اتّبع موظف الدعم الإجراء الصحيح وبحث عن:
npx modern-web-guidance@latest search "confirm destructive action"
عرضت واجهة سطر الأوامر (CLI) الردّ []. لذا هزّ الوكيل كتفيه وكتب window.confirm().
لماذا لم يتم عرض أي نتائج؟ عندما تعمّقنا في السجلّات والتضمينات، برزت فجوتان في عملية استرجاع المعلومات:
- تم تدريب
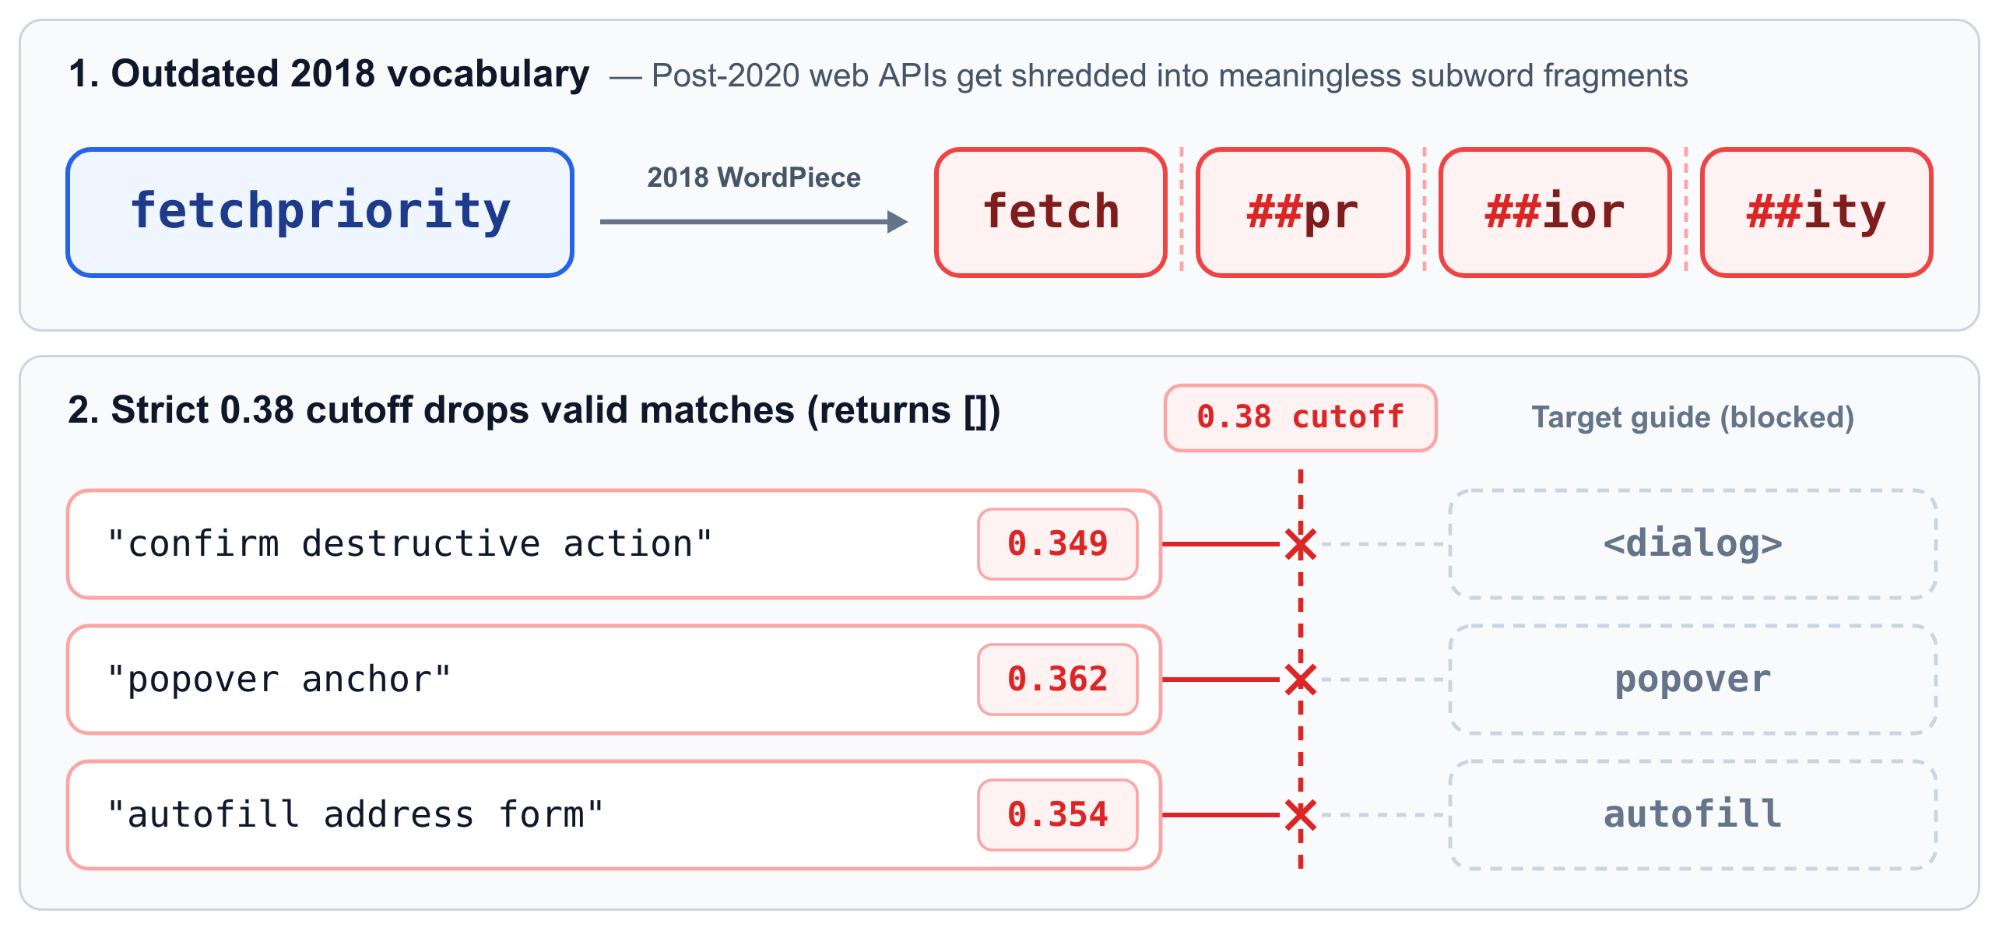
all-MiniLM-L6-v2في الفترة بين 2018 و2020، لذا فإنّ مفردات WordPiece لا تعرف حرفيًا أنّ واجهات برمجة التطبيقات على الويب التي تم إنشاؤها بعد عام 2020 موجودة. عندما يبحث موظف الدعم عنfetchpriorityأوpopoverأوstartViewTransition، يجزّئ محلّل الرموز لعام 2018fetchpriorityإلى أربع كلمات فرعية لا معنى لها:fetch·##pr·##ior·##ity. - لمنع طلبات البحث الخارجة عن النطاق من عرض أدلة عشوائية، أضاف طلب دمج سابق حدًا صارمًا
0.38لتشابه جيب التمام. بما أنّ MiniLM لم يتمكّن من ربط العبارة المكوّنة من 3 كلمات ""confirm destructive action"" بـ ""dialog"" فوق0.38(النتيجة0.349، بينما حصلت ""popover anchor"" على0.362و""autofill address form"" على0.354)، تجاهل البوابة المطابقات الصالحة. والأسوأ من ذلك أنّه كلما عرضت الأداةsearchالردّ[]، كانت تعليمات المهارات تطلب من الوكيل الرجوع إلىmodern-web-guidance list، ما يؤدي إلى إدراج جميع أوصاف الأدلة البالغ عددها 200 تقريبًا (ما يقرب من 1,500 رمز مميّز مهدر) في السياق.
إصلاح عملية استرجاع البيانات: القياس عن بُعد الحقيقي والبحث المختلط وعرض 10 نتائج
كان مقياس الأداء الأصلي لدينا هو 850 طلب بحث اصطناعي تم إنشاؤه من الأدلة نفسها، والتي تطابقت مع صياغة الدليل بشكل وثيق للغاية لرصد هذه الإخفاقات. لذلك، أنشأنا مجموعة تقييم جديدة (pnpm benchmark:rag) حول 4,000 عملية بحث مباشرة تم أخذ عينات منها من قياسات CLI التي تم إيقافها (والتي تسجّل فقط وسيطة search المكوّنة من كلمتين إلى 5 كلمات للوكيل، ولا تسجّل أبدًا طلبات المستخدمين أو رمز المستودع، وتلتزم بـ DISABLE_TELEMETRY=1) بالإضافة إلى 1,029 عملية بحث تم استخراجها من تقييمات الوكيل الليلية في Claude Code وCodex CLI وGemini CLI.
عند إعادة تشغيل سجلّ git الخاص بنا مقارنةً بطلبات البحث المستبعَدة، تبيّن أنّ الحدّ الأقصى لـ 0.38 قد أدى إلى زيادة الردود الفارغة على [] بمقدار 8 مرات. بعد وضع المعيار، أجرينا تحسينَين سريعين قبل تعديل نموذج التضمين:
- البحث المختلط عن الكلمات الرئيسية والدلالية: تحجب المتجهات الكثيفة أسماء واجهات برمجة التطبيقات الدقيقة (
:user-invalidوshowModalوdetails-name)، بينما يفوت البحث عن الكلمات الرئيسية طلبات البحث عن الغرض عندما لا يعرف الوكيل اسم واجهة برمجة التطبيقات. أضفنا فهرس كلمات رئيسية BM25 (إذا كنت تعرفه، فأنت تعرفه) بدون تبعيات مع ميزة استخراج جذور الكلمات بصيغة الجمع، وفهرسناweb-feature-idsلكل دليل، ودمجنا BM25 مع الترتيب الدلالي. الآن،searchلا يعرض سوى[]عندما يكون التشابه الدلالي<0.30ولا يتضمّن BM25 أي نتائج للكلمات الرئيسية. - 10 نتائج موجزة بدلاً من 5 نتائج مطوّلة: سبق أن طلبت تعليمات المهارة من الوكلاء تجاهل
similarityوtokenCount. من خلال إزالة هذه الحقول غير المستخدَمة، يمكننا تضمين 10 نتائج{id, description}موجزة في الميزانية نفسها التي تبلغ حوالي 530 رمزًا مميزًا مثل 5 نتائج تفصيلية:
// Before: 5 verbose results (~105 tokens each = ~525 tokens)
{
  "id": "dialog",
  "category": "html",
  "description": "Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby.",
  "featuresUsed": ["dialog", "dialog-closedby"],
  "tokenCount": 780,
  "similarity": 0.49
}
// After: 10 compact results (~53 tokens each = ~530 tokens)
{"id":"dialog","description":"Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby."}
أدّى هذان التغييران معًا إلى رفع معدّل نجاح البحث في طلبات البحث عن بيانات القياس عن بُعد المحجوزة من %80.6 إلى %94.7، ويتم قياس ذلك على النحو التالي: Hit@K (ما إذا كان الدليل المتوقّع يظهر في أعلى نتائج K).
الجيل الثالث: تضمينات مُعدّة مسبقًا وحلقة for من 7 أسطر
حتى مع معدّل نجاح يبلغ 94.7%، أظهرت بيانات القياس عن بُعد عدم تطابق صارخ: 86.7% من عمليات البحث التي أجراها موظفو الدعم كانت تتألف من كلمتَين إلى 5 كلمات فقط (المتوسط: 3 كلمات). في كل مرة يبحث فيها موظف دعم عن عبارة مكوّنة من 3 كلمات، كان Node يشغّل TensorFlow.js، ويحلّل شبكة عصبية بحجم 22.6 ميغابايت، ويستهلك 770 ملي ثانية من وقت الاستجابة للتشغيل على البارد و346 ميغابايت من ذاكرة الوصول العشوائي القصوى.
عندما سألنا عن طريقة أخف لتضمين طلبات البحث المكوّنة من 3 كلمات بدون شبكة عصبية، قدّم لنا وكيل Antigravity مجموعة من تقنيات استخلاص تعلُّم الآلة غير المألوفة: Model2Vec وTokenlearn وأبعاد Matryoshka وAdagrad. (إذا أردت الاطّلاع على التفاصيل التقنية، يمكنك العثور على المزيد في صفحة جودة البحث).
يفرض نموذج "التوليد المعزّز بالاسترجاع" (RAG) المحلي العادي معالجة كل من المستندات وطلبات البحث من خلال النموذج الصغير نفسه على وحدة المعالجة المركزية (CPU) الخاصة بالمستخدم. ومع ذلك، لا تتغيّر أدلتنا التي يبلغ عددها حوالي 200 دليل بعد إصدار npm، لذا ليس هناك سبب لتضمينها في نموذج صغير من عام 2018. بدلاً من ذلك، يُنشئ embed-guide-chunks.ts مسبقًا جميع متجهات الدليل في وقت الإصدار في السحابة الإلكترونية باستخدام gemini-embedding-001 ويشحنها كمتجهات Int8 ثنائية ذات 256 بُعدًا (guide-chunks.i8، 335 KB مضغوطة بتنسيق gzip).
كيف يمكن لمشروع واجهة سطر أوامر (CLI) غير متصل بالإنترنت ولا يتطلّب مفتاح واجهة برمجة التطبيقات أن يعرض طلب المستخدم المباشر في مساحة متّجهات Gemini نفسها؟ بما أنّ طلبات البحث التي يقدّمها الوكلاء تتألف دائمًا من كلمتَين إلى 5 كلمات، لا نحتاج إلى نموذج Transformer في وقت التشغيل. نحتاج فقط إلى جدول بحث للمتجهات للكلمات المعروفة (table) وطريقة ذكية لجمعها. في وقت التشغيل، يتم تصغير مسار TensorFlow.js بالكامل الذي يبلغ حجمه 23 ميغابايت إلى حلقة for من 7 أسطر في static-embedder.ts:
// Each word's weight and Int8 scale are pre-folded into `scales[i]`
for (const [i, f] of enc) {
  const wt = scales[i] * f;
  const offset = i * 256;
  for (let k = 0; k < 256; k++) {
    out[k] += wt * table[offset + k];
  }
}
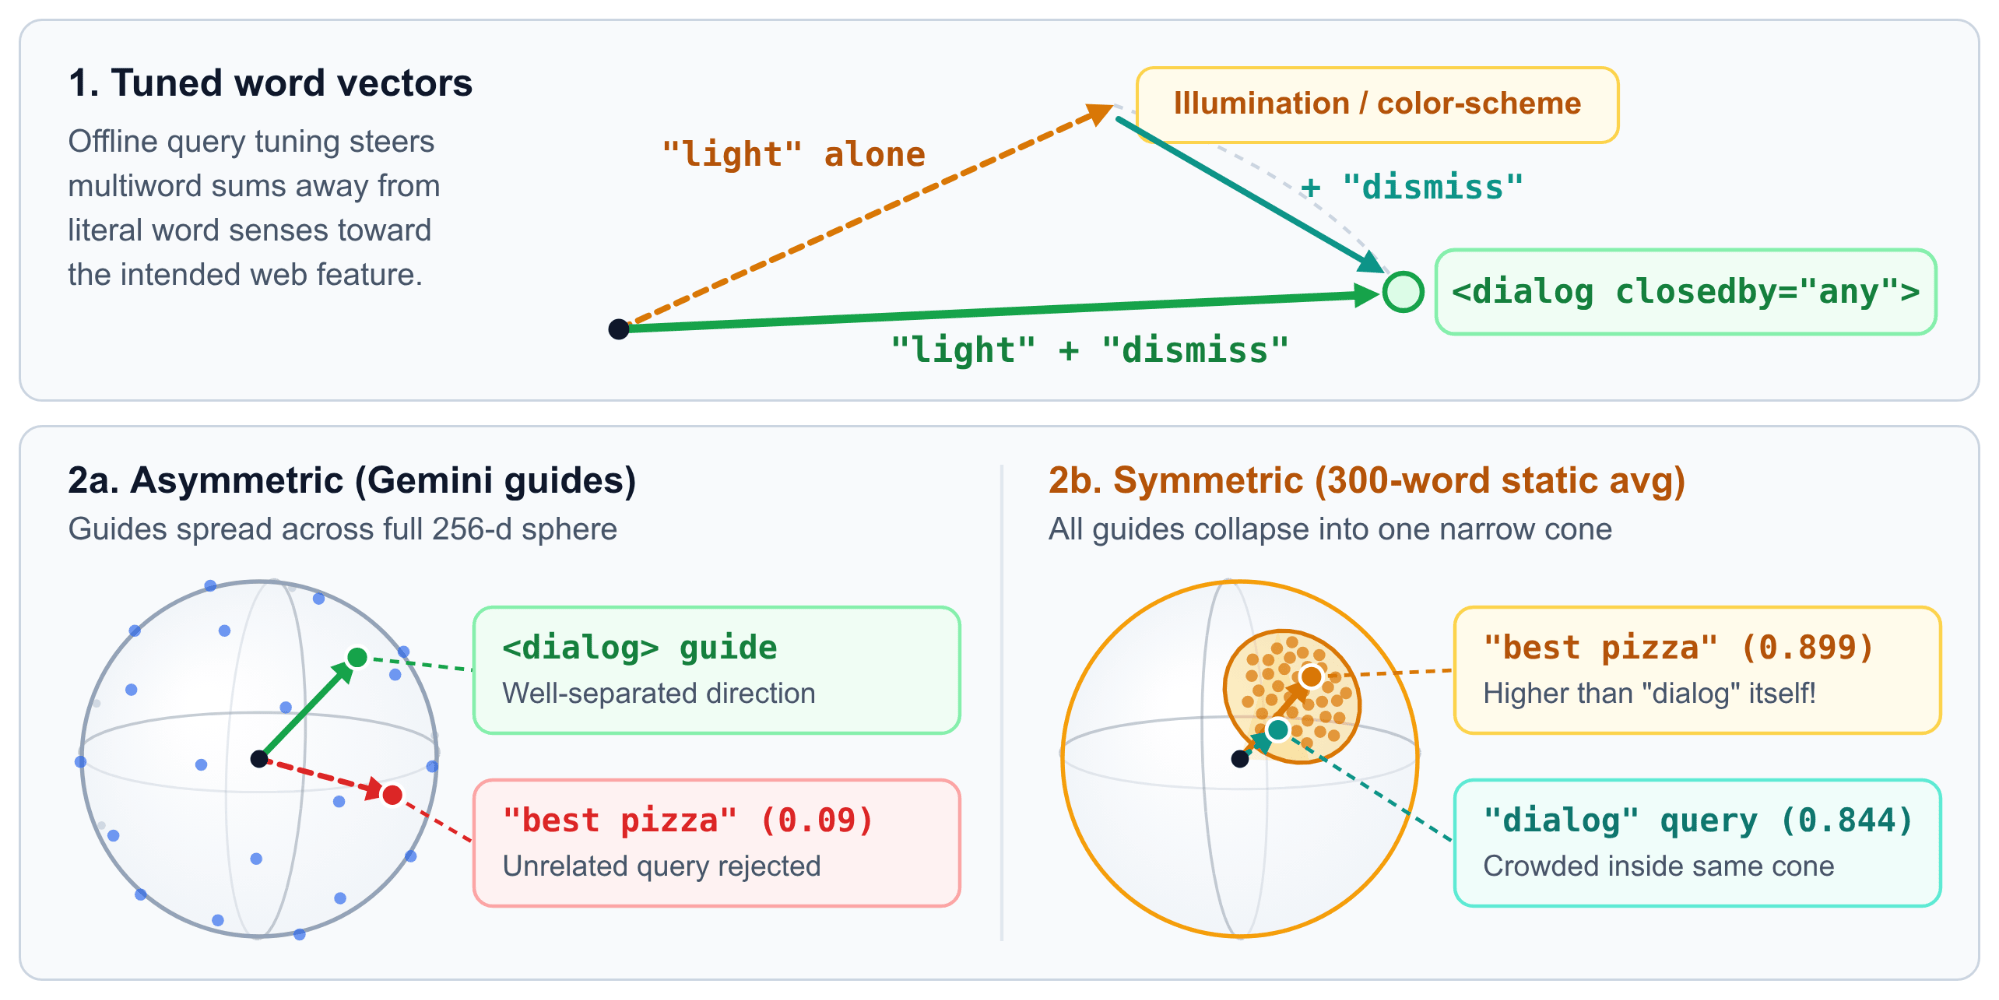
لإنشاء جدول البحث هذا (train-query-words.ts)، استخدمنا مفردات تتألف من 29,165 كلمة (حيث تكون مصطلحات الويب الحديثة مثل fetchpriority وlight-dismiss وpopover وscrollytelling كلمات كاملة مستقلة)، وضمّناها مع gemini-embedding-001، وضبطنا متجهات الكلمات بلا إنترنت مقابل 33,000 طلب بحث حقيقي على الويب بحيث تظهر التركيبات متعددة الكلمات في المكان المناسب (على سبيل المثال، يشير "light" + "dismiss" إلى <dialog closedby="any">، وليس إلى الإضاءة أو أنظمة الألوان). يتم ضغط جدول البحث بالكامل إلى Int8 (query-words.i8) باستخدام gzip (5.3 MB).
لماذا لا نستخدم جدول البحث الثابت هذا لتضمين الأدلة أيضًا، ونتخطى خطوة إنشاء السحابة؟ جرّبنا ذلك أولاً، لكنّه لم ينجح مع الفقرات الكاملة: فجمع 3 كلمات من طلب البحث يظل دقيقًا، ولكن حساب متوسط مئات الكلمات في دليل كامل يؤدي إلى تضييق نطاق كل دليل ليقترب من المتوسط العام للغة الإنجليزية (لدرجة أنّ "best pizza in new york" سجّل تشابه جيب تمام بقيمة 0.899 مع دليل dialog، وهو أعلى من طلب البحث "dialog" نفسه الذي سجّل 0.844!). إنّ الجمع بين عمليات البحث الثابتة عن طلبات البحث المكوّنة من 3 كلمات (query-words.i8) وتضمينات دليل Gemini للنموذج الكامل (guide-chunks.i8) يمنحنا دقة على مستوى السحابة الإلكترونية، بينما تظل طلبات البحث تعمل بلا إنترنت في غضون 30 ميكروثانية.
لوحة النتائج في الأجيال الثلاثة
في جميع مراحل الإصدار، ارتفع مقياس Hit@K من %78.2 باستخدام تضمينات المستندات الكاملة إلى %95.4 باستخدام أداة التضمين الثابتة Int8 (مقارنةً بـ %96.9 باستخدام Cloud APIs gemini-embedding-001):
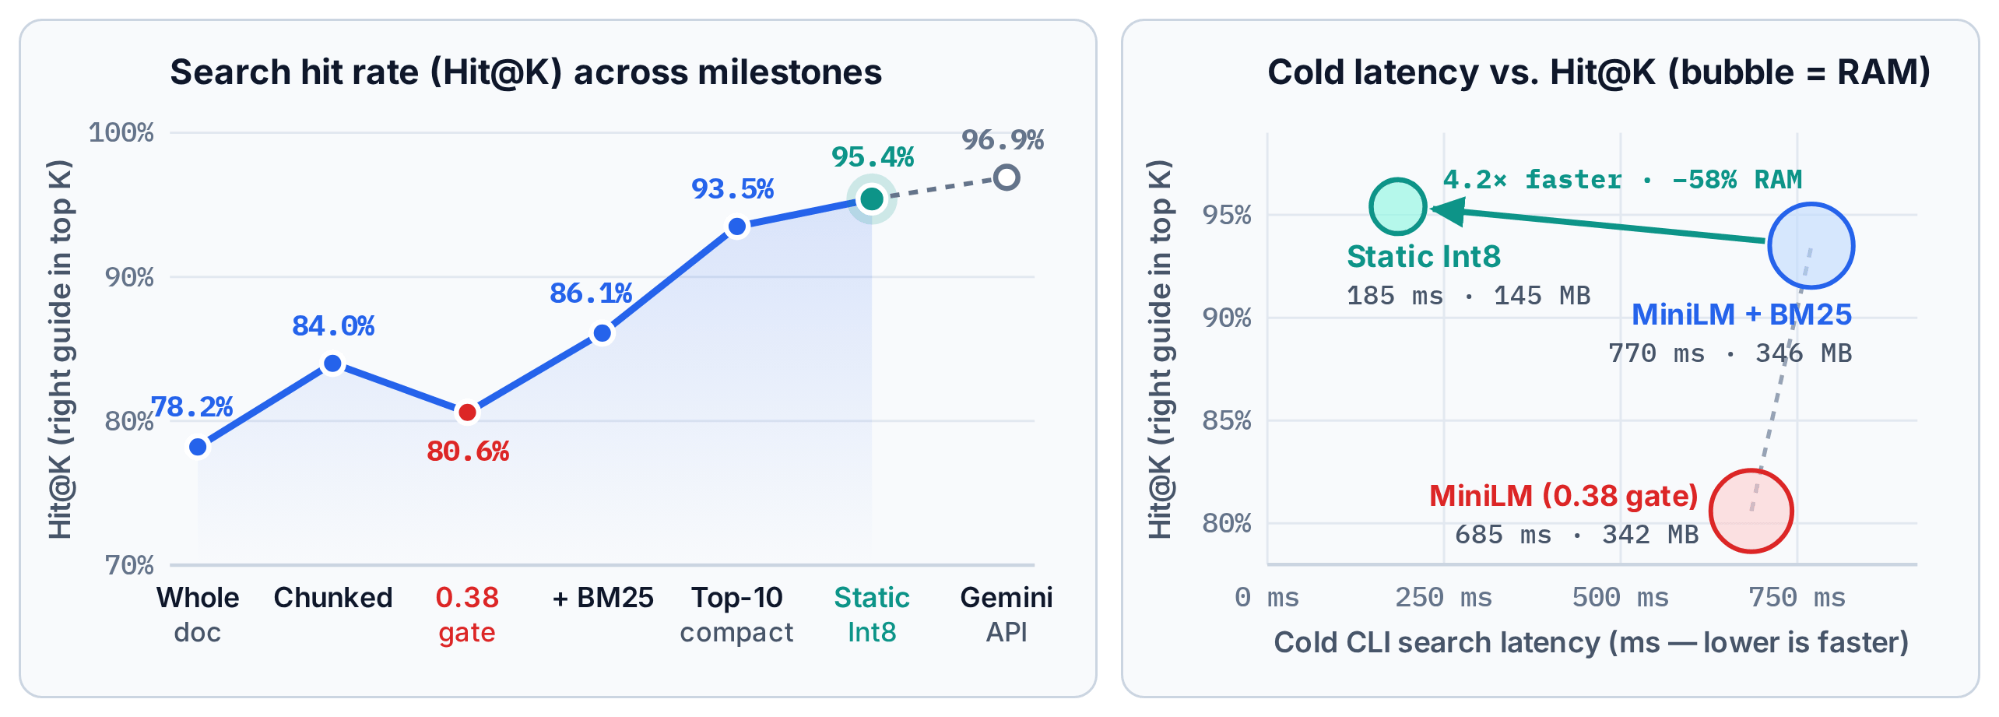
في ما يلي مقارنة بين الأجيال الثلاثة بعد إطلاق أداة التضمين الثابتة:
وإذا شغّلنا طلب البحث المعطّل في Codex من قبل:
npx modern-web-guidance@latest search "confirm destructive action"
يعود دليل "dialog" إلى أعلى القائمة.
(يمكنك استكشاف الرسوم البيانية التفاعلية في جميع المراحل الرئيسية وأطوال طلبات البحث وآفاق K على لوحة بيانات جودة البحث.)
الرمز رخيص، والقياس هو العمل
يمكن للوكيل كتابة نص برمجي لترتيب BM25 أو استخلاص متجهات الكلمات في دقائق. لم يعُد إنشاء عمليات التنفيذ المرشحة هو العقبة. إنّ معرفة ما إذا كان التغيير مفيدًا (أو أدى إلى تعطُّل %9 من عمليات البحث في الإصدار العلني بدون إشعار، مثلما حدث مع بوابة 0.38) هي المهمة الأساسية تقريبًا.
إليك كيفية تعاملنا مع هذا النظام:
- حدِّد الهدف الرئيسي واستثمِر في مجموعة أدوات القياس بدلاً من أي عملية تنفيذ واحدة. لقد قضينا وقتًا أطول في إنشاء
pnpm benchmark:rag، وتنظيم 5,000 طلب بحث حقيقي، ومعايرة التقييم الآلي مقارنةً بالتقييمات البشرية، مقارنةً بالوقت الذي قضيناه في كتابة أي أداة استرجاع. - أنشئوا قواعد تقييم لكيفية تقييمكم أنتم وموظفو الدعم للجودة، وتوقَّعوا أن تتطوّر هذه القواعد بعد تطبيقها على بيانات واقعية. يُطلق على هذا النهج اسم "القياس أولاً"، وهو صحيح جزئيًا فقط: يمكنك كتابة عمليات تحقّق أساسية من الإجابات المعروفة في اليوم الأول، ولكن لا يمكنك تصميم معيار تقييم جيد في فراغ قبل فحص حالات الإخفاق الحقيقية (يُطلق "شانكار" وآخرون على هذا اسم انحراف المعايير في Who Validates the Validators?). عندما لاحظنا أنّ الوكلاء يلجأون إلى استخدام 1,500 رمز مميّز
listكحلّ بديل، اضطررنا إلى فرض عقوبات على تضخّم الرموز المميّزة إلى جانب الاستدعاء. - بعد وضع قياسات موثوقة، يمكنك تجربة عمليات تنفيذ مختلفة بقوة والسماح للوحة النتائج بتسوية المناقشات حول البنية. بعد أن يقيّم مقياس الأداء 5,000 طلب بحث في ثوانٍ، لن تضطر إلى الجدال في طلبات الدمج حول ما إذا كانت حلقة
Int8المكوّنة من 7 أسطر يمكنها التفوّق على نموذج محوِّل بحجم 23 ميغابايت. جرِّب خمسة أساليب في فترة ما بعد الظهر واحتفِظ بالأسلوب الفائز.
وبالطبع، كل الرموز البرمجية (بما في ذلك أداة التضمين وأداة الاستخلاص ومجموعة أدوات قياس الأداء) مفتوحة المصدر.