


Veröffentlicht: 12. November 2026
Diese Woche haben wir Modern Web Guidance 1.0 eingeführt, einen Open-Source-Skill, der Coding-Agents dabei hilft, moderne Webplattform-Funktionen anstelle von Legacy-Workarounds zu verwenden. In diesem Beitrag geht es um die lokale Suchmaschine, die die relevanteste Anleitung für Ihre Aufgabe findet, ohne dass Sie Tokens verschwenden.
Wenn Sie einem Entwickler erzählen, dass Sie eine Wissensdatenbank mit 1,7 MB Markdown-Text für seinen KI-Agenten erstellt haben, wird er zwei Fragen stellen:
- „Wie viele Tokens werden dadurch in mein Kontextfenster übertragen?“
- „Welche Art von aufgeblähter Vektordatenbank ist dafür erforderlich?“
In den letzten sechs Monaten haben wir unsere lokale Abruf-Engine dreimal neu erstellt. Wir haben die Größe von 507 MB C++-Bindungen auf 23 MB reines JavaScript mit TensorFlow.js und dann auf ein 7 MB großes Paket reduziert, bei dem die Abfrageeinbettung eine 7-zeilige for-Schleife ist. Gleichzeitig haben wir die Genauigkeit verbessert.
Agentische RAG und progressive Offenlegung
Es ist nicht praktikabel, 1,7 MB Markdown-Text mit über 200 HTML-/CSS-/Web-API-Anleitungen in AGENTS.md zu übertragen. Wir glauben an die progressive Offenlegung, wissen aber, dass ein Markdown-Index bei großen Datenmengen nicht mehr token-effizient ist.
Um dieses Problem zu lösen, verwenden wir agentische RAG, die von einer Such-CLI unterstützt wird:
- Im Ruhezustand sieht der Agent nur die Beschreibung des Skills (~205 Tokens). Die Beschreibung entspricht den Richtlinien für Skill-Trigger von Anthropic, damit der Agent den Skill bei relevanten Frontend-Aufgaben aufruft.
- Bei Frontend-Aufgaben kann der Agent die CLI für die Suche verwenden:
modern-web-guidance search "animate height auto", wobei 10 relevante Übereinstimmungen (~530 Tokens) zurückgegeben werden. - Der KI-Agent führt
modern-web-guidance retrieve animate-to-intrinsic-sizesaus, um den gesamten Leitfaden (ca. 800 Tokens) abzurufen. Es ist jetzt mit den Best Practices für die Implementierung in Bezug auf Kompatibilität, Fallbacks und Technik ausgestattet.
Warum ein CLI-Skill statt eines MCP-Servers oder einer Websuche?
- MCP-Tools verschwenden entweder Tokens oder haben unzuverlässige Triggermechanismen (aufgrund der dynamischen Toolerkennung). Die Beschreibung unseres Skills ist auf maximale Effektivität optimiert und ermöglicht es dem Agenten, nur dann auf die Anleitung zuzugreifen, wenn es angemessen ist.
- Die integrierte Websuche liefert Stack Overflow-Antworten und Referenzdokumente aus dem Jahr 2015 anstelle von aktuellen, kuratierten
DO-/DO NOT-Implementierungsmustern. Außerdem dauert es über das Netzwerk Sekunden und schlägt in Offline-Sandboxes fehl, während die lokale Befehlszeile in Millisekunden auf der CPU ausgeführt wird.
Gen 1: Der 507 MB große C++-Prototyp
Die erste Version von Modern Web Guidance verwendete einen lokalen RAG-Stack: LanceDB, Apache Arrow und Transformers.js mit onnxruntime-native.
Auf einem Entwicklungscomputer funktionierte das gut, aber für einen Agent-Skill war es nicht optimal:
- Wenn Sie einem Projekt eine Fähigkeit hinzufügen (oder ein Agent sie mit
npxaufruft), möchten Sie nicht auf einennpm installwarten, der architekturabhängige.node-Binärdateien herunterlädt, oder auf einenode-gyp-C++-Kompilierung, die in Cloud-Sandboxen regelmäßig fehlschlägt. - Das extrahierte Verzeichnis
node_moduleshatte eine Größe von 507 MB.
2. Generation: TensorFlow.js auf 23 MB reduzieren
Wir wollten keine native Kompilierung und sofortige Ausführung überall dort, wo Node ausgeführt wird. Im April haben wir den nativen Stack durch eine reine JavaScript-CPU-Engine ersetzt, die all-MiniLM-L6-v2 auf @tensorflow/tfjs ausführt:
onnxruntime-nodein esbuild wurde entfernt und der Hugging Face-Tokenizer wurde durch einen kleinen In-Tree-BERT-WordPiece-Tokenizer ersetzt (0 Token-ID-Abweichungen).- Nachdem wir uns die Quellzuordnung angesehen hatten, haben wir die über 400 Module von
@tensorflow/tfjs-backend-cpuauf die 26 Kernel reduziert, die MiniLM tatsächlich verwendet. Dadurch wurde die JS-Engine von 6 MB auf 830 KB verkleinert. - LanceDB wurde zugunsten von mit gzip komprimierten Vektoren zur Build-Zeit und einem speicherinternen
<1 ms-Skalarprodukt-Scan über alle etwa 200 Anleitungen hinweg entfernt. - Platzieren Sie den Embedder hinter einem
import()-Aufruf, damitretrieveundlistin weniger als zehn Millisekunden abgeschlossen werden.
Dadurch wurde das npm-Paket auf 23 MB ohne Laufzeitabhängigkeiten reduziert. Wir haben es veröffentlicht und die Kundenservicemitarbeiter haben etwa 750.000 Suchanfragen damit durchgeführt.
Wo MiniLM in der Produktion fehlerhaft war
Nach einigen Monaten haben wir uns die Verläufe angesehen, bei denen die KI-Agenten die Fähigkeit installiert hatten, aber trotzdem Legacy-Code geschrieben haben.
In einem Codex-Lauf bat ein Entwickler um eine Bestätigungsaufforderung zum Löschen. Wir haben einen ganzen Leitfaden zum Erstellen barrierefreier Bestätigungsmodale mit HTML-<dialog closedby="any">.
Der KI-Agent hat das Richtige getan und Folgendes gesucht:
npx modern-web-guidance@latest search "confirm destructive action"
Die Befehlszeile hat [] zurückgegeben. Der Agent zuckte also mit den Schultern und schrieb window.confirm().
Warum wurde eine leere Antwort zurückgegeben? Als wir uns die Logs und Einbettungen genauer angesehen haben, sind uns zwei Lücken beim Abrufen aufgefallen:
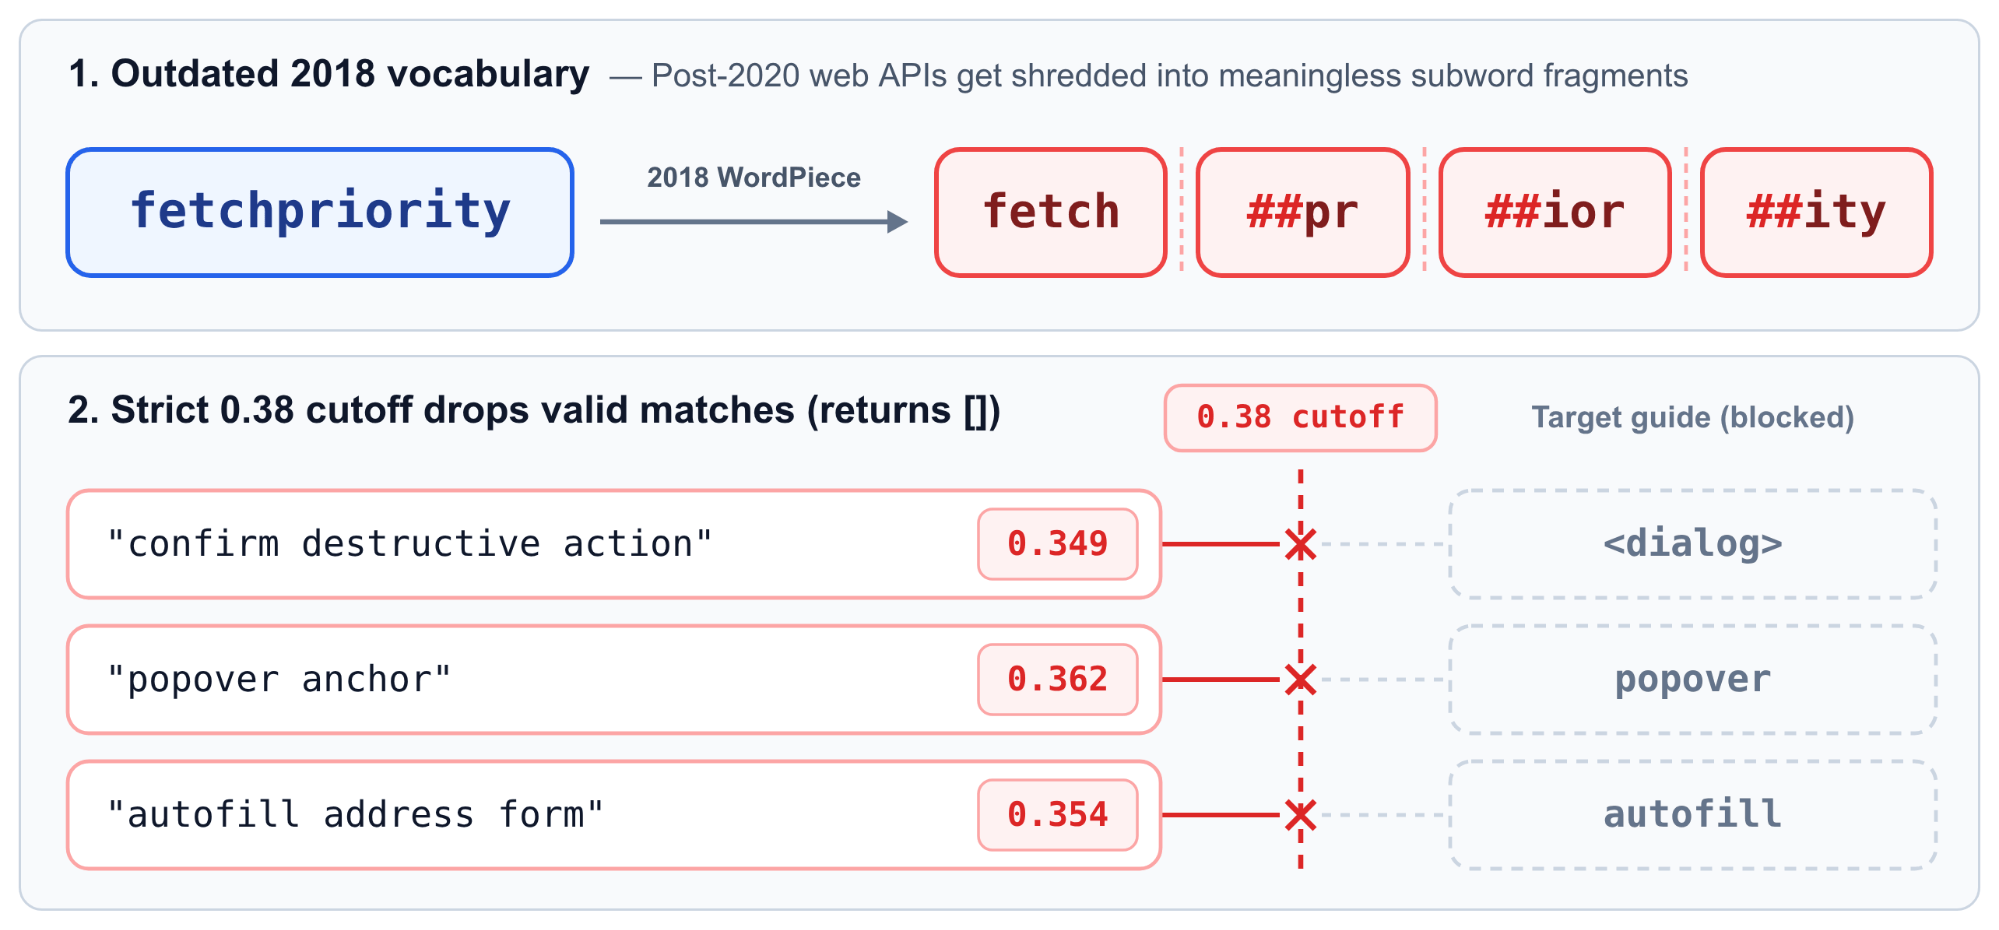
all-MiniLM-L6-v2wurde etwa 2018–2020 trainiert, sodass das WordPiece-Vokabular buchstäblich nicht weiß, dass Web-APIs nach 2020 existieren. Wenn ein KI-Agent nachfetchpriority,popoveroderstartViewTransitionsucht, zerlegt der Tokenizer von 2018fetchpriorityin vier bedeutungslose Unterwörter:fetch·##pr·##ior·##ity.- Um zu verhindern, dass bei Abfragen außerhalb des Bereichs zufällige Anleitungen zurückgegeben werden, wurde in einem früheren PR ein strikter Grenzwert für die Kosinusähnlichkeit von
0.38hinzugefügt. Da MiniLM die 3-Wort-Phrase"confirm destructive action"nicht mit"dialog"über0.38verknüpfen konnte (Wertung0.349, während"popover anchor"0.362und"autofill address form"0.354erhielt), wurden gültige Übereinstimmungen verworfen. Schlimmer noch: Jedes Mal, wennsearchden Wert[]zurückgab, wurde der KI-Agent gemäß den Skill-Anweisungen angewiesen, aufmodern-web-guidance listzurückzugreifen. Dadurch wurden alle ca. 200 Anleitungsbeschreibungen (ca. 1.500 verschwendete Tokens) in den Kontext eingefügt.
Abruf korrigieren: echte Telemetrie, Hybridsuche und 10 Ergebnisse zurückgeben
Unser ursprünglicher Benchmark waren 850 synthetische Abfragen, die aus den Leitfäden selbst generiert wurden. Diese entsprachen der Formulierung der Leitfäden zu genau, um diese Fehler zu erkennen. Deshalb haben wir ein neues Bewertungssystem (pnpm benchmark:rag) entwickelt, das auf 4.000 Live-Suchen basiert. Diese wurden aus der CLI-Telemetrie (die nur das 2–5 Wörter lange search-Argument des Agenten protokolliert, niemals Nutzerprompts oder Repository-Code, und DISABLE_TELEMETRY=1 berücksichtigt) entnommen. Außerdem wurden 1.029 Suchen aus nächtlichen Agentenbewertungen in Claude Code, Codex CLI und Gemini CLI verwendet.
Als wir unseren Git-Verlauf mit diesen zurückgehaltenen Abfragen verglichen, stellten wir fest, dass der Grenzwert von 0.38 die Anzahl leerer []-Antworten um das Achtfache erhöht hatte. Mit dem Benchmark konnten wir zwei schnelle Verbesserungen erzielen, bevor wir das Einbettungsmodell angepasst haben:
- Hybride Keyword- und semantische Suche: Dichte Vektoren verschleiern genaue API-Namen (
:user-invalid,showModal,details-name), während die Keyword-Suche Intent-Anfragen verpasst, wenn der Agent den API-Namen nicht kennt. Wir haben einen BM25-Keyword-Index (wenn Sie wissen, was wir meinen) ohne Abhängigkeiten mit Plural-Stemming hinzugefügt, dieweb-feature-idsder einzelnen Leitfäden indexiert und BM25 mit semantischem Ranking zusammengeführt.searchgibt jetzt nur dann[]zurück, wenn sowohl die semantische Ähnlichkeit<0.30ist als auch BM25 keine Keyword-Treffer hat. - 10 kompakte Ergebnisse statt 5 ausführliche: In den Skill-Anweisungen wurden die Kundenservicemitarbeiter bereits angewiesen,
similarityundtokenCountzu ignorieren. Durch das Entfernen dieser ungenutzten Felder passen 10 kompakte{id, description}-Ergebnisse in genau dasselbe Budget von ca. 530 Tokens wie 5 ausführliche Ergebnisse:
// Before: 5 verbose results (~105 tokens each = ~525 tokens)
{
  "id": "dialog",
  "category": "html",
  "description": "Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby.",
  "featuresUsed": ["dialog", "dialog-closedby"],
  "tokenCount": 780,
  "similarity": 0.49
}
// After: 10 compact results (~53 tokens each = ~530 tokens)
{"id":"dialog","description":"Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby."}
Zusammen haben diese beiden Änderungen unsere Suchtrefferquote bei zurückgehaltenen Telemetrieabfragen von 80,6 % auf 94,7 % erhöht, gemessen als Hit@K (ob die erwartete Anleitung in den Top-K-Ergebnissen erscheint).
Gen 3: Vorgefertigte Einbettungen und eine for-Schleife mit 7 Zeilen
Selbst bei einer Trefferquote von 94.7% zeigte unsere Telemetrie eine eklatante Diskrepanz: 86, 7 % der Suchanfragen an den Live-Agenten waren nur 2 bis 5 Wörter lang (Median: 3 Wörter). Jedes Mal, wenn ein Kundenservicemitarbeiter nach einer Wortgruppe mit drei Wörtern suchte, startete Node TensorFlow.js, parste ein neuronales Netzwerk mit 22,6 MB und verbrauchte 770 ms Kaltstartlatenz und 346 MB RAM-Spitzenwert.
Als wir ihn fragten, ob es eine einfachere Möglichkeit gibt, 3-Wort-Abfragen ohne neuronales Netz einzubetten, schlug unser Antigravity-Agent eine Reihe unbekannter ML-Destillationstechniken vor: Model2Vec, Tokenlearn, Matryoshka-Dimensionen und Adagrad. (Wenn du dich für die technischen Details interessierst, findest du weitere Informationen auf unserer Seite zur Suchqualität.)
Bei der standardmäßigen lokalen RAG werden sowohl Dokumente als auch Abfragen durch dasselbe kleine Modell auf der CPU des Nutzers geleitet. Unsere rund 200 Anleitungen ändern sich jedoch nicht, nachdem wir eine npm-Version veröffentlicht haben. Es gibt also keinen Grund, sie mit einem kleinen Modell aus dem Jahr 2018 einzubetten. Stattdessen werden in embed-guide-chunks.ts alle Guide-Vektoren bei der Veröffentlichung in der Cloud mit gemini-embedding-001 vorab erstellt und als binäre 256-dimensionale Int8-Vektoren (guide-chunks.i8, 335 KB mit gzip komprimiert) bereitgestellt.
Wie projiziert eine Offline-CLI ohne API-Schlüssel die Live-Abfrage eines Nutzers in genau denselben Gemini-Vektorraum? Da Agentenabfragen fast immer 2 bis 5 Wörter lang sind, benötigen wir zur Laufzeit keinen Transformer. Wir benötigen nur eine Suchtabelle mit Vektoren für bekannte Wörter (table) und eine intelligente Methode, um sie zu summieren. Zur Laufzeit wird die gesamte 23 MB große TensorFlow.js-Pipeline in eine 7-zeilige for-Schleife in static-embedder.ts komprimiert:
// Each word's weight and Int8 scale are pre-folded into `scales[i]`
for (const [i, f] of enc) {
  const wt = scales[i] * f;
  const offset = i * 256;
  for (let k = 0; k < 256; k++) {
    out[k] += wt * table[offset + k];
  }
}
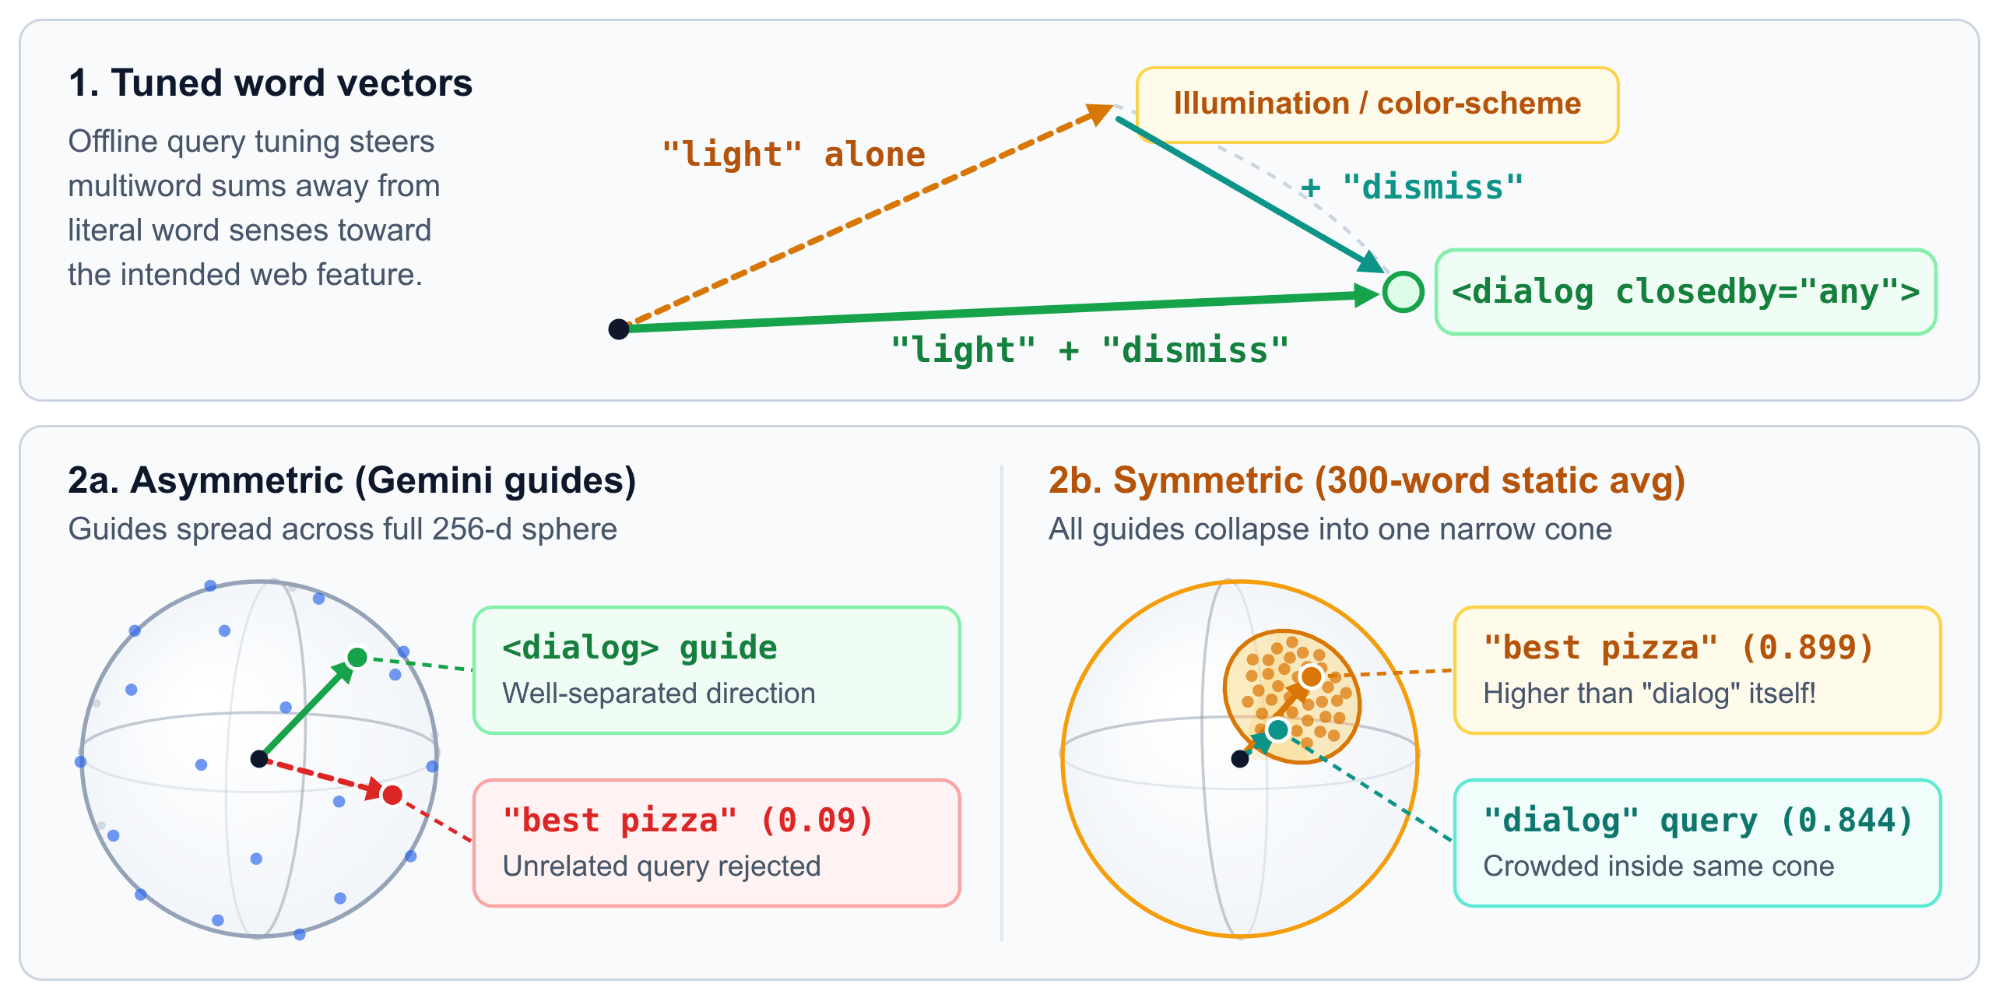
Um diese Suchtabelle (train-query-words.ts) zu erstellen, haben wir ein Vokabular mit 29.165 Wörtern verwendet, in dem moderne Webbegriffe wie fetchpriority, light-dismiss, popover und scrollytelling eigenständige ganze Wörter sind. Wir haben sie mit gemini-embedding-001 eingebettet und die Wortvektoren offline mit 33.000 echten Websuchanfragen abgeglichen, damit Kombinationen aus mehreren Wörtern an der richtigen Stelle landen (z. B. "light" + "dismiss" verweist auf <dialog closedby="any">, nicht auf Beleuchtung oder Farbschemata). Komprimiert auf Int8 (query-words.i8) ist die gesamte Suchtabelle 5.3 MB gzipped.
Warum verwenden wir nicht diese statische Suchtabelle, um auch die Leitfäden einzubetten, und überspringen den Cloud Build-Schritt? Wir haben das zuerst versucht, aber es hat bei ganzen Absätzen nicht funktioniert: Die Summe von 3 Suchbegriffen bleibt scharf, aber die Mittelung von Hunderten von Wörtern über einen ganzen Leitfaden hinweg führt dazu, dass jeder Leitfaden in einen engen Kegel in der Nähe des generischen englischen Durchschnitts zusammenbricht (so weit, dass "best pizza in new york" eine Kosinusähnlichkeit von 0.899 gegenüber unserem dialog-Leitfaden erreichte, was höher ist als die Suchanfrage "dialog" selbst mit 0.844!). Die Kombination von statischen 3-Wort-Suchanfragen (query-words.i8) mit Gemini-Leitfaden-Einbettungen des vollständigen Modells (guide-chunks.i8) bietet uns eine Genauigkeit auf Cloud-Niveau, während Suchanfragen weiterhin offline in 30 µs ausgeführt werden.
Die Anzeigetafel für alle drei Generationen
Im Laufe unserer Release-Meilensteine stieg der Hit@K von 78,2 % mit Einbettungen für das gesamte Dokument auf 95,4 % mit dem statischen Int8-Embedder (im Vergleich zu 96,9 % mit der Cloud-gemini-embedding-001-API):
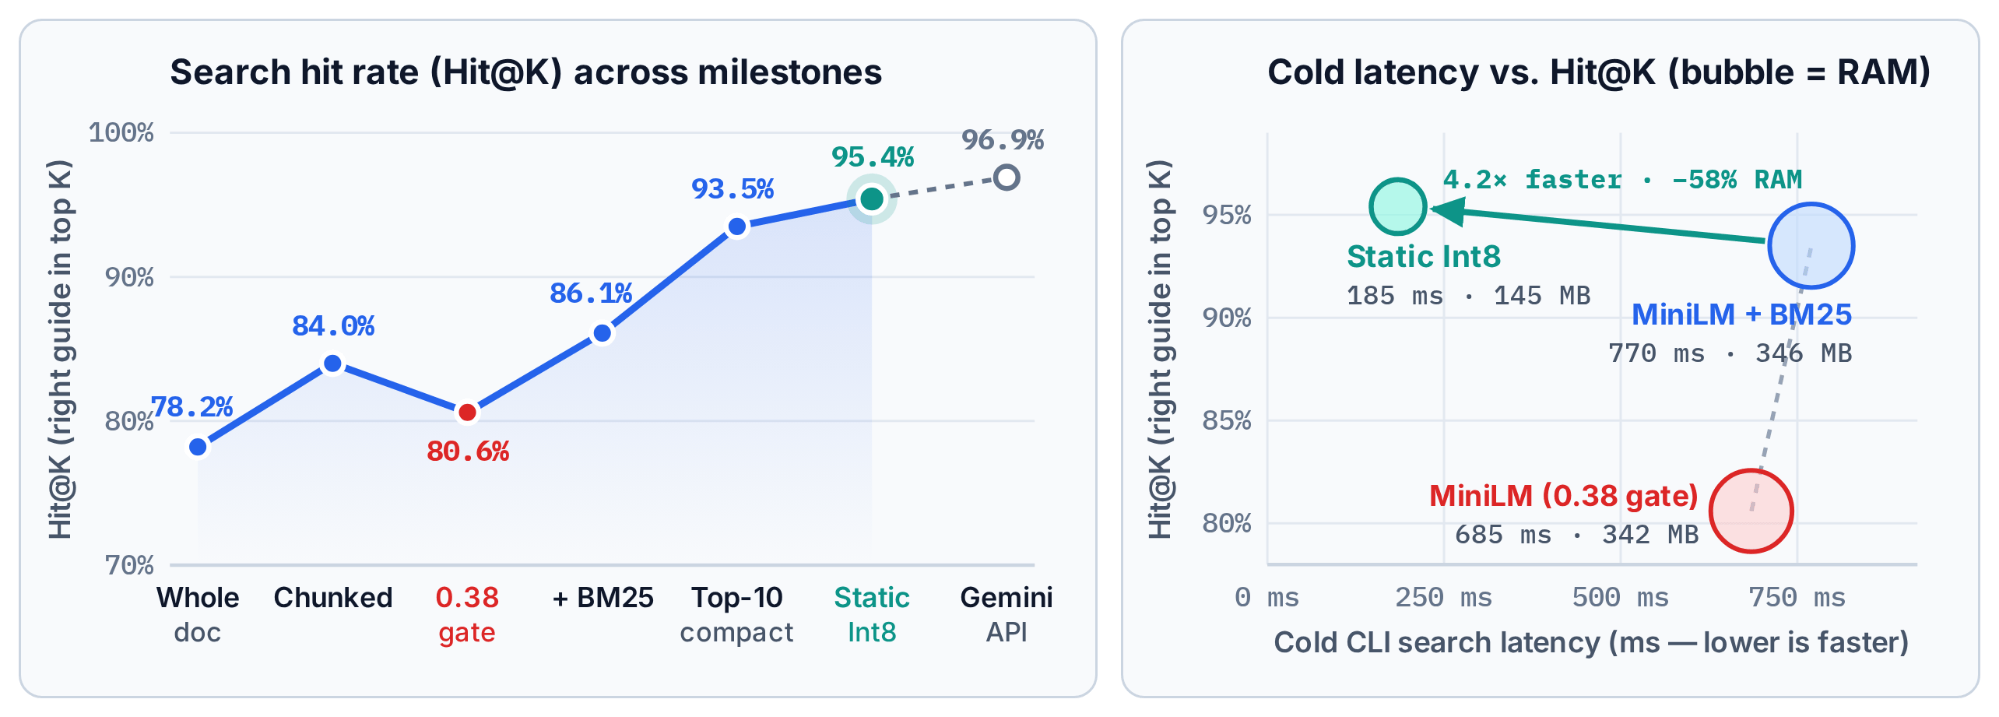
So schneiden die drei Generationen nach der Einführung des statischen Embedders ab:
Wenn Sie die fehlerhafte Codex-Abfrage von vorhin ausführen:
npx modern-web-guidance@latest search "confirm destructive action"
Der Leitfaden „dialog“ wird ganz oben in der Liste angezeigt.
(In unserem Search Quality Dashboard finden Sie interaktive Diagramme zu allen Meilensteinen, Abfragelängen und K-Horizonten.)
Code ist billig; Messen ist die Arbeit
Ein Agent kann innerhalb von Minuten ein BM25-Ranking- oder ein Wortvektor-Destillationsskript schreiben. Das Generieren von Kandidatenimplementierungen ist nicht mehr der Engpass. Zu wissen, ob eine Änderung tatsächlich geholfen hat (oder ob sie, wie unser 0.38-Gate, 9 % der Produktionssuchanfragen unbemerkt beeinträchtigt hat), ist fast die gesamte Aufgabe.
So sind wir vorgegangen:
- Definieren Sie das Hauptziel und investieren Sie in die Messumgebung, anstatt sich auf eine einzelne Implementierung zu konzentrieren. Wir haben viel mehr Zeit damit verbracht,
pnpm benchmark:ragzu erstellen,5.000 echte Abfragen auszuwählen und unsere automatisierte Bewertung mit menschlichen Bewertungen abzugleichen, als einen Retriever zu schreiben. - Erstellen Sie eine Rubrik, nach der Sie und Ihre Agenten die Qualität beurteilen, und rechnen Sie damit, dass sich diese Rubrik weiterentwickelt, sobald sie auf reale Daten angewendet wird. Das wird oft als „Messung zuerst“ bezeichnet, was aber nur die halbe Wahrheit ist: Sie können am ersten Tag einfache Prüfungen mit bekannten Antworten schreiben, aber Sie können keine gute Rubrik im Vakuum entwerfen, bevor Sie echte Fehler untersucht haben. Shankar et al. nennen das in Who Validates the Validators? Kriterienverschiebung. Als wir sahen, dass Agenten 1.500-Token-
list-Fallbacks auslösten, mussten wir Token-Bloat neben Recall bestrafen. - Wenn Sie zuverlässige Messungen eingerichtet haben, können Sie mit verschiedenen Implementierungen experimentieren und die Architekturdebatten anhand der Ergebnisse beilegen. Wenn ein Benchmark 5.000 Abfragen in Sekunden bewertet,müssen Sie in PRs nicht mehr darüber diskutieren, ob eine 7-zeilige
Int8-Schleife einen 23-MB-Transformer schlagen kann. Probieren Sie an einem Nachmittag fünf Ansätze aus und behalten Sie den besten.
Der gesamte Code (einschließlich Embedder, Distiller und Benchmark-Harness) ist natürlich Open Source.