


Publicación: 12 de noviembre de 2026
Esta semana, lanzamos Modern Web Guidance 1.0, una habilidad de código abierto que ayuda a los agentes de programación a usar funciones modernas de la plataforma web en lugar de soluciones alternativas heredadas. En esta publicación, se analiza el motor de búsqueda local que encuentra la guía más pertinente para tu tarea sin desperdiciar tus tokens.
Si le dices a un ingeniero que creaste una base de conocimiento con 1.7 MB de texto de Markdown para su agente de programación, te hará dos preguntas:
- "¿Cuántos tokens se volcarán en mi ventana de contexto?"
- "¿Qué tipo de base de datos vectorial sobrecargada requiere?"
En los últimos seis meses, reconstruimos nuestro motor de recuperación local tres veces. Pasamos de 507 MB de vinculaciones de C++ a 23 MB de JavaScript puro con TensorFlow.js y, luego, a un paquete de 7 MB en el que la incorporación de consultas es un bucle for de 7 líneas, todo mientras mejoramos la precisión.
RAG agéntica y divulgación progresiva
No es práctico volcar 1.7 MB de texto Markdown que contiene más de 200 guías de HTML/CSS/API web en AGENTS.md. Creemos en la divulgación progresiva, pero sabemos que un índice de Markdown dejará de ser eficiente en términos de tokens a gran escala.
Para resolver este problema, usamos una RAG agéntica respaldada por una CLI de búsqueda:
- En reposo, el agente solo ve la descripción de la habilidad (aprox. 205 tokens). La descripción sigue los lineamientos de activación de habilidades de Anthropic para que el agente invoque la habilidad en las tareas de frontend pertinentes.
- En las tareas de frontend, el agente puede usar la CLI para buscar:
modern-web-guidance search "animate height auto", lo que genera 10 coincidencias relevantes (~530 tokens). - El agente ejecuta
modern-web-guidance retrieve animate-to-intrinsic-sizespara extraer toda la guía (alrededor de 800 tokens). Ahora, está equipado con las prácticas recomendadas de implementación para la compatibilidad, los resguardos y la técnica.
¿Por qué una habilidad de la CLI en lugar de un servidor de MCP o una búsqueda web?
- Las herramientas de MCP desperdician tokens o tienen mecanismos de activación poco confiables (debido al descubrimiento dinámico de herramientas). La descripción de nuestra habilidad está optimizada para lograr la máxima eficacia y permite que el agente consuma orientación solo cuando sea apropiado.
- La búsqueda web integrada muestra respuestas de Stack Overflow de 2015 y documentos de referencia en lugar de patrones de implementación de
DO/DO NOTactualizados y seleccionados. También tarda segundos en la red y falla en las zonas de pruebas sin conexión, mientras que la CLI local se ejecuta en la CPU en milisegundos.
1ª gen.: El prototipo de C++ de 507 MB
La primera versión de Modern Web Guidance usaba una pila de RAG local: LanceDB, Apache Arrow y Transformers.js con onnxruntime-native.
Funcionaba bien en una máquina de desarrollo, pero no se adaptaba bien a una habilidad de agente:
- Cuando agregas una habilidad a un proyecto (o un agente la invoca con
npx), no esperas que unnpm installdescargue objetos binarios de.nodeque dependen de la arquitectura o una compilación de C++ denode-gypque suele fallar en entornos de pruebas de la nube. - El directorio
node_modulesextraído pesaba 507 MB.
2ª gen.: Reducción de TensorFlow.js a 23 MB
Queríamos que no hubiera compilación nativa y que la ejecución fuera instantánea en cualquier lugar donde se ejecute Node. Por lo tanto, en abril, reemplazamos la pila nativa por un motor de CPU de JavaScript puro que ejecuta all-MiniLM-L6-v2 en @tensorflow/tfjs:
- Se eliminó
onnxruntime-nodeen esbuild y se reemplazó el tokenizador de Hugging Face por un tokenizador de WordPiece de BERT pequeño en el árbol (0 discrepancias de ID de token). - Después de explorar algunos mapas de origen, redujo los más de 400 módulos de
@tensorflow/tfjs-backend-cpua los 26 kernels que MiniLM realmente usa, lo que redujo el motor de JS de 6 MB a 830 KB. - Se eliminó LanceDB para los vectores comprimidos con gzip en el momento de la compilación y un análisis de producto escalar
<1 msen memoria en las aproximadamente 200 guías. - Coloca el incorporador detrás de una llamada
import()para queretrieveylistfinalicen en menos de diez milisegundos.
Eso redujo el paquete de npm a 23 MB sin dependencias del entorno de ejecución. Lo lanzamos y los agentes realizaron alrededor de 750,000 búsquedas con él.
Dónde se rompió MiniLM en producción
Un par de meses después, analizamos las trayectorias en las que los agentes tenían instalada la habilidad, pero seguían escribiendo código heredado.
En una ejecución de Codex, un desarrollador solicitó un mensaje de confirmación de eliminación. Tenemos una guía completa sobre cómo crear modales de confirmación accesibles con el elemento <dialog closedby="any"> de HTML.
El agente hizo lo correcto y buscó lo siguiente:
npx modern-web-guidance@latest search "confirm destructive action"
La CLI devolvió []. Por lo tanto, el agente se encogió de hombros y escribió window.confirm().
¿Por qué se devolvió vacío? Cuando analizamos los registros y los embeddings, se destacaron dos brechas de recuperación:
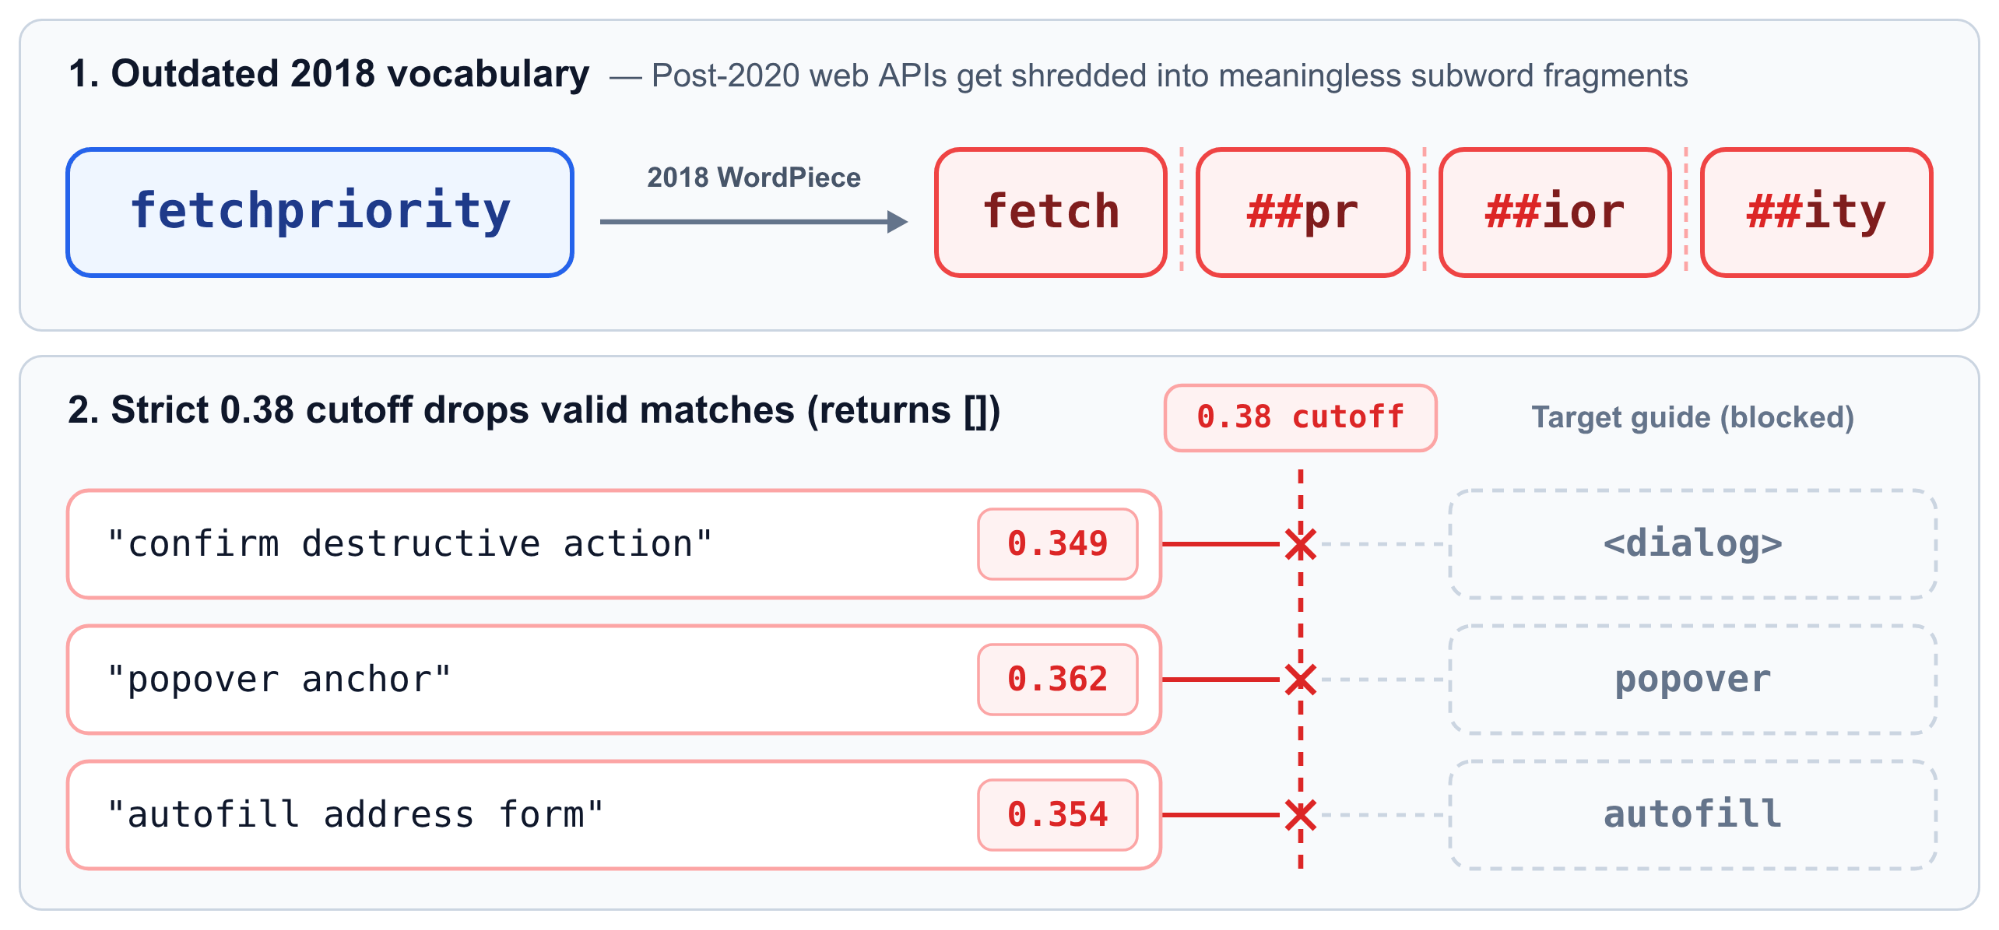
all-MiniLM-L6-v2se entrenó entre 2018 y 2020, por lo que su vocabulario de WordPiece literalmente no sabe que existen las APIs web posteriores a 2020. Cuando un agente buscafetchpriority,popoverostartViewTransition, el asignador de token de 2018 dividefetchpriorityen cuatro subpalabras sin sentido:fetch·##pr·##ior·##ity.- Para evitar que las consultas fuera de alcance devuelvan guías aleatorias, una solicitud de extracción anterior había agregado un límite estricto de similitud de coseno de
0.38. Debido a que MiniLM no pudo vincular la frase de 3 palabras"confirm destructive action"con"dialog"por encima de0.38(puntuación0.349, mientras que"popover anchor"obtuvo0.362y"autofill address form"obtuvo0.354), la puerta descartó las coincidencias válidas. Peor aún, cada vez quesearchdevolvía[], las instrucciones de nuestra habilidad le indicaban al agente que recurriera amodern-web-guidance list, lo que volcaba las aproximadamente 200 descripciones de guías (~1,500 tokens desperdiciados) en el contexto.
Corrige la recuperación: telemetría real, búsqueda híbrida y devolución de 10 resultados
Nuestra comparativa original era de 850 consultas sintéticas generadas a partir de las guías, que coincidían demasiado con la redacción de las guías como para detectar estos errores. Por lo tanto,creamos un nuevo sistema de evaluación (pnpm benchmark:rag) en torno a 4, 000 búsquedas en vivo extraídas de la telemetría de la CLI de exclusión (que solo registra el argumento search de 2 a 5 palabras del agente, nunca las instrucciones del usuario ni el código del repositorio,y respeta DISABLE_TELEMETRY=1) más 1, 029 búsquedas extraídas de las evaluaciones nocturnas del agente en Claude Code, Codex CLI y Gemini CLI.
Cuando reprodujimos nuestro historial de Git con esas consultas retenidas, vimos que el límite de 0.38 había aumentado las respuestas [] vacías 8 veces. Con la comparativa establecida, implementamos dos mejoras rápidas antes de tocar el modelo de embeddings:
- Búsqueda semántica y de palabras clave híbrida: Los vectores densos difuminan los nombres exactos de las APIs (
:user-invalid,showModal,details-name), mientras que la búsqueda de palabras clave pasa por alto las consultas de intención cuando el agente no conoce el nombre de la API. Agregamos un índice de palabras clave BM25 (si lo sabes, lo sabes) sin dependencias con lematización de plurales, indexamos elweb-feature-idsde cada guía y fusionamos BM25 con la clasificación semántica. Ahora,searchsolo devuelve[]cuando la similitud semántica es<0.30y BM25 tiene cero coincidencias de palabras clave. - 10 resultados compactos en lugar de 5 detallados: Las instrucciones de la habilidad ya les indicaron a los agentes que ignoraran
similarityytokenCount. Quitando esos campos sin usar, podemos incluir 10 resultados compactos de{id, description}en el mismo presupuesto de ~530 tokens que 5 resultados detallados:
// Before: 5 verbose results (~105 tokens each = ~525 tokens)
{
  "id": "dialog",
  "category": "html",
  "description": "Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby.",
  "featuresUsed": ["dialog", "dialog-closedby"],
  "tokenCount": 780,
  "similarity": 0.49
}
// After: 10 compact results (~53 tokens each = ~530 tokens)
{"id":"dialog","description":"Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby."}
En conjunto, estos dos cambios aumentaron nuestra tasa de aciertos de búsqueda en las consultas de telemetría retenidas del 80.6% al 94.7%, medida como Hit@K (si la guía esperada aparece en los primeros K resultados).
Tercera generación: Incorporaciones predefinidas y un bucle for de 7 líneas
Incluso con una tasa de aciertos del 94.7%, nuestra telemetría mostró una discrepancia evidente: el 86.7% de las búsquedas de agentes humanos tenían solo entre 2 y 5 palabras (mediana: 3 palabras). Cada vez que un agente buscaba una frase de 3 palabras, Node iniciaba TensorFlow.js, analizaba una red neuronal de 22.6 MB y consumía 770 ms de latencia de inicio en frío y 346 MB de RAM máxima.
Cuando le preguntamos si había una forma más ligera de incorporar consultas de 3 palabras sin una red neuronal, nuestro agente de Antigravity nos devolvió una pila de técnicas de síntesis de ML desconocidas: Model2Vec, Tokenlearn, dimensiones de Matryoshka y AdaGrad. (Si quieres conocer los detalles técnicos, hay más información en nuestra página de calidad de la búsqueda).
La RAG local estándar fuerza tanto los documentos como las consultas a través del mismo modelo pequeño en la CPU del usuario. Sin embargo, nuestras ~200 guías no cambian después de que lanzamos una versión de npm, por lo que no hay motivo para incorporarlas con un modelo pequeño de 2018. En cambio, embed-guide-chunks.ts precalcula todos nuestros vectores de guía en el momento del lanzamiento en la nube con gemini-embedding-001 y los envía como vectores Int8 binarios de 256 dimensiones (guide-chunks.i8, 335 KB comprimidos con gzip).
¿Cómo un proyecto de CLI sin conexión y sin clave de API proyecta la consulta en vivo de un usuario en ese mismo espacio vectorial de Gemini? Como las consultas de los agentes casi siempre tienen entre 2 y 5 palabras, no necesitamos un transformador en el entorno de ejecución. Solo necesitamos una tabla de consulta de vectores para palabras conocidas (table) y una forma inteligente de sumarlos. En el entorno de ejecución, toda la canalización de TensorFlow.js de 23 MB se contrae en un bucle for de 7 líneas en static-embedder.ts:
// Each word's weight and Int8 scale are pre-folded into `scales[i]`
for (const [i, f] of enc) {
  const wt = scales[i] * f;
  const offset = i * 256;
  for (let k = 0; k < 256; k++) {
    out[k] += wt * table[offset + k];
  }
}
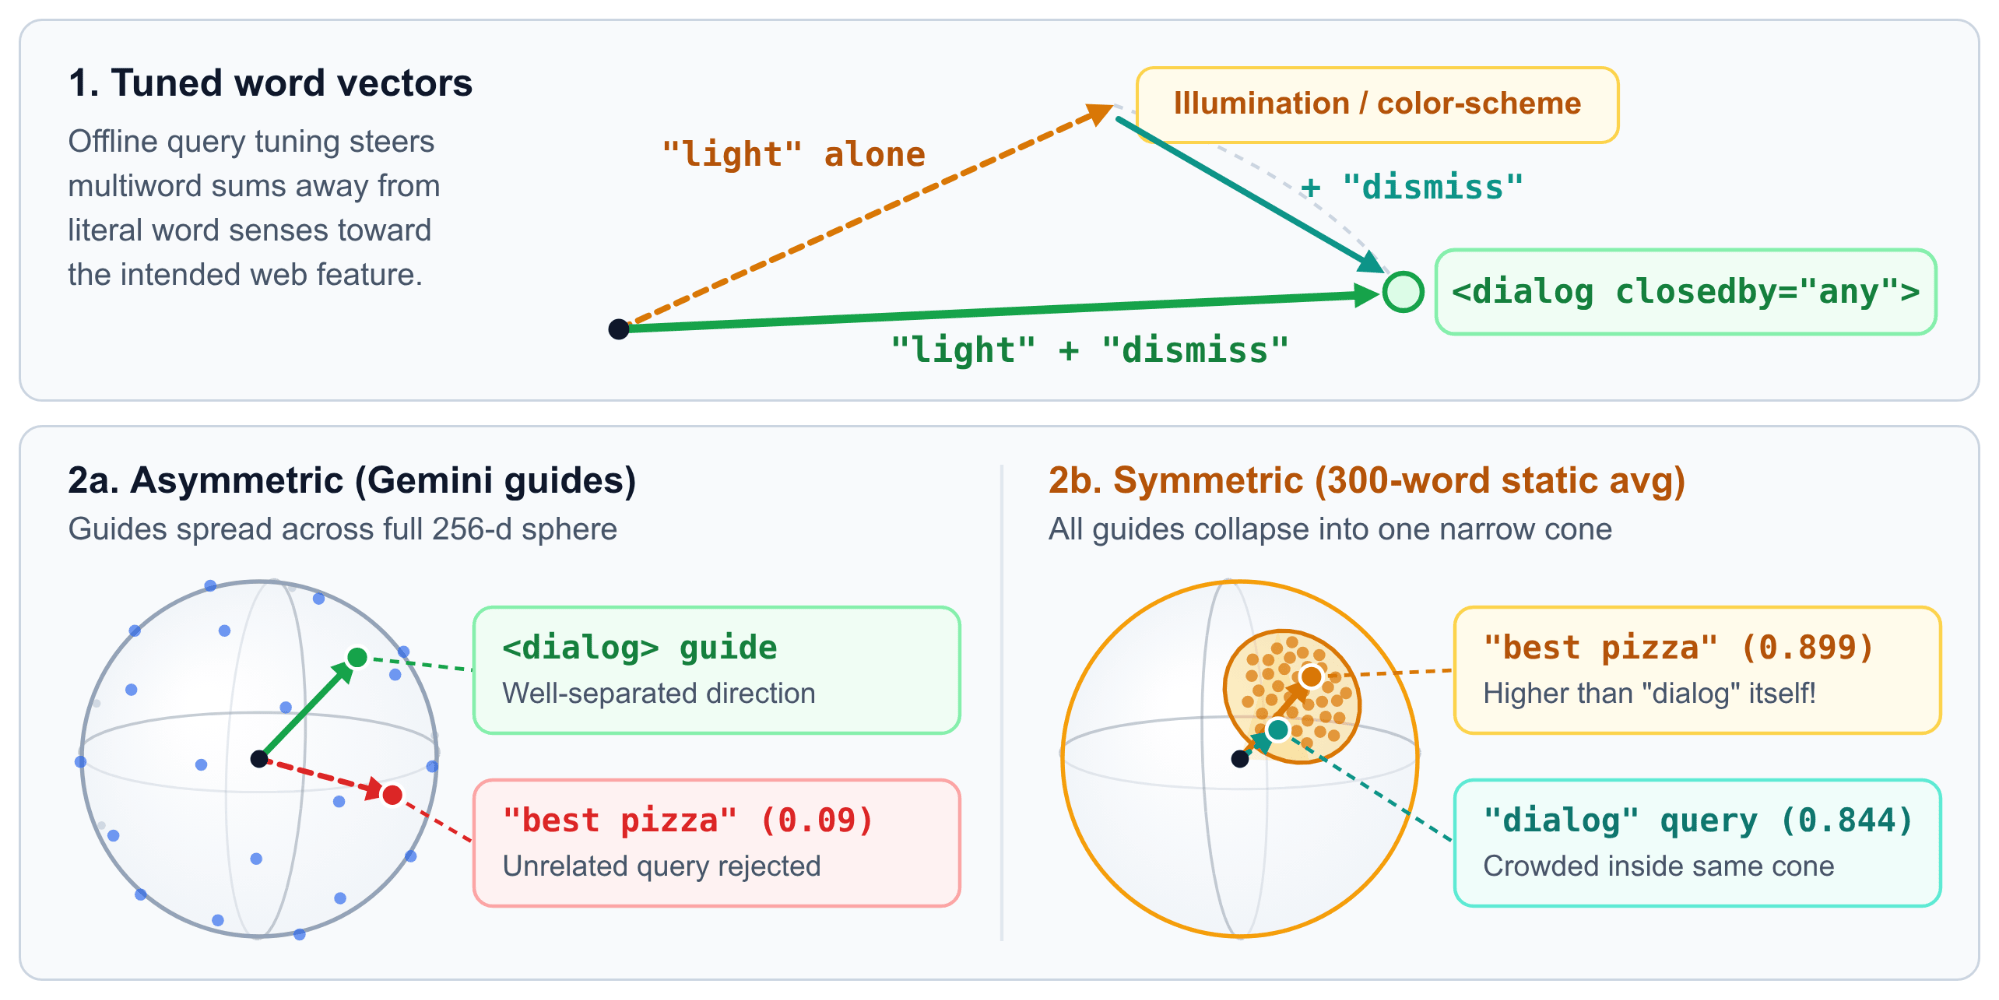
Para crear esa tabla de consulta (train-query-words.ts), tomamos un vocabulario de 29,165 palabras (en el que los términos web modernos como fetchpriority, light-dismiss, popover y scrollytelling son palabras completas independientes), las incorporamos con gemini-embedding-001 y ajustamos los vectores de palabras sin conexión con 33,000 búsquedas web reales para que las combinaciones de varias palabras se ubiquen en el lugar correcto (por ejemplo, "light" + "dismiss" apunta a <dialog closedby="any">, no a esquemas de iluminación o esquemas de colores). Comprimida a Int8 (query-words.i8), toda la tabla de consulta se comprime con gzip a 5.3 MB.
¿Por qué no usar esa tabla de consulta estática para incorporar también las guías y omitir el paso de Cloud Build? Intentamos eso primero, pero no funcionó con párrafos completos: sumar 3 palabras de búsqueda sigue siendo preciso, pero promediar cientos de palabras en una guía completa hace que todas las guías se reduzcan a un cono estrecho cerca del promedio genérico en inglés (hasta el punto en que "best pizza in new york" obtuvo una similitud de coseno de 0.899 con nuestra guía de dialog, ¡más alta que la búsqueda "dialog" en sí, que fue de 0.844!). Vincular búsquedas estáticas de 3 palabras (query-words.i8) con embeddings de guías de Gemini de modelo completo (guide-chunks.i8) nos brinda una precisión de nivel de nube, mientras que las búsquedas se siguen ejecutando sin conexión en 30 µs.
El marcador de las tres generaciones
En todos nuestros hitos de lanzamiento, Hit@K aumentó del 78.2% con embeddings de documentos completos al 95.4% con el incorporador estático de Int8 (en comparación con el 96.9% con la API de gemini-embedding-001 en la nube):
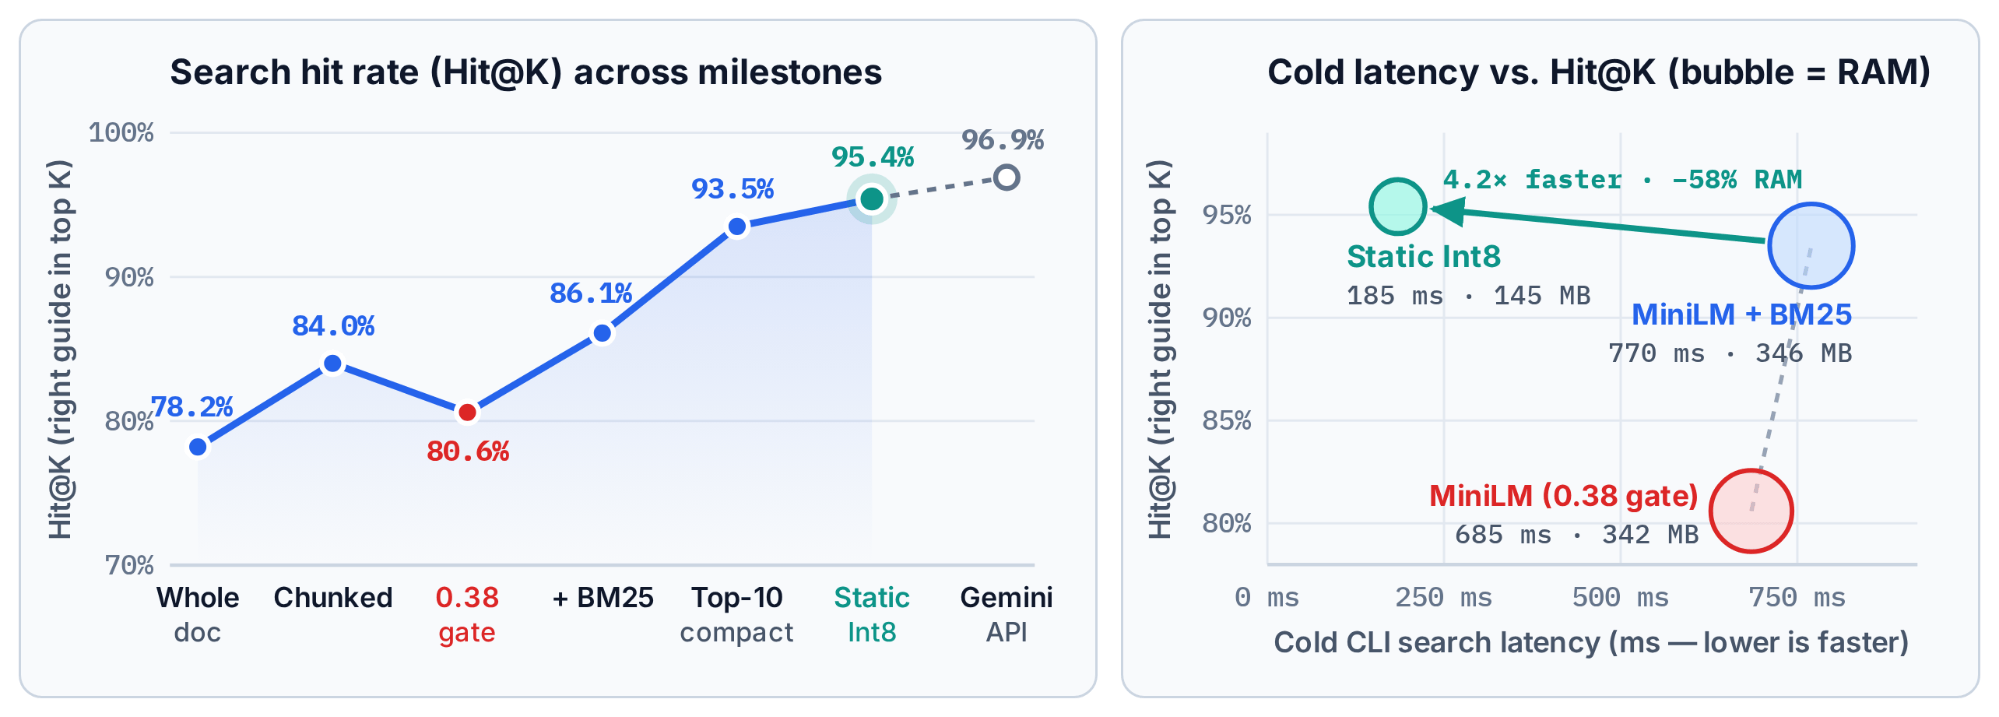
A continuación, se muestra cómo se comparan las tres generaciones después de incorporar el incorporador estático:
Y si ejecutas esa consulta de Codex que falló antes:
npx modern-web-guidance@latest search "confirm destructive action"
La guía de dialog volverá a aparecer en la parte superior de la lista.
(Puedes explorar los gráficos interactivos de todos los hitos, las longitudes de las consultas y los horizontes de K en nuestro panel de calidad de la búsqueda).
El código es barato; la medición es el trabajo
Un agente puede escribir un clasificador BM25 o una secuencia de comandos de destilación de vectores de palabras en minutos. Generar implementaciones candidatas ya no es el cuello de botella. Saber si un cambio realmente ayudó (o si interrumpió de forma silenciosa el 9% de las búsquedas de producción, como lo hizo nuestra puerta de enlace 0.38) es casi todo el trabajo.
A continuación, te mostramos cómo abordamos este sistema:
- Define el objetivo principal y, antes de realizar cualquier implementación, invierte en el sistema de medición. Dedicamos mucho más tiempo a compilar
pnpm benchmark:rag, seleccionar 5,000 consultas reales y calibrar nuestra calificación automatizada en comparación con las calificaciones humanas que a escribir cualquier recuperador. - Crea una rúbrica para que tú y tus agentes evalúen la calidad, y espera que evolucione una vez que se aplique a los datos del mundo real. Las personas llaman a esto "priorizar la medición", lo que es solo parcialmente correcto: puedes escribir verificaciones básicas de respuestas conocidas el primer día, pero no puedes diseñar una buena rúbrica en el vacío antes de inspeccionar las fallas reales (Shankar et al. llaman a esto desviación de criterios en Who Validates the Validators?). Ver que los agentes activan resguardos de 1,500 tokens de
listes lo que nos obligó a penalizar el exceso de tokens junto con la recuperación. - Con mediciones confiables, experimenta de forma agresiva con diferentes implementaciones y deja que el marcador resuelva los debates sobre la arquitectura. Una vez que una comparativa califica 5,000 consultas en segundos, no tienes que discutir en las PR sobre si un bucle
Int8de 7 líneas puede superar a un transformador de 23 MB. Prueba cinco enfoques en una tarde y quédate con el ganador.
Por supuesto, todo el código (incluidos el incorporador, el destilador y el arnés de comparativas) es de código abierto.