


Date de publication : 12 novembre 2026
Cette semaine, nous avons lancé Modern Web Guidance 1.0, une compétence Open Source qui aide les agents de codage à utiliser les fonctionnalités des plates-formes Web modernes au lieu de solutions de contournement obsolètes. Cet article s'intéresse au moteur de recherche local qui trouve le guide le plus pertinent pour votre tâche, sans gaspiller vos jetons.
Si vous dites à un ingénieur que vous avez créé une base de connaissances avec 1,7 Mo de texte Markdown pour son agent de codage, il vous posera deux questions :
- "Combien de jetons cela va-t-il ajouter à ma fenêtre de contexte ?"
- "De quel type de base de données vectorielle surchargée a-t-il besoin ?"
Au cours des six derniers mois, nous avons reconstruit notre moteur de récupération locale trois fois. Nous sommes passés de 507 Mo de liaisons C++ à 23 Mo de JavaScript pur à l'aide de TensorFlow.js, puis à un package de 7 Mo où l'embedding de requête est une boucle for de sept lignes, tout en améliorant la précision.
RAG agentique et divulgation progressive
Il n'est pas pratique de transférer 1,7 Mo de texte Markdown contenant plus de 200 guides d'API HTML/CSS/Web dans AGENTS.md. Nous croyons en la divulgation progressive, mais nous savons qu'un index Markdown cessera d'être efficace en termes de jetons à grande échelle.
Pour résoudre ce problème, nous utilisons un RAG agentique soutenu par une CLI de recherche :
- Au repos, l'agent ne voit que la description de la compétence (~205 jetons). La description suit les consignes de déclenchement des compétences d'Anthropic afin que l'agent appelle la compétence pour les tâches d'interface pertinentes.
- Pour les tâches d'interface, l'agent peut utiliser la CLI pour effectuer une recherche :
modern-web-guidance search "animate height auto", ce qui lui permet d'obtenir 10 résultats pertinents (~530 jetons). - L'agent exécute
modern-web-guidance retrieve animate-to-intrinsic-sizespour extraire l'intégralité du guide (environ 800 jetons). Il est désormais équipé des bonnes pratiques d'implémentation pour la compatibilité, les solutions de remplacement et la technique.
Pourquoi une compétence CLI plutôt qu'un serveur MCP ou une recherche sur le Web ?
- Les outils MCP gaspillent des jetons ou ont des mécanismes de déclenchement peu fiables (en raison de la découverte dynamique des outils). La description de notre compétence est optimisée pour l'efficacité et permet à l'agent de ne consommer des conseils que lorsque cela est approprié.
- La recherche sur le Web intégrée affiche des réponses Stack Overflow et des documents de référence datant de 2015, plutôt que des modèles d'implémentation
DO/DO NOTà jour et sélectionnés. De plus, l'exécution prend quelques secondes sur le réseau et échoue dans les bacs à sable hors connexion, tandis que la CLI locale s'exécute sur le processeur en quelques millisecondes.
Génération 1 : le prototype C++ de 507 Mo
La première version de Modern Web Guidance utilisait une pile RAG locale : LanceDB, Apache Arrow et Transformers.js avec onnxruntime-native.
Cela fonctionnait bien sur un ordinateur de développement, mais l'adaptation à une compétence d'agent était difficile :
- Lorsque vous ajoutez une compétence à un projet (ou qu'un agent l'appelle avec
npx), vous ne vous attendez pas à devoir attendre qu'unnpm installtélécharge des binaires.nodedépendant de l'architecture ou qu'une compilation C++node-gypéchoue régulièrement dans les bacs à sable cloud. - Le répertoire
node_modulesextrait pesait 507 Mo.
Gen 2 : réduire TensorFlow.js à 23 Mo
Nous voulions une compilation zéro native et une exécution instantanée partout où Node s'exécute. En avril, nous avons donc remplacé la pile native par un moteur de processeur purement JavaScript exécutant all-MiniLM-L6-v2 sur @tensorflow/tfjs :
- Nous avons supprimé
onnxruntime-nodedans esbuild et remplacé le tokeniseur Hugging Face par un petit tokeniseur BERT WordPiece intégré (0 incohérence d'ID de jeton). - Après avoir exploré les mappages sources, nous avons réduit les plus de 400 modules de
@tensorflow/tfjs-backend-cpuaux 26 noyaux que MiniLM utilise réellement, ce qui a permis de réduire la taille du moteur JS de 6 Mo à 830 Ko. - LanceDB a été abandonné au profit de vecteurs compressés au format gzip au moment de la compilation et d'une analyse de produit scalaire
<1 msen mémoire sur l'ensemble des quelque 200 guides. - Placez l'outil d'intégration derrière un appel
import()afin queretrieveetlistse terminent en moins de dix millisecondes.
Le package npm a ainsi été réduit à 23 Mo, sans dépendances d'exécution. Nous l'avons déployé, et les agents ont effectué environ 750 000 recherches.
Où MiniLM a échoué en production
Après quelques mois, nous avons examiné les trajectoires où les agents avaient installé la compétence, mais écrivaient toujours du code hérité.
Lors d'une exécution Codex, un développeur a demandé une invite de confirmation de suppression. Nous avons un guide complet sur la création de fenêtres modales de confirmation accessibles avec l'élément HTML <dialog closedby="any">.
L'agent a fait ce qu'il fallait et a recherché :
npx modern-web-guidance@latest search "confirm destructive action"
La CLI a renvoyé []. L'agent a donc haussé les épaules et a écrit window.confirm().
Pourquoi n'a-t-elle renvoyé aucun résultat ? En examinant les journaux et les embeddings, nous avons identifié deux lacunes de récupération :
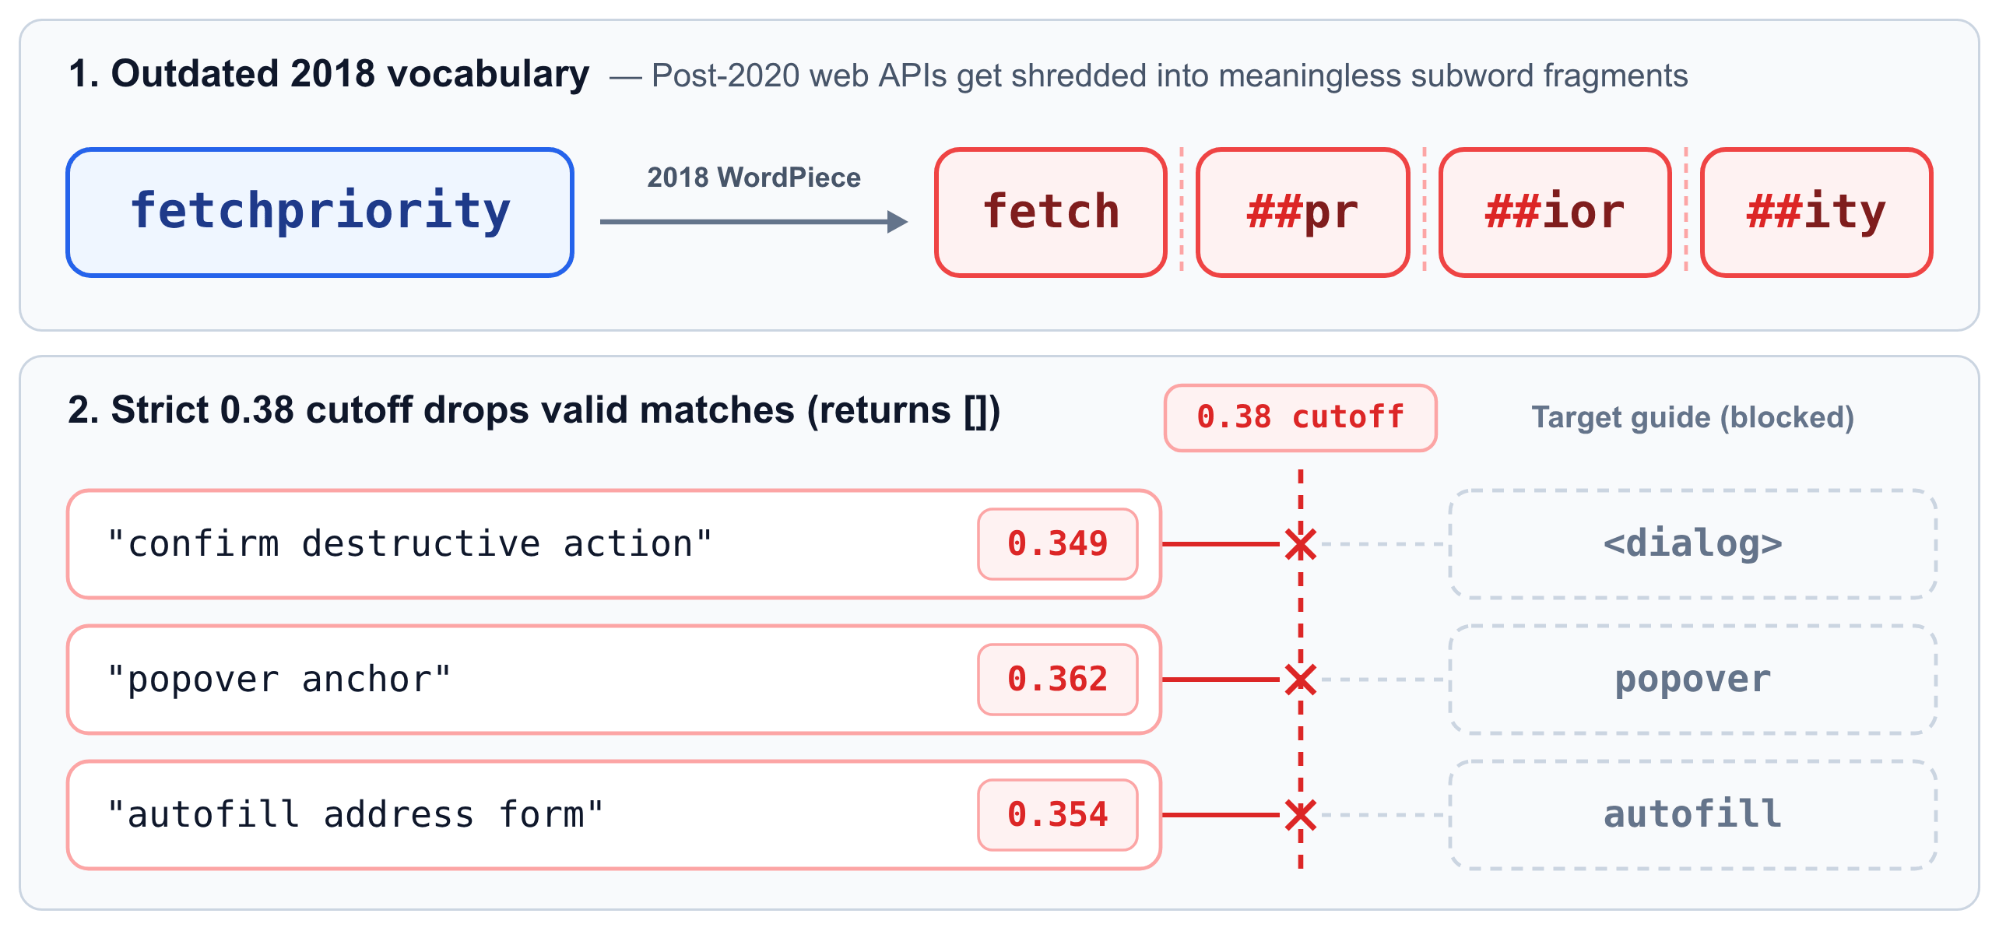
all-MiniLM-L6-v2a été entraîné entre 2018 et 2020. Son vocabulaire WordPiece ne sait donc littéralement pas que les API Web postérieures à 2020 existent. Lorsqu'un agent recherchefetchpriority,popoveroustartViewTransition, le tokeniseur de 2018 décomposefetchpriorityen quatre sous-mots sans signification :fetch·##pr·##ior·##ity.- Pour éviter que des requêtes hors champ ne renvoient des guides aléatoires, une précédente demande d'extraction avait ajouté un seuil de similarité cosinus strict de
0.38. Comme MiniLM n'a pas pu relier l'expression de trois mots"confirm destructive action"à"dialog"au-dessus de0.38(score de0.349, tandis que"popover anchor"a obtenu0.362et"autofill address form"a obtenu0.354), la porte a rejeté les correspondances valides. Pire encore, chaque fois quesearchrenvoyait[], les instructions de notre compétence indiquaient à l'agent de se rabattre surmodern-web-guidance list, ce qui ajoutait les quelque 200 descriptions de guides (environ 1 500 jetons gaspillés) au contexte.
Corriger la récupération : télémétrie réelle, recherche hybride et renvoi de 10 résultats
Notre benchmark d'origine était de 850 requêtes synthétiques générées à partir des guides eux-mêmes, qui correspondaient trop étroitement à la formulation du guide pour détecter ces échecs. Nous avons donc créé un nouveau système d'évaluation (pnpm benchmark:rag) basé sur 4 000 Live Search échantillonnées à partir de la télémétrie de la CLI (qui n'enregistre que l'argument search de deux à cinq mots de l'agent, jamais les prompts des utilisateurs ni le code du dépôt, et respecte DISABLE_TELEMETRY=1) et 1 029 recherches extraites des évaluations nocturnes de l'agent dans Claude Code, Codex CLI et Gemini CLI.
En rejouant notre historique Git sur ces requêtes retenues, nous avons constaté que la limite de 0.38 avait multiplié par huit les réponses [] vides. Une fois le benchmark en place, nous avons apporté deux améliorations rapides avant de toucher au modèle d'embedding :
- Recherche hybride par mot clé et recherche sémantique : les vecteurs denses masquent les noms d'API exacts (
:user-invalid,showModal,details-name), tandis que la recherche par mot clé ne détecte pas les requêtes d'intention lorsque l'agent ne connaît pas le nom de l'API. Nous avons ajouté un index de mots clés BM25 (si vous savez, vous savez) sans dépendance avec racinisation des pluriels, indexé leweb-feature-idsde chaque guide et fusionné BM25 avec le classement sémantique. Désormais,searchne renvoie[]que lorsque la similarité sémantique est de<0.30et que BM25 n'a aucun résultat de mot clé. - 10 résultats compacts au lieu de 5 résultats détaillés : les instructions de la compétence indiquaient déjà aux agents d'ignorer
similarityettokenCount. En supprimant ces champs inutilisés, nous pouvons faire tenir 10 résultats{id, description}compacts dans le même budget d'environ 530 jetons que 5 résultats détaillés :
// Before: 5 verbose results (~105 tokens each = ~525 tokens)
{
  "id": "dialog",
  "category": "html",
  "description": "Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby.",
  "featuresUsed": ["dialog", "dialog-closedby"],
  "tokenCount": 780,
  "similarity": 0.49
}
// After: 10 compact results (~53 tokens each = ~530 tokens)
{"id":"dialog","description":"Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby."}
Ensemble, ces deux modifications ont permis d'augmenter notre taux de réussite de recherche sur les requêtes de télémétrie retenues de 80,6 % à 94,7 %, mesuré en tant que Hit@K (si le guide attendu apparaît dans les K premiers résultats).
Génération 3 : embeddings pré-entraînés et boucle for de sept lignes
Même avec un taux de réussite de 94.7%, notre télémétrie a révélé un écart flagrant : 86,7 % des recherches d'agents en direct ne comportaient que deux à cinq mots (médiane : trois mots). Chaque fois qu'un agent recherchait une expression de trois mots, Node démarrait TensorFlow.js, analysait un réseau de neurones de 22, 6 Mo et consommait 770 ms de latence de démarrage à froid et 346 Mo de RAM de pointe.
Lorsqu'on lui a demandé s'il existait un moyen plus léger d'intégrer des requêtes de trois mots sans réseau de neurones, notre agent Antigravity est revenu avec une pile de techniques de distillation de ML peu connues : Model2Vec, Tokenlearn, dimensions Matryoshka, Adagrad. (Pour en savoir plus, consultez notre page sur la qualité de la recherche.)
Le RAG local standard force les documents et les requêtes à passer par le même petit modèle sur le processeur de l'utilisateur. Mais nos quelque 200 guides ne changent pas après la publication d'une version npm. Il n'y a donc aucune raison de les intégrer à un petit modèle de 2018. À la place, embed-guide-chunks.ts pré-génère tous nos vecteurs de guide au moment de la publication dans le cloud à l'aide de gemini-embedding-001 et les envoie sous forme de vecteurs Int8 binaires à 256 dimensions (guide-chunks.i8, 335 KB compressés avec gzip).
Comment un projet CLI hors connexion, sans clé API, projette-t-il la requête en direct d'un utilisateur dans ce même espace vectoriel Gemini ? Comme les requêtes des agents comportent presque toujours deux à cinq mots, nous n'avons pas besoin de transformateur au moment de l'exécution. Il nous suffit d'un tableau de conversion de vecteurs pour les mots connus (table) et d'un moyen intelligent de les additionner. Au moment de l'exécution, l'intégralité du pipeline TensorFlow.js de 23 Mo se réduit à une boucle for de sept lignes dans static-embedder.ts :
// Each word's weight and Int8 scale are pre-folded into `scales[i]`
for (const [i, f] of enc) {
  const wt = scales[i] * f;
  const offset = i * 256;
  for (let k = 0; k < 256; k++) {
    out[k] += wt * table[offset + k];
  }
}
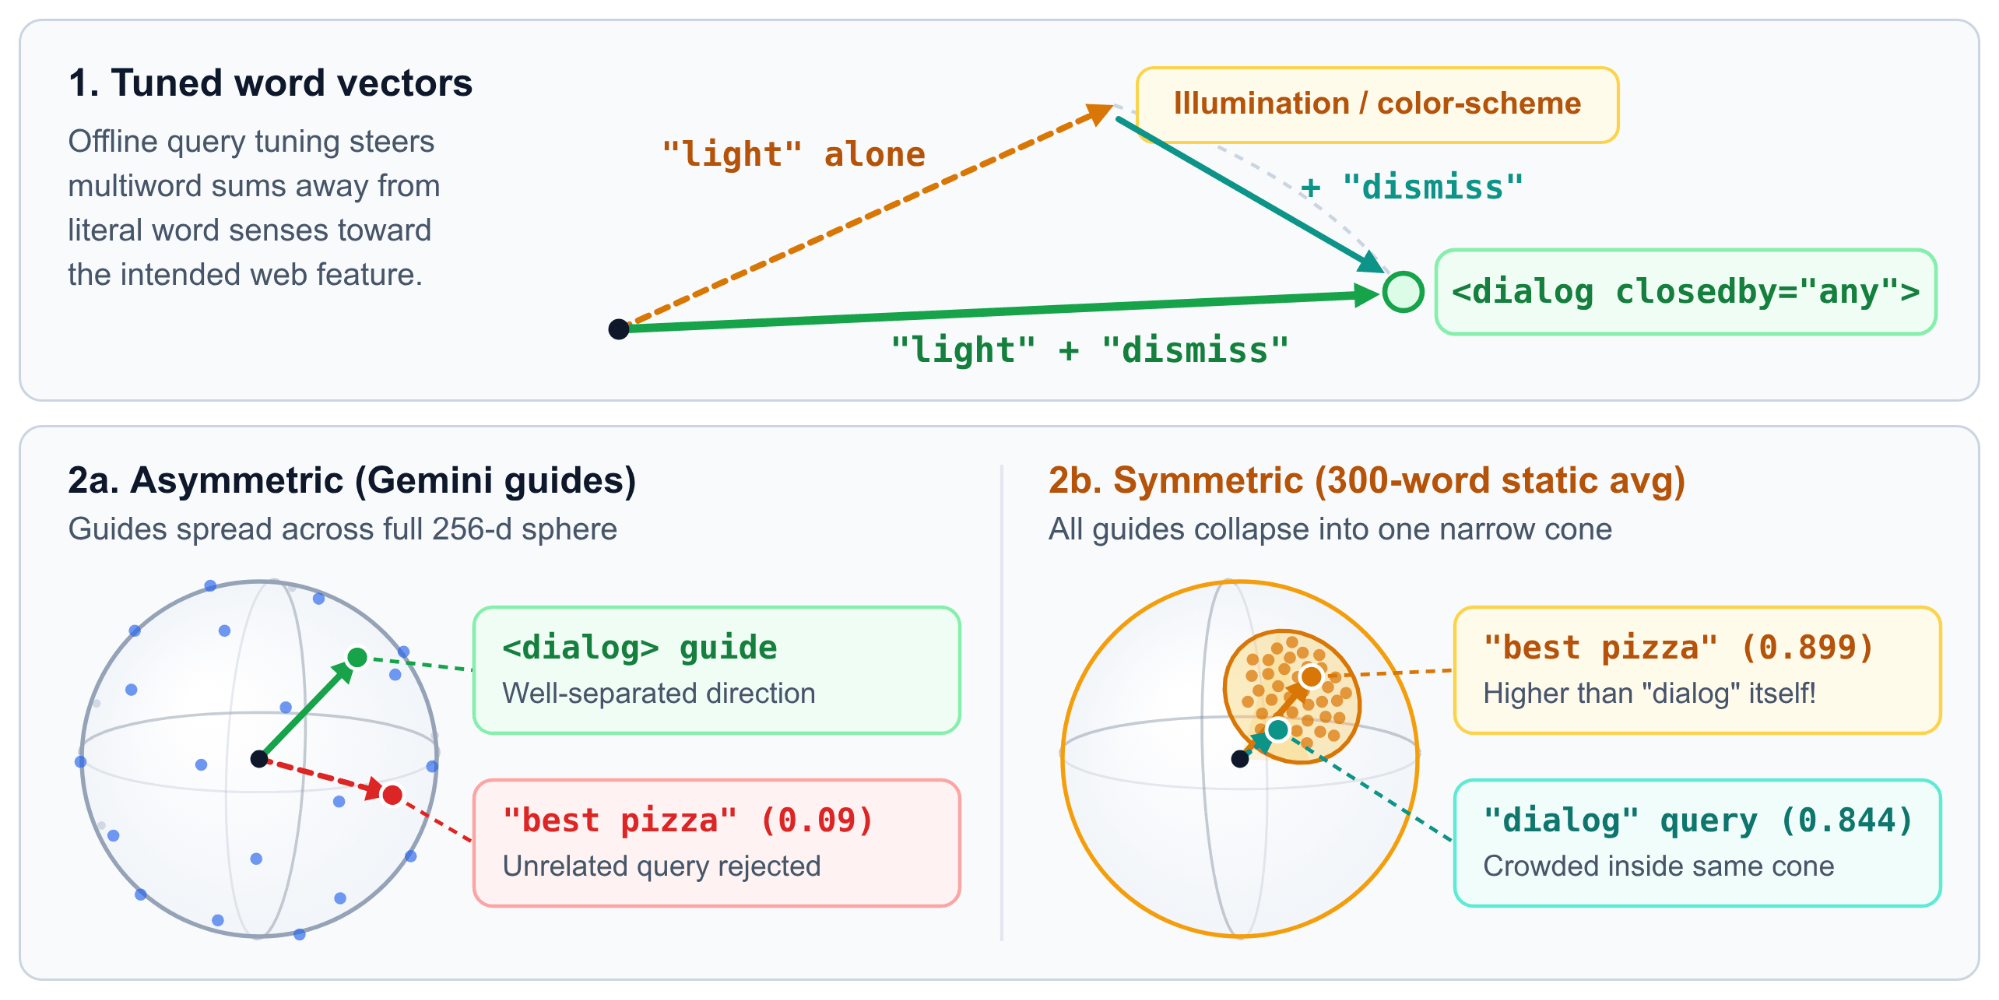
Pour créer ce tableau de conversion (train-query-words.ts), nous avons pris un vocabulaire de 29 165 mots (où les termes Web modernes tels que fetchpriority, light-dismiss, popover et scrollytelling sont des mots entiers autonomes), nous les avons intégrés à gemini-embedding-001 et nous avons ajusté les vecteurs de mots hors connexion par rapport à 33 000 requêtes Web réelles afin que les combinaisons de plusieurs mots se retrouvent au bon endroit (par exemple, "light" + "dismiss" pointe vers <dialog closedby="any">, et non vers l'éclairage ou les jeux de couleurs). Compressé à Int8 (query-words.i8), l'ensemble du tableau de conversion est compressé au format Gzip (5.3 MB).
Pourquoi ne pas utiliser ce tableau de conversion statique pour intégrer également les guides et ignorer l'étape de compilation cloud ? Nous avons d'abord essayé cette approche, mais elle n'a pas fonctionné pour des paragraphes entiers : la somme de trois mots de requête reste précise, mais la moyenne de centaines de mots sur un guide complet réduit chaque guide à un cône étroit proche de la moyenne générique en anglais (au point que "best pizza in new york" a obtenu un score de similarité cosinus de 0.899 par rapport à notre guide dialog, ce qui est supérieur à la requête "dialog" elle-même à 0.844 !). L'association de recherches de requêtes statiques de trois mots (query-words.i8) aux embeddings de guide Gemini du modèle complet (guide-chunks.i8) nous offre une précision de niveau cloud, tandis que les requêtes s'exécutent toujours hors connexion en 30 µs.
Le tableau des scores pour les trois générations
Au fil de nos versions, Hit@K est passé de 78,2 % avec des embeddings de documents entiers à 95,4 % avec l'embedder statique Int8 (contre 96,9 % avec l'API cloud gemini-embedding-001) :
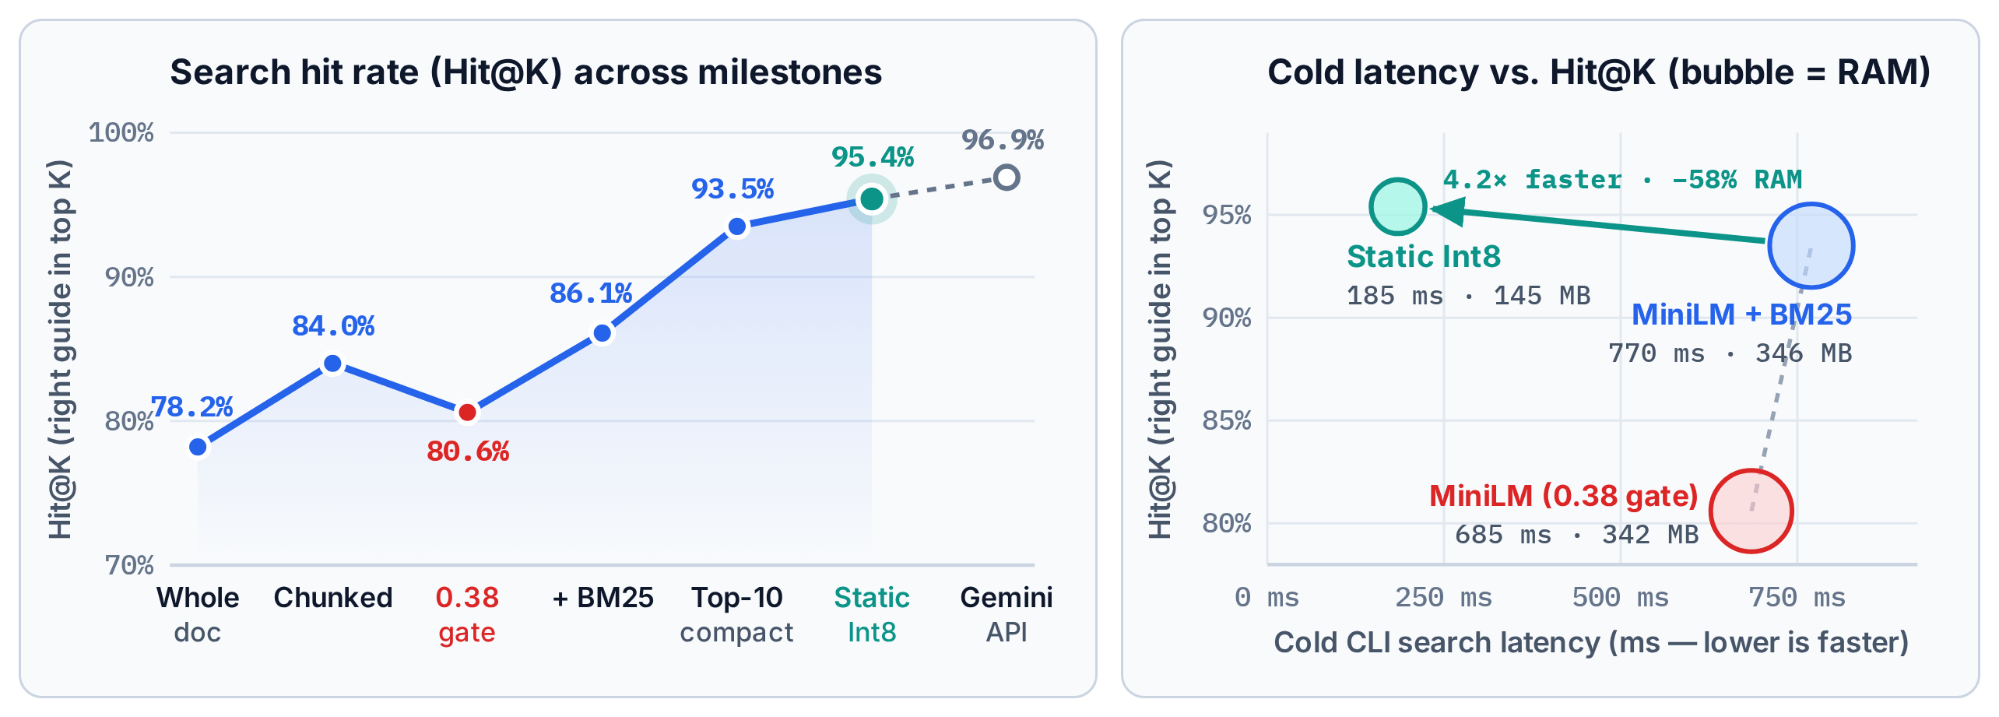
Voici comment les trois générations se comparent après l'intégration de l'outil d'intégration statique :
Et si vous exécutez la requête Codex incorrecte de tout à l'heure :
npx modern-web-guidance@latest search "confirm destructive action"
Le guide dialog revient en haut de la liste.
(Vous pouvez explorer les graphiques interactifs pour tous les jalons, longueurs de requête et horizons K sur notre tableau de bord de la qualité de la recherche.)
Le code est bon marché, mais la mesure est un travail à part entière
Un agent peut écrire un script de classement BM25 ou de distillation de vecteurs de mots en quelques minutes. La génération d'implémentations candidates n'est plus le goulot d'étranglement. Savoir si un changement a réellement aidé (ou s'il a discrètement cassé 9 % des recherches en production, comme l'a fait notre porte 0.38) représente la quasi-totalité du travail.
Voici comment nous avons conçu ce système :
- Définissez l'objectif principal et investissez dans le système de mesure plutôt que dans une implémentation unique. Nous avons passé beaucoup plus de temps à créer
pnpm benchmark:rag, à sélectionner 5 000 requêtes réelles et à calibrer notre notation automatisée par rapport aux évaluations humaines qu'à écrire un récupérateur. - Créez une grille d'évaluation pour vous et vos agents, et attendez-vous à ce qu'elle évolue une fois qu'elle sera confrontée à des données réelles. On appelle cela "measurement-first", ce qui n'est qu'à moitié vrai : vous pouvez écrire des vérifications de base avec des réponses connues dès le premier jour, mais vous ne pouvez pas concevoir une bonne grille d'évaluation dans le vide avant d'inspecter les échecs réels (Shankar et al. appellent cela la dérive des critères dans Who Validates the Validators?). Le fait de voir des agents déclencher des solutions de remplacement
listde 1 500 jetons nous a obligés à pénaliser l'excès de jetons en plus du rappel. - Une fois que vous disposez de mesures fiables, testez de manière intensive différentes implémentations et laissez le tableau de bord trancher les débats sur l'architecture. Une fois qu'un benchmark évalue 5 000 requêtes en quelques secondes, vous n'avez plus besoin de débattre dans les demandes d'extraction pour savoir si une boucle
Int8de sept lignes peut battre un transformateur de 23 Mo. Essayez cinq approches en un après-midi et gardez la meilleure.
Bien entendu, l'ensemble du code (y compris l'embedder, le distillateur et le benchmark harness) est open source.