


פורסם: 12 בנובמבר 2026
השבוע השקנו את Modern Web Guidance 1.0, מיומנות בקוד פתוח שעוזרת לסוכני תכנות להשתמש בתכונות מודרניות של פלטפורמות אינטרנט במקום בפתרונות עקיפים מדור קודם. בפוסט הזה נסביר על מנוע החיפוש המקומי שמוצא את המדריך הכי רלוונטי למשימה שלכם, בלי לבזבז טוקנים.
אם תגידו למהנדס שבניתם מאגר ידע עם 1.7MB של טקסט ב-Markdown בשביל סוכן התכנות שלו, הוא ישאל שתי שאלות:
- "כמה טוקנים זה יוסיף לחלון ההקשר שלי?"
- "איזה סוג של מסד נתונים וקטורי מנופח נדרש?"
בחצי השנה האחרונה בנינו מחדש את מנוע השליפה המקומי שלנו שלוש פעמים. התחלנו עם 507MB של קישורי C++, ירדנו ל-23MB של JavaScript טהור באמצעות TensorFlow.js, ואז ירדנו לחבילה של 7MB שבה הטמעת השאילתה היא לולאת for של 7 שורות, וכל זה תוך שיפור הדיוק.
RAG אג'נטית וחשיפה הדרגתית
לא מעשי להעביר טקסט Markdown בנפח 1.7MB שמכיל יותר מ-200 מדריכים ל-HTML, ל-CSS ול-Web API אל AGENTS.md. אנחנו מאמינים בחשיפה הדרגתית, אבל יודעים שאינדקס Markdown יפסיק להיות יעיל מבחינת טוקנים בקנה מידה גדול.
כדי לפתור את הבעיה, אנחנו משתמשים ב-RAG אג'נטית שמגובה ב-CLI של חיפוש:
- במצב מנוחה, הסוכן רואה רק את תיאור הסקיל (כ-205 טוקנים). התיאור תואם להנחיות של Anthropic להפעלת מיומנויות, כדי שהסוכן יפעיל את המיומנות במשימות רלוונטיות של ממשק המשתמש.
- במשימות שקשורות לפרונטאנד, הנציג יכול להשתמש ב-CLI כדי לחפש:
modern-web-guidance search "animate height auto", ולקבל 10 התאמות רלוונטיות (כ-530 טוקנים). - הנציג מפעיל את
modern-web-guidance retrieve animate-to-intrinsic-sizesכדי לשלוף את כל המדריך (כ-800 טוקנים). הוא כולל עכשיו את השיטות המומלצות להטמעה בנוגע לתאימות, לגיבויים ולטכניקה.
למה להשתמש במיומנות CLI במקום בשרת MCP או בחיפוש באינטרנט?
- כלי MCP מבזבזים טוקנים או שיש להם מנגנוני טריגר לא אמינים (בגלל זיהוי כלים דינמי). תיאור המיומנות שלנו מותאם ליעילות מקסימלית ומאפשר לסוכן להשתמש בהנחיות רק כשהן רלוונטיות.
- החיפוש המובנה באינטרנט מציג תשובות מ-Stack Overflow ומסמכי עזר משנת 2015, במקום דפוסי הטמעה עדכניים ומותאמים אישית של
DOאוDO NOT. בנוסף, הפעולה נמשכת כמה שניות ברשת ונכשלת בארגזי חול אופליין, בעוד שה-CLI המקומי פועל על המעבד (CPU) תוך אלפיות השנייה.
דור ראשון: אב טיפוס ב-C++ בנפח 507MB
הגרסה הראשונה של Modern Web Guidance השתמשה במחסנית RAG מקומית: LanceDB, Apache Arrow ו-Transformers.js עם onnxruntime-native.
הוא פעל כמו שצריך במחשב פיתוח, אבל לא התאים למיומנות של סוכן:
- כשמוסיפים מיומנות לפרויקט (או כשסוכן מפעיל אותה באמצעות
npx), לא מצפים להמתין להורדה של קובצי.nodeבינאריים שלnpm installשתלויים בארכיטקטורה או לקומפילציה שלnode-gypC++ שנכשלת באופן קבוע בארגזי חול בענן. - הספרייה
node_modulesשחולצה שקלה 507MB.
דור 2: צמצום TensorFlow.js ל-23MB
רצינו אפס קומפילציה מקומית והפעלה מיידית בכל מקום שבו Node פועל. לכן באפריל החלפנו את המחסנית המקורית במנוע CPU של JavaScript טהור שמריץ את all-MiniLM-L6-v2 ב-@tensorflow/tfjs:
- הוצאנו את
onnxruntime-nodeב-esbuild והחלפנו את ה-tokenizer של Hugging Face ב-tokenizer קטן של BERT WordPiece בתוך העץ (0 אי-התאמות של מזהי טוקנים). - אחרי שבדקנו כמה מפות מקור, צמצמנו את יותר מ-400 המודולים של
@tensorflow/tfjs-backend-cpuל-26 הליבות שבהן MiniLM משתמש בפועל, והקטנו את מנוע ה-JS מ-6MB ל-830KB. - הפסקנו להשתמש ב-LanceDB לטובת וקטורים דחוסים ב-gzip בזמן ה-build וסריקה בזיכרון של מכפלה סקלרית של
<1 msבכל 200 המדריכים בערך. - מציבים את המטמיע מאחורי קריאה ל-
import()כדי ש-retrieveו-listיסתיימו תוך פחות מ-10 אלפיות השנייה.
כך חבילת ה-npm הצטמצמה ל-23MB ללא יחסי תלות בזמן ריצה. השקנו את המערכת, והסוכנים ביצעו כ-750,000 חיפושים.
איפה MiniLM נשבר בסביבת הייצור
אחרי כמה חודשים, בדקנו את המסלולים שבהם הסוכנים התקינו את המיומנות אבל עדיין כתבו קוד מדור קודם.
בהרצה אחת של Codex, מפתח ביקש הנחיה לאישור מחיקה. יש לנו מדריך שלם על יצירת מודלים נגישים של אישור באמצעות HTML <dialog closedby="any">.
הנציג פעל נכון וחיפש:
npx modern-web-guidance@latest search "confirm destructive action"
ה-CLI החזיר את הערך []. אז הנציג משך בכתפיים וכתב window.confirm().
למה לא קיבלתי תוצאות? כשבדקנו את היומנים וההטמעות, זיהינו שני פערים באחזור:
-
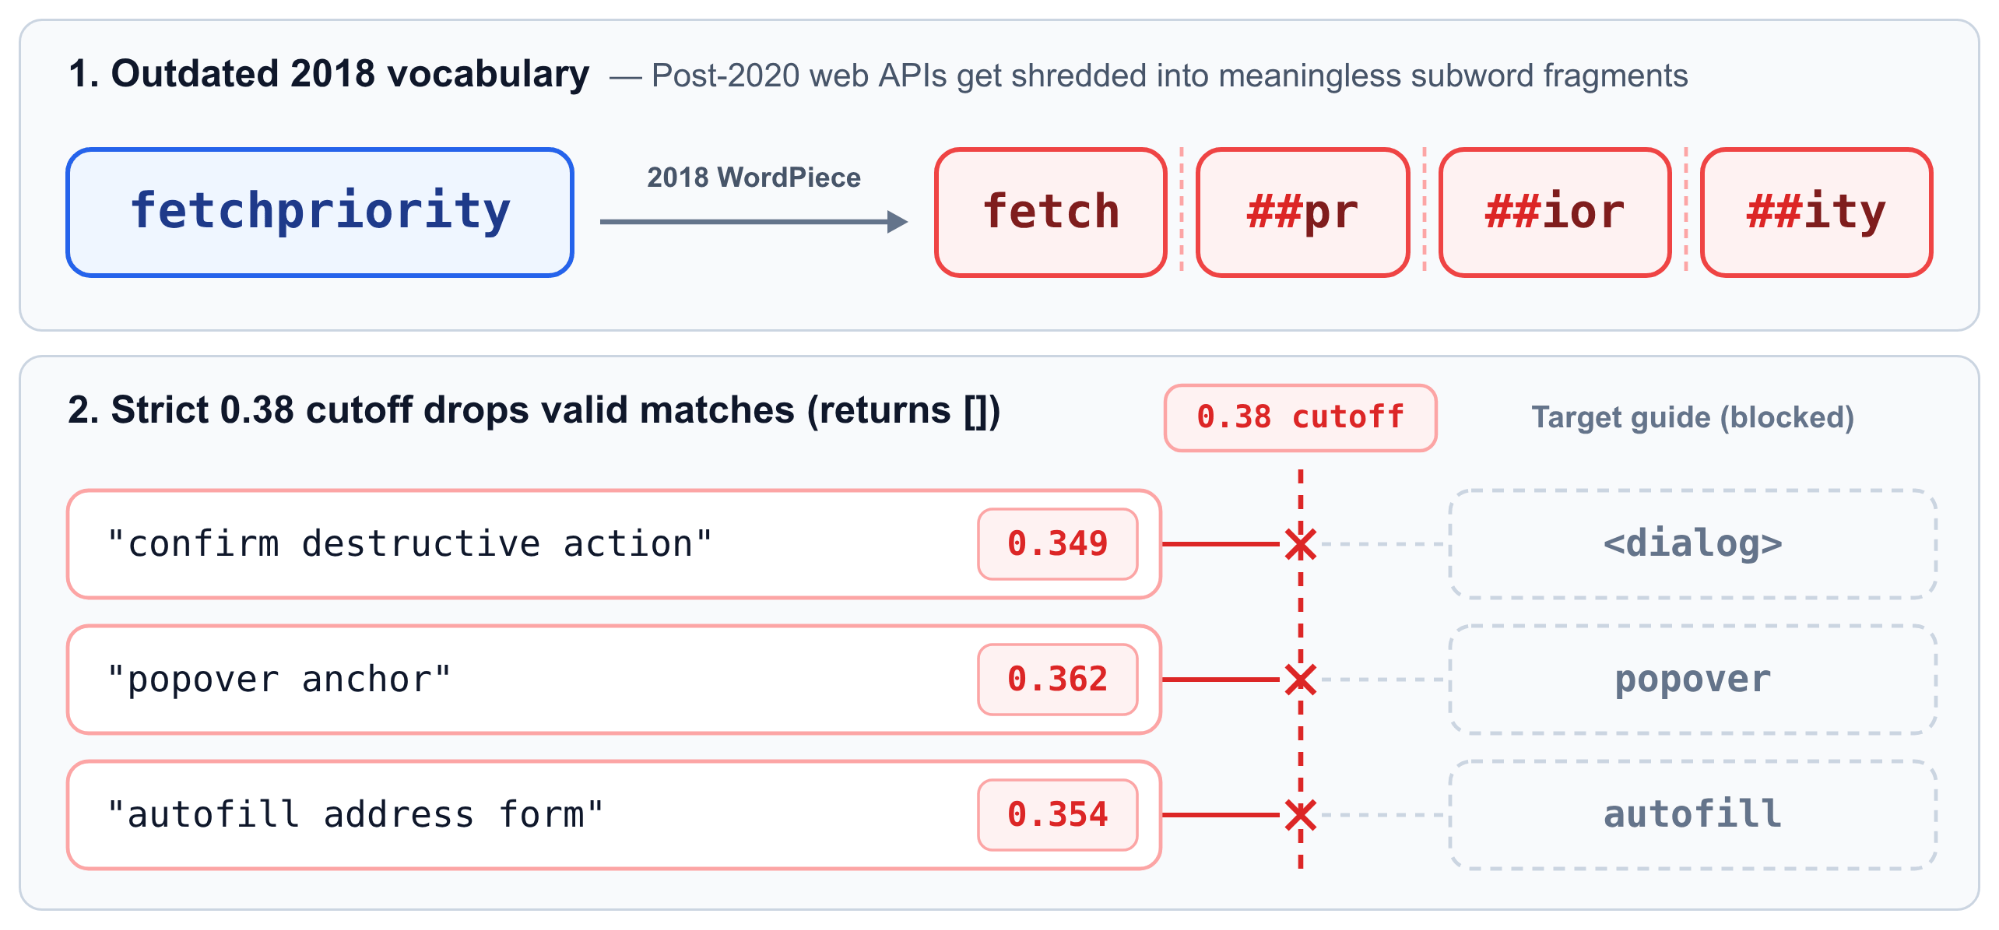
all-MiniLM-L6-v2אומן בסביבות 2018-2020, כך שאוצר המילים שלו ב-WordPiece ממש לא יודע על קיומם של ממשקי API לאינטרנט אחרי 2020. כשסוכן מחפש אתfetchpriority,popoverאוstartViewTransition, כלי הניתוח המילולי משנת 2018 מפרק אתfetchpriorityלארבע מילים משניות חסרות משמעות:fetch·##pr·##ior·##ity. - כדי למנוע משאילתות מחוץ להיקף להחזיר מדריכים אקראיים, בקשת Pull קודמת הוסיפה סף דמיון קוסינוס מחמיר של
0.38. מכיוון ש-MiniLM לא הצליח לגשר על הביטוי בן 3 המילים"confirm destructive action"ל-"dialog"מעל0.38(ציון0.349, בעוד ש-"popover anchor"קיבל0.362ו-"autofill address form"קיבל0.354), השער זרק התאמות חוקיות. גרוע מכך, בכל פעם ש-searchהחזיר את[], ההוראות של המיומנות שלנו אמרו לסוכן לחזור ל-modern-web-guidance list, ולהכניס את כל כ-200 התיאורים של המדריכים (כ-1,500 טוקנים מבוזבזים) להקשר.
תיקון האחזור: טלמטריה אמיתית, חיפוש היברידי והחזרת 10 תוצאות
נקודת ההשוואה המקורית שלנו הייתה 850 שאילתות סינתטיות שנוצרו מהמדריכים עצמם, והן תאמו את הניסוח של המדריך באופן מדויק מדי מכדי לזהות את הכשלים האלה. לכן בנינו מערכת הערכה חדשה (pnpm benchmark:rag) סביב 4,000 חיפושי טקסט בסביבה שנדגמו מנתוני טלמטריה של CLI שמשתמשים לא ביטלו את ההסכמה לשיתוף שלהם (שמתעדים רק את הארגומנט search של הסוכן באורך 2-5 מילים, אף פעם לא הנחיות של משתמשים או קוד מאגר, ומכבדים את DISABLE_TELEMETRY=1) וגם 1,029 חיפושים שנאספו מהערכות ליליות של סוכנים ב-Claude Code, ב-Codex CLI וב-Gemini CLI.
הפעלנו מחדש את היסטוריית ה-git שלנו מול השאילתות שהוחרגו, וגילינו שסף ה-0.38 גרם לעלייה חדה של פי 8 בתגובות הריקות של []. אחרי שהגדרנו את נקודת ההשוואה, ביצענו שני שיפורים מהירים לפני שנגענו במודל ההטמעה:
- חיפוש משולב של מילות מפתח וחיפוש סמנטי: וקטורים דחוסים מטשטשים שמות מדויקים של ממשקי API (
:user-invalid,showModal,details-name), וחיפוש של מילות מפתח מפספס שאילתות של כוונה כשהסוכן לא יודע את שם ה-API. הוספנו אינדקס מילות מפתח BM25 (מי שיודע, יודע) ללא תלות, עם גזירת צורות רבים, הוספנו לאינדקס את ה-web-feature-idsשל כל מדריך, ושילבנו את BM25 עם דירוג סמנטי. עכשיוsearchמחזיר את[]רק כשהדמיון הסמנטי הוא<0.30וגם ל-BM25 יש אפס התאמות של מילות מפתח. - 10 תוצאות קצרות במקום 5 תוצאות ארוכות: בהוראות של המיומנות כבר נאמר לסוכנים להתעלם מ-
similarityומ-tokenCount. הסרנו את השדות הלא נחוצים, וכך הצלחנו להכניס 10 תוצאות קומפקטיות של{id, description}לאותו תקציב של כ-530 אסימונים כמו 5 תוצאות מפורטות:
// Before: 5 verbose results (~105 tokens each = ~525 tokens)
{
  "id": "dialog",
  "category": "html",
  "description": "Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby.",
  "featuresUsed": ["dialog", "dialog-closedby"],
  "tokenCount": 780,
  "similarity": 0.49
}
// After: 10 compact results (~53 tokens each = ~530 tokens)
{"id":"dialog","description":"Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby."}
שני השינויים האלה יחד העלו את שיעור ההצלחה בחיפוש בשאילתות טלמטריה מ-80.6% ל-94.7%, כפי שנמדד על ידי Hit@K (אם המדריך הצפוי מופיע ב-K התוצאות הראשונות).
דור 3: הטמעות מוכנות מראש ולולאת for בת 7 שורות
אפילו בשיעור תוצאות של 94.7%, הטלמטריה שלנו הראתה אי התאמה בולטת: 86.7% מחיפושי הסוכנים החיים היו באורך של 2 עד 5 מילים בלבד (חציון: 3 מילים). בכל פעם שנציג חיפש ביטוי בן 3 מילים, Node הפעיל את TensorFlow.js, ניתח רשת נוירונים בנפח 22.6MB וצרך 770 אלפיות השנייה של זמן אחזור בהפעלה קרה ו-346MB של זיכרון RAM בשיא.
כששאלנו אם יש דרך קלה יותר להטמיע שאילתות של 3 מילים בלי רשת נוירונים, סוכן Antigravity שלנו חזר עם ערימה של טכניקות זיקוק לא מוכרות של למידת מכונה: Model2Vec, Tokenlearn, Matryoshka dimensions, Adagrad. (אם אתם רוצים לקרוא את הפרטים הטכניים, יש מידע נוסף בדף איכות החיפוש שלנו).
ב-RAG מקומי רגיל, גם המסמכים וגם השאילתות עוברים דרך אותו מודל קטן ב-CPU של המשתמש. אבל כ-200 המדריכים שלנו לא משתנים אחרי שאנחנו מפיצים גרסת npm, אז אין סיבה להטמיע אותם עם מודל קטן מ-2018. במקום זאת, embed-guide-chunks.ts מכין מראש את כל וקטורי ההנחיה שלנו בזמן ההשקה בענן באמצעות gemini-embedding-001 ושולח אותם כווקטורים בינאריים של Int8 ב-256 ממדים (guide-chunks.i8, 335 KB ב-gzipped).
איך ממשק שורת פקודה (CLI) אופליין, ללא מפתח API, מקרין שאילתה בזמן אמת של משתמש לאותו מרחב וקטורי של Gemini? השאילתות של הסוכנים הן כמעט תמיד באורך של 2 עד 5 מילים, ולכן אנחנו לא צריכים טרנספורמר בזמן הריצה. אנחנו צריכים רק טבלת חיפוש של וקטורים למילים מוכרות (table) ודרך חכמה לסכם אותם. בזמן הריצה, כל צינור עיבוד הנתונים של TensorFlow.js בגודל 23MB מצטמצם ללולאת for בת 7 שורות ב-static-embedder.ts:
// Each word's weight and Int8 scale are pre-folded into `scales[i]`
for (const [i, f] of enc) {
  const wt = scales[i] * f;
  const offset = i * 256;
  for (let k = 0; k < 256; k++) {
    out[k] += wt * table[offset + k];
  }
}
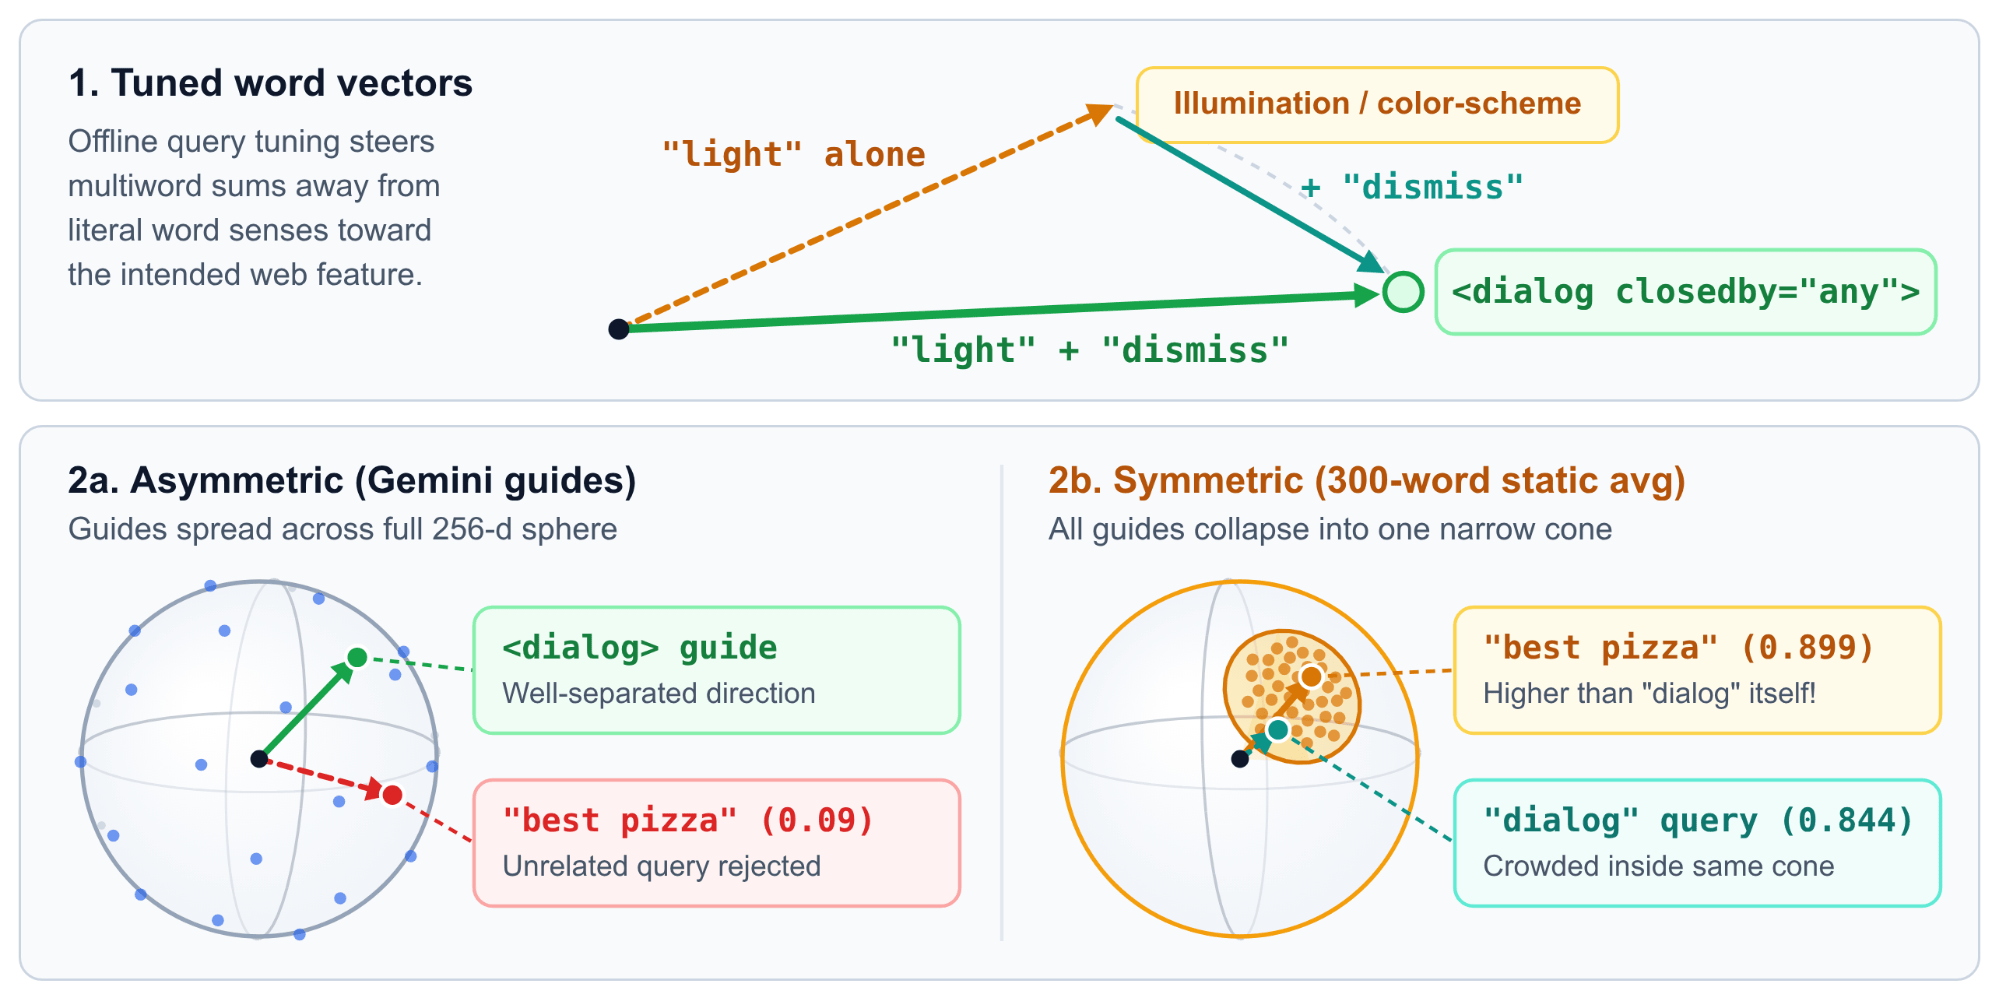
כדי ליצור את טבלת החיפוש הזו (train-query-words.ts), לקחנו אוצר מילים של 29,165 מילים (שבו מונחי אינטרנט מודרניים כמו fetchpriority, light-dismiss, popover ו-scrollytelling הם מילים שלמות בפני עצמן), הטמענו אותם באמצעות gemini-embedding-001, ושינינו את וקטורי המילים אופליין בהתאם ל-33,000 שאילתות אינטרנט אמיתיות,כדי ששילובים של כמה מילים יגיעו למקום הנכון (לדוגמה, "light" + "dismiss" מצביעים על <dialog closedby="any">, ולא על תאורה או ערכות צבעים). הטבלה נדחסת ל-Int8 (query-words.i8), וכל טבלת החיפוש נדחסת ב-gzip ל-5.3 MB.
למה לא להשתמש בטבלת החיפוש הסטטית הזו כדי להטמיע גם את המדריכים, ולדלג על שלב ה-Cloud Build? ניסינו את זה קודם, וזה לא עבד בפסקאות מלאות: סיכום של 3 מילות שאילתה נשאר מדויק, אבל ממוצע של מאות מילים במדריך מלא מצמצם כל מדריך לחרוט צר ליד הממוצע הגנרי באנגלית (עד לנקודה שבה "best pizza in new york" קיבל ציון של 0.899 בדמיון קוסינוס לעומת המדריך שלנו בנושא dialog, גבוה יותר מהשאילתה "dialog" עצמה ב-0.844!). שילוב של חיפושי שאילתות סטטיות של 3 מילים (query-words.i8) עם הטמעות של מדריכי Gemini במודל מלא (guide-chunks.i8) נותן לנו דיוק ברמת הענן, בזמן שהשאילתות עדיין פועלות אופליין תוך 30 מיקרו-שניות.
לוח התוצאות של שלושת הדורות
בכל אבני הדרך של הגרסאות שלנו, Hit@K עלה מ-78.2% עם הטמעות של מסמכים שלמים ל-95.4% עם כלי ההטמעה הסטטי של Int8 (בהשוואה ל-96.9% עם Cloud API של gemini-embedding-001):
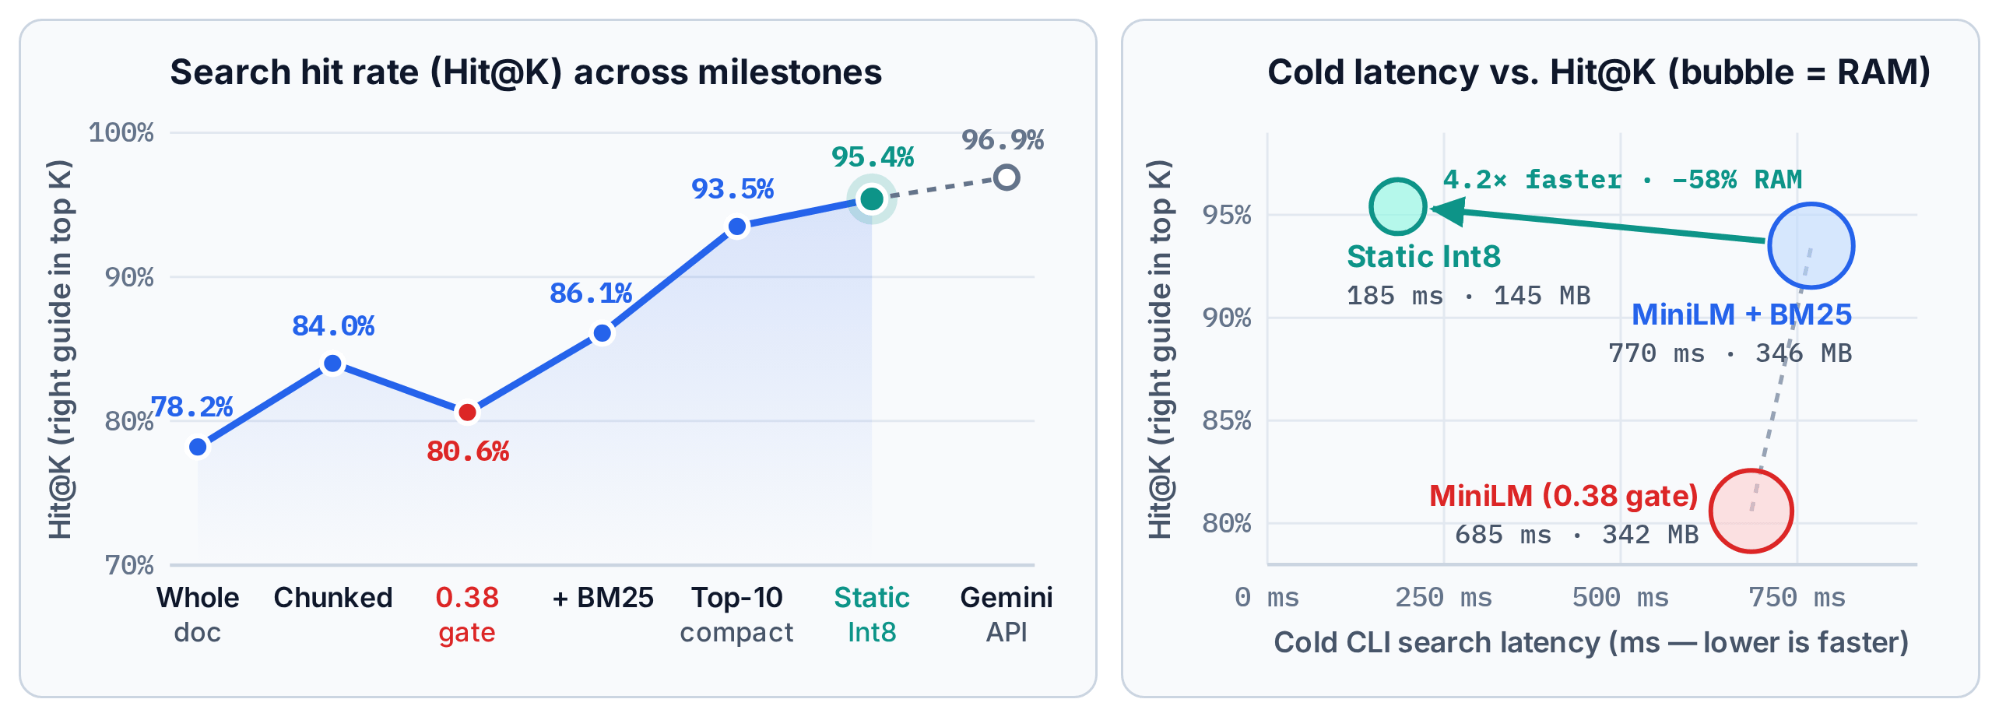
כך נראית ההשוואה בין שלושת הדורות אחרי השקת המטמיע הסטטי:
ואם תריצו את השאילתה הפגומה של Codex ממקודם:
npx modern-web-guidance@latest search "confirm destructive action"
המדריך dialog יופיע שוב בראש הרשימה.
(אפשר לעיין בתרשימים האינטראקטיביים בכל אבני הדרך, אורכי השאילתות וטווחי ה-K במרכז הבקרה של איכות החיפוש.)
הקוד הוא החלק הקל, המדידה היא החלק הקשה
סוכן יכול לכתוב סקריפט לדירוג BM25 או לזיקוק וקטור מילים תוך דקות. יצירת הטמעות מועמדות היא כבר לא צוואר הבקבוק. הידיעה אם שינוי מסוים באמת עזר (או גרם בשקט לתקלה ב-9% מהחיפושים בסביבת הייצור, כמו שקרה עם שער 0.38 שלנו) היא כמעט כל העבודה.
כך פיתחנו את המערכת הזו:
- הגדירו את היעד העיקרי והשקיעו במערכת המדידה, ולא בהטמעה ספציפית. השקענו הרבה יותר זמן בפיתוח
pnpm benchmark:rag, באוצרות של 5,000 שאילתות אמיתיות ובכיול הדירוג האוטומטי שלנו בהשוואה לדירוגים אנושיים, מאשר בכתיבת מאחזר כלשהו. - צרו קריטריונים להערכת האיכות שלכם ושל הסוכנים, וצפו שהם ישתנו כשהם יתבססו על נתונים מהעולם האמיתי. יש אנשים שקוראים לזה "מדידה תחילה", אבל זה נכון רק באופן חלקי: אפשר לכתוב בדיקות בסיסיות של תשובות ידועות ביום הראשון, אבל אי אפשר לתכנן קריטריונים טובים להערכה בוואקום לפני שבודקים כשלים אמיתיים (שאנקר ואחרים קוראים לזה criteria drift במאמר Who Validates the Validators?). כשראינו סוכנים שמפעילים ברירות מחדל של 1,500 טוקנים ב-
list, הבנו שאנחנו חייבים להעניש על ניפוח טוקנים לצד אחזור. - אחרי שקבעתם מדדים מהימנים, אתם יכולים להתנסות באופן אגרסיבי בהטמעות שונות ולתת ללוח התוצאות להכריע בוויכוחים על הארכיטקטורה. אחרי שמריצים בדיקת ביצועים על 5,000 שאילתות תוך כמה שניות, לא צריך להתווכח בבקשות למשיכת קוד (PR) אם לולאת
Int8של 7 שורות יכולה לנצח טרנספורמר של 23MB. אפשר לנסות חמש גישות שונות באותו אחר צהריים ולבחור את הגישה הכי מוצלחת.
כל הקוד (כולל המטמיע, המזקק ורתמת ההשוואה לשוק) הוא כמובן קוד פתוח.