


Data di pubblicazione: 12 novembre 2026
Questa settimana abbiamo lanciato Modern Web Guidance 1.0, una skill open source che aiuta gli agenti di programmazione a utilizzare le funzionalità delle piattaforme web moderne anziché le soluzioni alternative legacy. Questo post esamina il motore di ricerca locale che trova la guida più pertinente per la tua attività, senza sprecare i tuoi token.
Se dici a un ingegnere che hai creato una knowledge base con 1,7 MB di testo Markdown per il suo agente di programmazione, ti farà due domande:
- "Quanti token verranno inseriti nella mia finestra contestuale?"
- "Che tipo di database vettoriale gonfio richiede?"
Negli ultimi sei mesi, abbiamo ricostruito tre volte il nostro motore di recupero locale. Siamo passati da 507 MB di associazioni C++ a 23 MB di JavaScript puro utilizzando TensorFlow.js, per poi scendere a un pacchetto da 7 MB in cui l'incorporamento delle query è un ciclo for di 7 righe, il tutto migliorando l'accuratezza.
RAG agentica e divulgazione progressiva
Inserire 1,7 MB di testo Markdown contenente oltre 200 guide HTML/CSS/API web in AGENTS.md non è pratico. Crediamo nella divulgazione progressiva, ma sappiamo che un indice Markdown smetterà di essere efficiente in termini di token su larga scala.
Per risolvere questo problema, utilizziamo la RAG agentica supportata da un'interfaccia a riga di comando di ricerca:
- Quando non è in uso, l'agente vede solo la descrizione della skill (~205 token). La descrizione segue le linee guida per l'attivazione delle skill di Anthropic in modo che l'agente richiami la skill per le attività di frontend pertinenti.
- Per le attività di frontend, l'agente può utilizzare l'interfaccia a riga di comando per eseguire ricerche:
modern-web-guidance search "animate height auto", ottenendo 10 corrispondenze pertinenti (~530 token). - L'agente esegue
modern-web-guidance retrieve animate-to-intrinsic-sizesper estrarre l'intera guida (circa 800 token). Ora è dotato delle best practice di implementazione per compatibilità, fallback e tecnica.
Perché una skill CLI anziché un server MCP o una ricerca web?
- Gli strumenti MCP sprecano token o hanno meccanismi di attivazione inaffidabili (a causa del rilevamento dinamico degli strumenti). La descrizione della nostra skill è ottimizzata per l'efficacia e consente all'agente di utilizzare le indicazioni solo quando appropriato.
- La ricerca web integrata mostra risposte di Stack Overflow e documenti di riferimento del 2015 anziché pattern di implementazione
DO/DO NOTaggiornati e curati. Inoltre, richiede alcuni secondi sulla rete e non funziona nelle sandbox offline, mentre l'interfaccia a riga di comando locale viene eseguita sulla CPU in millisecondi.
Gen 1: il prototipo C++ da 507 MB
La prima versione di Modern Web Guidance utilizzava uno stack RAG locale: LanceDB, Apache Arrow e Transformers.js con onnxruntime-native.
Funzionava bene su una macchina di sviluppo, ma non era adatto per un'abilità dell'agente:
- Quando aggiungi una skill a un progetto (o un agente la richiama con
npx), non ti aspetti di dover attendere che unnpm installscarichi binari.nodedipendenti dall'architettura o una compilazione C++node-gypche fallisce regolarmente nelle sandbox cloud. - La directory
node_modulesestratta pesava 507 MB.
Gen 2: Golfing TensorFlow.js down to 23 MB
Volevamo una compilazione nativa pari a zero e un'esecuzione istantanea ovunque venga eseguito Node. Quindi, ad aprile, abbiamo sostituito lo stack nativo con un motore CPU JavaScript puro che esegue all-MiniLM-L6-v2 su @tensorflow/tfjs:
- Abbiamo rimosso
onnxruntime-nodein esbuild e sostituito il tokenizzatore Hugging Face con un piccolo tokenizzatore BERT WordPiece in-tree (0 discrepanze di ID token). - Dopo aver esplorato alcune mappe di origine, abbiamo ridotto gli oltre 400 moduli di
@tensorflow/tfjs-backend-cpuai 26 kernel effettivamente utilizzati da MiniLM, riducendo il motore JS da 6 MB a 830 KB. - LanceDB è stato abbandonato a favore di vettori compressi con gzip in fase di build e di una scansione del prodotto scalare
<1 msin memoria su tutte le circa 200 guide. - Inserisci l'embedder dietro una chiamata
import()in modo cheretrieveelistterminino in meno di dieci millisecondi.
In questo modo, il pacchetto npm è stato ridotto a 23 MB senza dipendenze di runtime. Abbiamo lanciato la funzionalità e gli agenti hanno eseguito circa 750.000 ricerche.
Dove MiniLM si è interrotto in produzione
Dopo un paio di mesi, abbiamo esaminato le traiettorie in cui gli agenti avevano installato la skill, ma scrivevano ancora codice legacy.
In una esecuzione di Codex, uno sviluppatore ha chiesto un prompt di conferma dell'eliminazione. Abbiamo un'intera guida sulla creazione di finestre modali di conferma accessibili con l'HTML <dialog closedby="any">.
L'agente ha fatto la cosa giusta e ha cercato:
npx modern-web-guidance@latest search "confirm destructive action"
La CLI ha restituito []. Quindi l'agente ha fatto spallucce e ha scritto window.confirm().
Perché non ha restituito risultati? Quando abbiamo esaminato i log e gli embedding, sono emersi due gap di recupero:
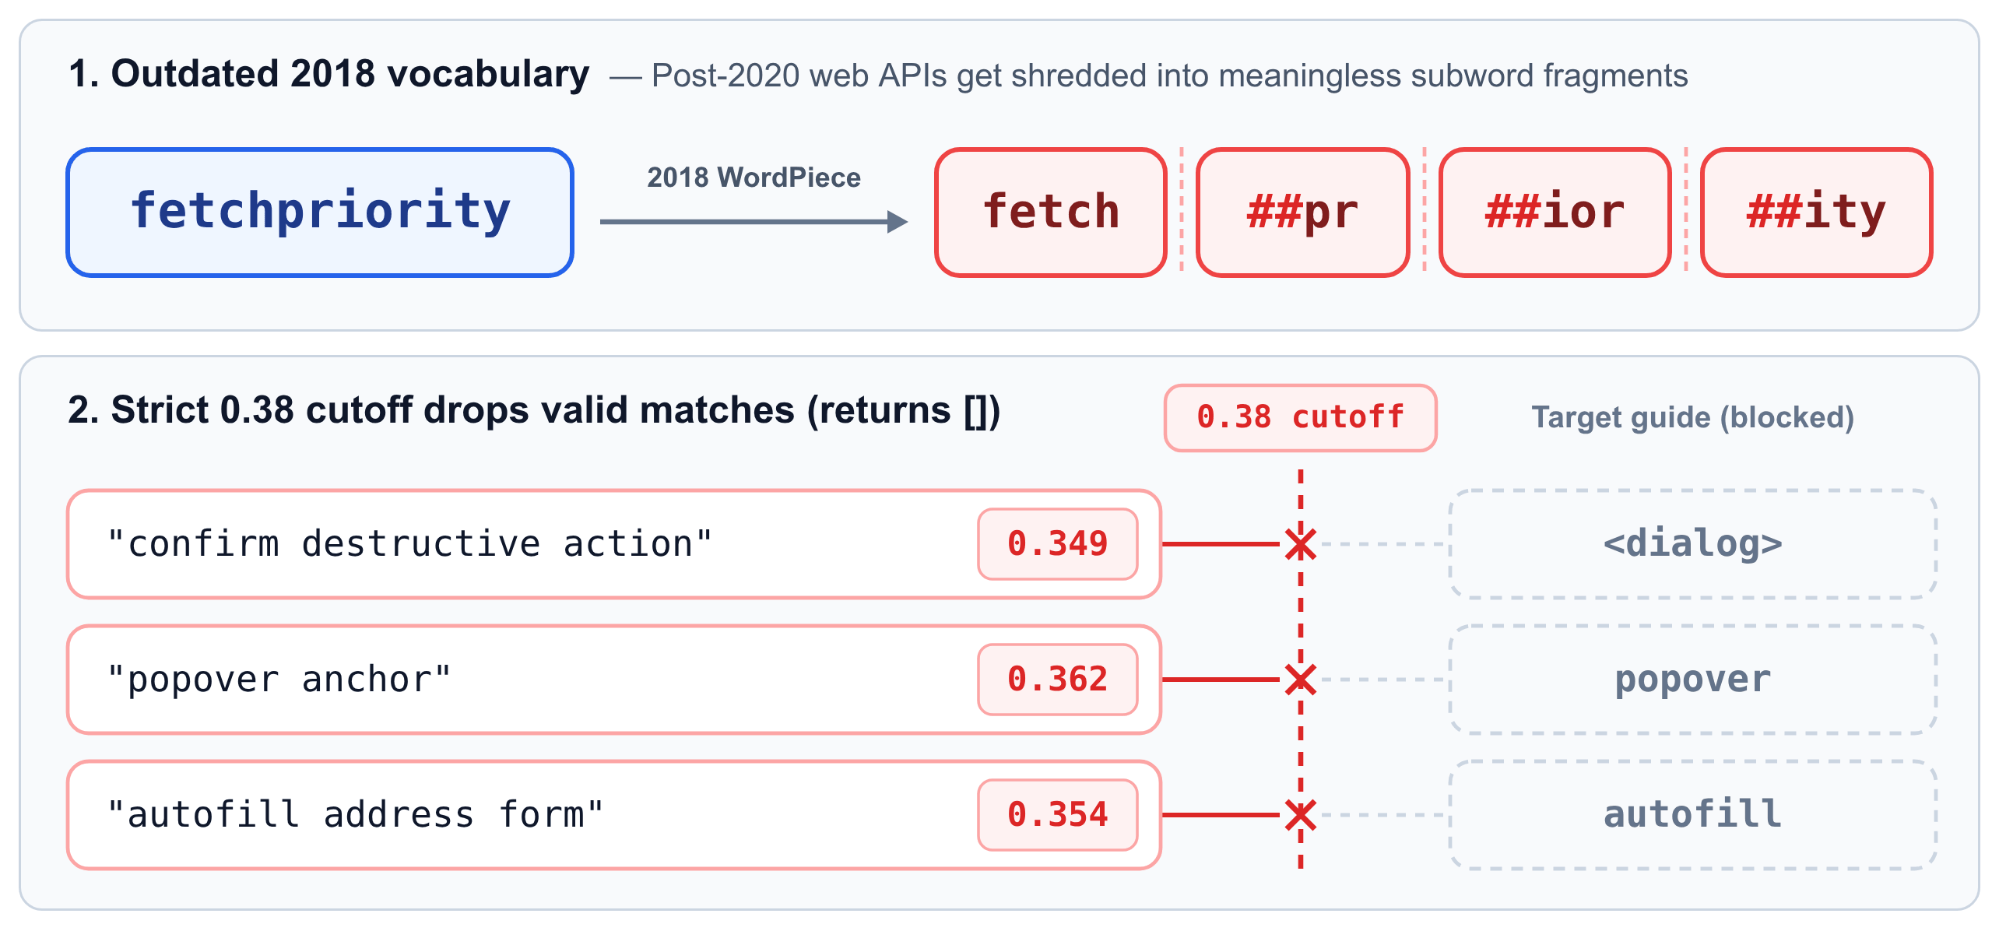
all-MiniLM-L6-v2è stato addestrato intorno al 2018-2020, quindi il suo vocabolario WordPiece letteralmente non sa che esistono API web successive al 2020. Quando un agente cercafetchpriority,popoverostartViewTransition, il tokenizer del 2018 suddividefetchpriorityin quattro parole secondarie prive di significato:fetch·##pr·##ior·##ity.- Per evitare che le query fuori ambito restituiscano guide casuali, una PR precedente aveva aggiunto un limite di somiglianza del coseno
0.38rigoroso. Poiché MiniLM non è riuscito a collegare la frase di 3 parole"confirm destructive action"a"dialog"sopra0.38(punteggio0.349, mentre"popover anchor"ha ottenuto0.362e"autofill address form"ha ottenuto0.354), il gate ha eliminato le corrispondenze valide. Peggio ancora, ogni volta chesearchrestituiva[], le nostre istruzioni per le skill indicavano all'agente di eseguire il fallback amodern-web-guidance list, inserendo nel contesto tutte le circa 200 descrizioni delle guide (circa 1500 token sprecati).
Correzione del recupero: telemetria reale, ricerca ibrida e restituzione di 10 risultati
Il nostro benchmark originale era di 850 query sintetiche generate dalle guide stesse, che corrispondevano troppo fedelmente alla formulazione delle guide per rilevare questi errori. Per questo motivo, abbiamo creato un nuovo framework di valutazione (pnpm benchmark:rag) basato su circa 4000 ricerche dal vivo campionate dalla telemetria dell'interfaccia a riga di comando con disattivazione (che registra solo l'argomento search di 2-5 parole dell'agente, mai i prompt dell'utente o il codice del repository, e rispetta DISABLE_TELEMETRY=1) più 1029 ricerche estratte dalle valutazioni notturne dell'agente su Claude Code, Codex CLI e Gemini CLI.
La riproduzione della nostra cronologia git rispetto a queste query escluse ha mostrato che il limite di 0.38 aveva aumentato di 8 volte le risposte [] vuote. Con il benchmark in atto, abbiamo ottenuto due rapidi miglioramenti prima di toccare il modello di embedding:
- Ricerca semantica + per parole chiave ibrida: i vettori densi confondono i nomi esatti delle API (
:user-invalid,showModal,details-name), mentre la ricerca per parole chiave non rileva le query di intent quando l'agente non conosce il nome dell'API. Abbiamo aggiunto un indice di parole chiave BM25 (se lo conosci, lo conosci) senza dipendenze con stemming plurale, indicizzato ilweb-feature-idsdi ogni guida e fuso BM25 con il ranking semantico. Orasearchrestituisce[]solo quando la somiglianza semantica è<0.30e BM25 ha zero corrispondenze di parole chiave. - 10 risultati compatti anziché 5 dettagliati: le istruzioni della skill indicavano già agli agenti di ignorare
similarityetokenCount. Eliminando i campi inutilizzati, inseriamo 10 risultati{id, description}compatti nello stesso budget di circa 530 token di 5 risultati dettagliati:
// Before: 5 verbose results (~105 tokens each = ~525 tokens)
{
  "id": "dialog",
  "category": "html",
  "description": "Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby.",
  "featuresUsed": ["dialog", "dialog-closedby"],
  "tokenCount": 780,
  "similarity": 0.49
}
// After: 10 compact results (~53 tokens each = ~530 tokens)
{"id":"dialog","description":"Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby."}
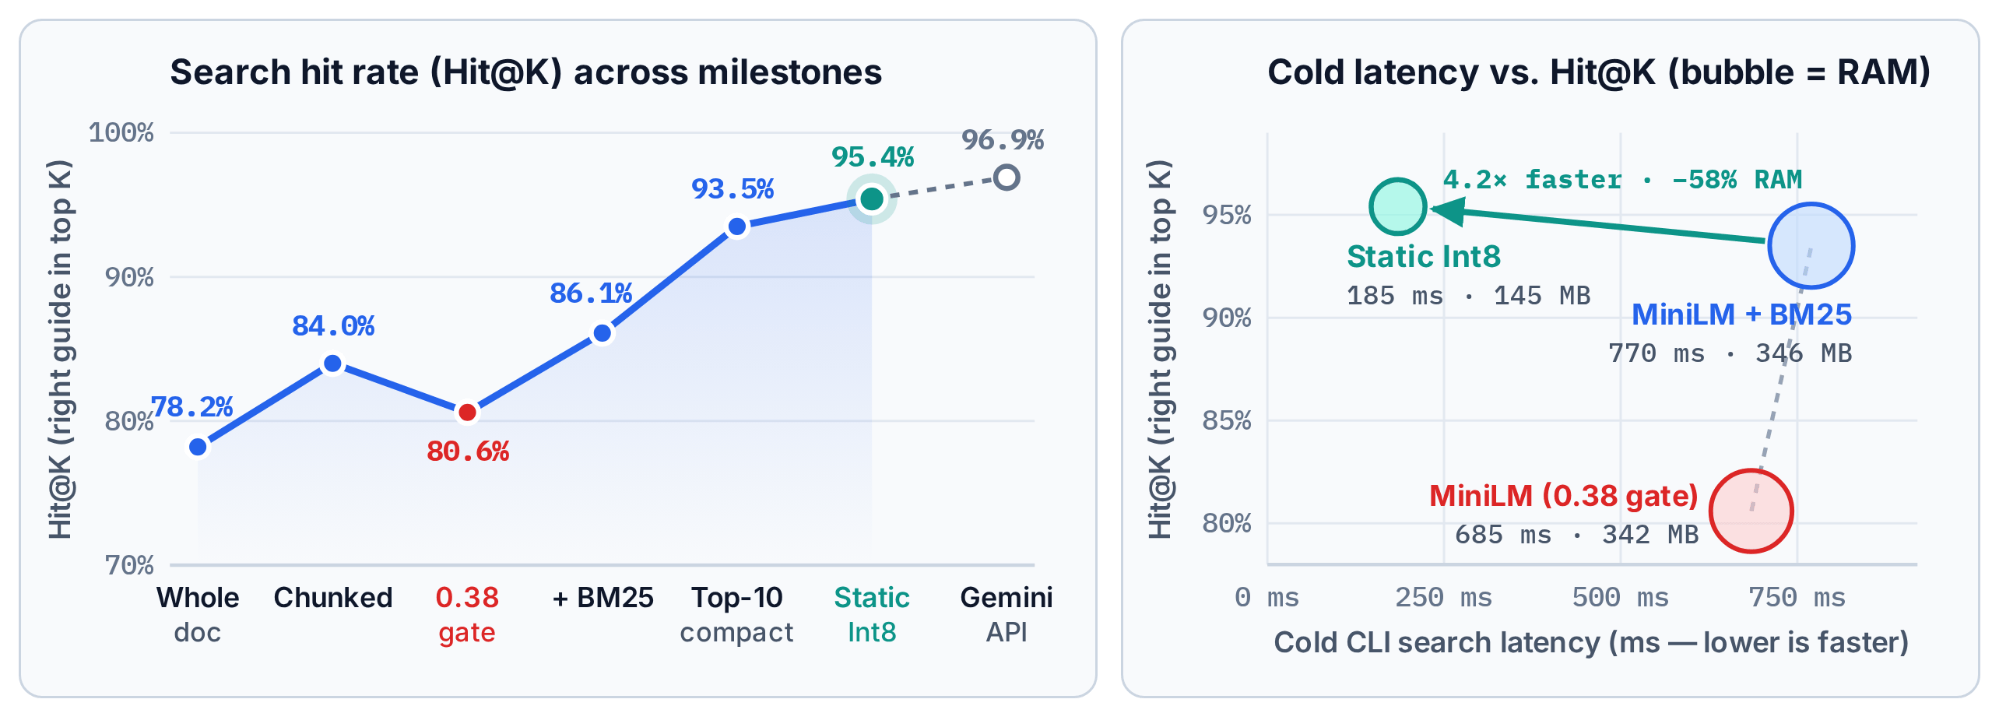
Insieme, queste due modifiche hanno aumentato la percentuale di hit di ricerca sulle query di telemetria escluse dall'80,6% al 94,7%, misurata come Hit@K (ovvero se la guida prevista viene visualizzata nei primi K risultati).
3ª generazione: embedding pre-addestrati e un loop for di 7 righe
Anche con un tasso di successo del 94.7%, la nostra telemetria ha mostrato una discrepanza evidente: l'86,7% delle ricerche degli agenti live era composto da sole 2-5 parole (mediana: 3 parole). Ogni volta che un agente cercava una frase di tre parole, Node avviava TensorFlow.js, analizzava una rete neurale da 22, 6 MB e consumava 770 ms di latenza di avvio a freddo e 346 MB di RAM di picco.
Quando gli è stato chiesto se esistesse un modo più leggero per incorporare query di tre parole senza una rete neurale, il nostro agente Antigravity ha proposto una serie di tecniche di distillazione ML non familiari: Model2Vec, Tokenlearn, dimensioni Matryoshka, Adagrad. (Se vuoi conoscere i dettagli tecnici, consulta la nostra pagina sulla qualità della ricerca.)
La RAG locale standard forza l'elaborazione di documenti e query tramite lo stesso modello di piccole dimensioni sulla CPU dell'utente. Tuttavia, le nostre circa 200 guide non cambiano dopo il rilascio di una versione npm, quindi non c'è motivo di incorporarle con un piccolo modello del 2018. Invece, embed-guide-chunks.ts pre-elabora tutti i nostri vettori guida al momento del rilascio nel cloud utilizzando gemini-embedding-001 e li invia come vettori Int8 binari a 256 dimensioni (guide-chunks.i8, 335 KB compressi con gzip).
In che modo un progetto CLI offline, senza chiave API, proietta la query live di un utente nello stesso spazio vettoriale di Gemini? Poiché le query degli agenti sono quasi sempre composte da 2 a 5 parole, non abbiamo bisogno di un transformer in fase di runtime. Abbiamo solo bisogno di una tabella di ricerca di vettori per le parole note (table) e di un modo intelligente per sommarli. In fase di runtime, l'intera pipeline di TensorFlow.js da 23 MB si riduce a un ciclo for di 7 righe in static-embedder.ts:
// Each word's weight and Int8 scale are pre-folded into `scales[i]`
for (const [i, f] of enc) {
  const wt = scales[i] * f;
  const offset = i * 256;
  for (let k = 0; k < 256; k++) {
    out[k] += wt * table[offset + k];
  }
}
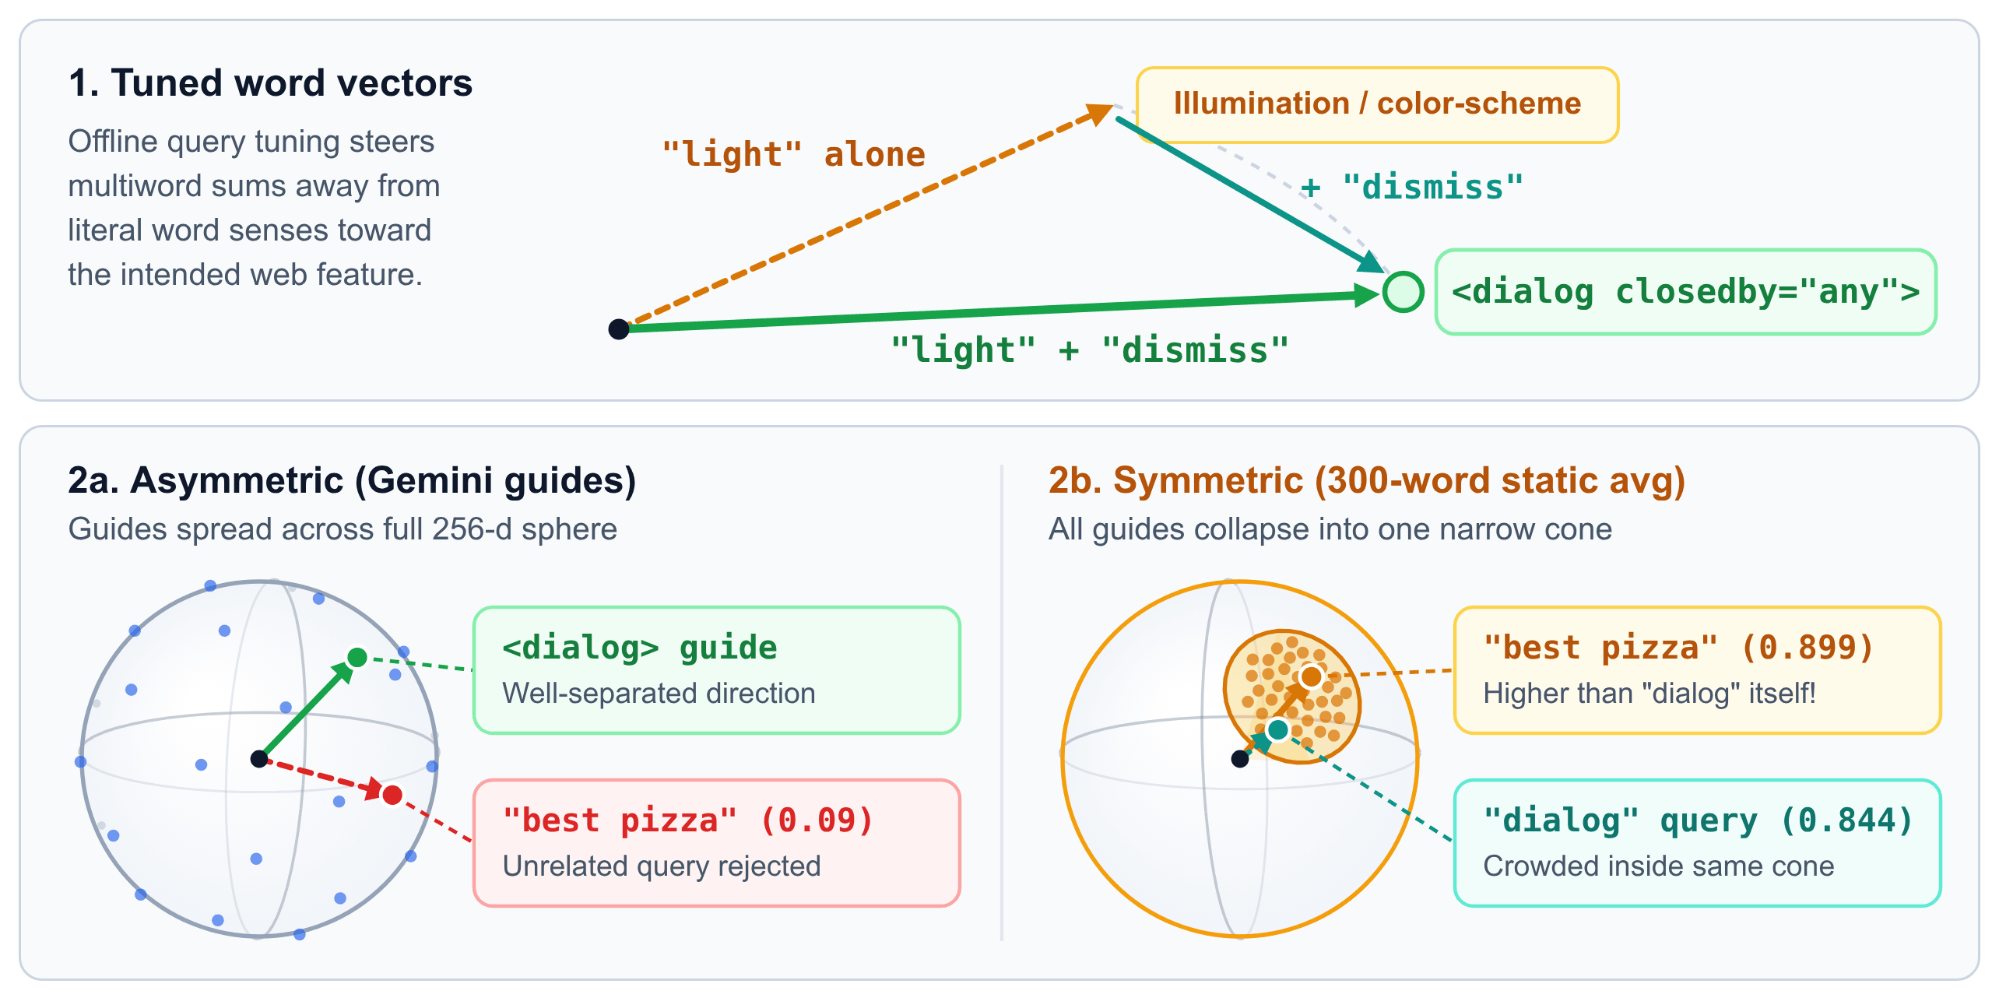
Per creare questa tabella di ricerca (train-query-words.ts), abbiamo preso un vocabolario di 29.165 parole (in cui i termini web moderni come fetchpriority, light-dismiss, popover e scrollytelling sono parole intere autonome), li abbiamo incorporati con gemini-embedding-001 e abbiamo ottimizzato i vettori di parole offline rispetto a 33.000 query web reali in modo che le combinazioni di più parole arrivino nel punto giusto (ad esempio, "light" + "dismiss" punta verso <dialog closedby="any">, non verso l'illuminazione o le combinazioni di colori). Compresso in Int8 (query-words.i8), l'intera tabella di ricerca è 5.3 MB con compressione gzip.
Perché non utilizzare la tabella di ricerca statica anche per incorporare le guide e saltare il passaggio di Cloud Build? Abbiamo provato prima questo approccio, ma non ha funzionato con i paragrafi completi: la somma di 3 parole della query rimane precisa, ma la media di centinaia di parole in una guida completa riduce ogni guida a un cono ristretto vicino alla media generica dell'inglese (al punto che "best pizza in new york" ha ottenuto un punteggio di somiglianza del coseno di 0.899 rispetto alla nostra guida dialog, superiore alla query "dialog" stessa a 0.844!). L'abbinamento di ricerche di query statiche di 3 parole (query-words.i8) con gli embedding delle guide di Gemini del modello completo (guide-chunks.i8) ci offre un'accuratezza di livello cloud, mentre le query vengono comunque eseguite offline in 30 µs.
Il punteggio di tutte e tre le generazioni
Nel corso delle nostre tappe di rilascio, Hit@K è passato dal 78,2% con gli embedding di interi documenti al 95,4% con l'embedder statico Int8 (rispetto al 96,9% con l'API cloud gemini-embedding-001):
Ecco come si confrontano le tre generazioni dopo l'introduzione dell'incorporatore statico:
Se esegui la query Codex errata di prima:
npx modern-web-guidance@latest search "confirm destructive action"
La guida dialog torna in cima all'elenco.
(Puoi esplorare i grafici interattivi per tutti i milestone, le lunghezze delle query e gli orizzonti K nella nostra dashboard sulla qualità della ricerca.)
Il codice è economico; la misurazione è il lavoro
Un agente può scrivere un ranker BM25 o uno script di distillazione di vettori di parole in pochi minuti. La generazione di implementazioni candidate non è più il collo di bottiglia. Sapere se una modifica ha effettivamente aiutato (o ha interrotto silenziosamente il 9% delle ricerche di produzione come ha fatto il nostro gate 0.38) è quasi l'intero lavoro.
Ecco come abbiamo affrontato questo sistema:
- Definisci l'obiettivo principale e investi nel sistema di misurazione anziché in una singola implementazione. Abbiamo dedicato molto più tempo alla creazione di
pnpm benchmark:rag, alla selezione di 5000 query reali e alla calibrazione della nostra valutazione automatica rispetto alle valutazioni umane che alla scrittura di qualsiasi retriever. - Crea una griglia di valutazione per stabilire come tu e i tuoi agenti giudicate la qualità e aspettati che si evolva una volta che entra in contatto con i dati reali. Questo approccio viene definito "measurement-first", ma è corretto solo in parte: puoi scrivere controlli di base con risposte note il primo giorno, ma non puoi progettare una buona rubrica nel vuoto prima di esaminare gli errori reali (Shankar et al. chiamano questo fenomeno criteria drift in Who Validates the Validators?). Vedere gli agenti attivare i fallback
listda 1500 token è ciò che ci ha costretto a penalizzare il token bloat insieme al recall. - Una volta implementate misurazioni affidabili, sperimenta in modo aggressivo diverse implementazioni e lascia che il tabellone dei punteggi risolva i dibattiti sull'architettura. Una volta che un benchmark valuta 5000 query in pochi secondi, non devi discutere nelle PR se un loop
Int8di 7 righe può battere un transformer da 23 MB. Prova cinque approcci in un pomeriggio e mantieni quello vincente.
Naturalmente, tutto il codice (inclusi l'embedder, il distiller e l'harness di benchmark) è open source.