


Ngày xuất bản: 12 tháng 11 năm 2026
Tuần này, chúng tôi đã ra mắt Modern Web Guidance 1.0, một kỹ năng nguồn mở giúp các tác nhân lập trình sử dụng các tính năng hiện đại của nền tảng web thay vì các giải pháp thay thế cũ. Bài đăng này sẽ giới thiệu công cụ tìm kiếm cục bộ giúp tìm hướng dẫn phù hợp nhất cho nhiệm vụ của bạn mà không lãng phí mã thông báo.
Nếu bạn nói với một kỹ sư rằng bạn đã xây dựng một cơ sở kiến thức có 1,7 MB văn bản Markdown cho tác nhân lập trình của họ, thì họ sẽ hỏi hai câu hỏi:
- "Tệp này sẽ đưa bao nhiêu mã thông báo vào cửa sổ ngữ cảnh của tôi?"
- "Cần loại cơ sở dữ liệu vectơ cồng kềnh nào?"
Trong 6 tháng qua, chúng tôi đã xây dựng lại công cụ truy xuất cục bộ 3 lần. Chúng tôi đã giảm từ 507 MB liên kết C++ xuống còn 23 MB JavaScript thuần tuý bằng TensorFlow.js, rồi xuống còn một gói 7 MB, trong đó việc nhúng truy vấn là một vòng lặp for gồm 7 dòng, đồng thời cải thiện độ chính xác.
RAG dựa trên tác nhân và tiết lộ dần
Việc đưa 1,7 MB văn bản Markdown chứa hơn 200 hướng dẫn về HTML/CSS/Web API vào AGENTS.md là không thực tế. Chúng tôi tin vào tiết lộ tăng dần, nhưng biết rằng chỉ mục Markdown sẽ không còn hiệu quả về mã thông báo ở quy mô lớn.
Để giải quyết vấn đề này, chúng tôi sử dụng RAG dựa trên tác nhân được hỗ trợ bởi CLI tìm kiếm:
- Khi không hoạt động, tác nhân chỉ thấy nội dung mô tả của kỹ năng (~205 mã thông báo). Nội dung mô tả tuân theo nguyên tắc kích hoạt kỹ năng của Anthropic để tác nhân gọi kỹ năng cho các nhiệm vụ liên quan đến giao diện người dùng.
- Đối với các nhiệm vụ giao diện người dùng, tác nhân có thể sử dụng CLI để tìm kiếm:
modern-web-guidance search "animate height auto", nhận được 10 kết quả phù hợp (~530 mã thông báo). - Tác nhân chạy
modern-web-guidance retrieve animate-to-intrinsic-sizesđể lấy toàn bộ hướng dẫn (khoảng 800 mã thông báo). Giờ đây, trang này đã được trang bị các phương pháp triển khai hay nhất về khả năng tương thích, phương án dự phòng và kỹ thuật.
Tại sao nên dùng kỹ năng CLI thay vì máy chủ MCP hoặc tìm kiếm trên web?
- Các công cụ MCP có thể lãng phí mã thông báo hoặc có cơ chế kích hoạt không đáng tin cậy (do tính năng khám phá công cụ động). Nội dung mô tả kỹ năng của chúng tôi được tối ưu hoá để đạt hiệu quả cao nhất và cho phép tác nhân chỉ sử dụng hướng dẫn khi thích hợp.
- Tính năng tìm kiếm trên web tích hợp sẵn sẽ hiển thị các câu trả lời và tài liệu tham khảo trên Stack Overflow từ năm 2015 thay vì các mẫu triển khai
DO/DO NOTmới nhất và được tuyển chọn. Quá trình này cũng mất vài giây qua mạng và không thành công trong các hộp cát ngoại tuyến, trong khi CLI cục bộ chạy trên CPU chỉ mất vài mili giây.
Thế hệ 1: Nguyên mẫu C++ 507 MB
Phiên bản đầu tiên của Modern Web Guidance sử dụng một ngăn xếp RAG cục bộ: LanceDB, Apache Arrow và Transformers.js với onnxruntime-native.
Cách này hoạt động tốt trên máy phát triển, nhưng không phù hợp với kỹ năng của tác nhân:
- Khi thêm một kỹ năng vào dự án (hoặc một tác nhân gọi kỹ năng đó bằng
npx), bạn không muốn phải chờnpm installtải tệp nhị phân.nodephụ thuộc vào cấu trúc xuống hoặc quá trình biên dịch C++node-gypthường xuyên không thành công trong hộp cát trên đám mây. - Thư mục
node_modulesđược giải nén có dung lượng 507 MB.
Thế hệ 2: Giảm kích thước TensorFlow.js xuống còn 23 MB
Chúng tôi muốn không cần biên dịch gốc và thực thi tức thì ở bất cứ nơi nào Node chạy. Vì vậy, vào tháng 4, chúng tôi đã thay thế ngăn xếp gốc bằng một công cụ CPU thuần JavaScript chạy all-MiniLM-L6-v2 trên @tensorflow/tfjs:
- Đã loại bỏ
onnxruntime-nodetrong esbuild và thay thế trình mã hoá Hugging Face bằng một trình mã hoá BERT WordPiece nhỏ trong cây (0 mã thông báo không khớp). - Sau khi khám phá một số bản đồ nguồn, đã cắt bớt hơn 400 mô-đun của
@tensorflow/tfjs-backend-cpuxuống còn 26 hạt nhân mà MiniLM thực sự sử dụng, thu nhỏ công cụ JS từ 6 MB xuống còn 830 KB. - Bỏ LanceDB để chuyển sang vectơ nén gzip tại thời điểm xây dựng và quét tích vô hướng
<1 mstrong bộ nhớ trên tất cả khoảng 200 hướng dẫn. - Đặt trình nhúng phía sau lệnh gọi
import()đểretrievevàlisthoàn tất trong chưa đầy 10 mili giây.
Điều này giúp giảm kích thước gói npm xuống còn 23 MB mà không có phần phụ thuộc thời gian chạy. Chúng tôi đã triển khai công cụ này và các nhân viên hỗ trợ đã thực hiện khoảng 750.000 lượt tìm kiếm bằng công cụ này.
Nơi MiniLM bị hỏng trong quá trình phát hành công khai
Sau vài tháng, chúng tôi xem xét những trường hợp mà tác nhân đã được cài đặt kỹ năng nhưng vẫn viết mã cũ.
Trong một lần chạy Codex, một nhà phát triển đã yêu cầu lời nhắc xác nhận xoá. Chúng tôi có một hướng dẫn đầy đủ về cách xây dựng các phương thức xác nhận dễ tiếp cận bằng HTML <dialog closedby="any">.
Nhân viên hỗ trợ đã làm đúng và tìm kiếm:
npx modern-web-guidance@latest search "confirm destructive action"
Giao diện dòng lệnh (CLI) đã trả về []. Thế là nhân viên hỗ trợ nhún vai và viết window.confirm().
Tại sao kết quả trả về lại trống? Khi tìm hiểu nhật ký và các mục nhúng, chúng tôi nhận thấy hai lỗ hổng truy xuất:
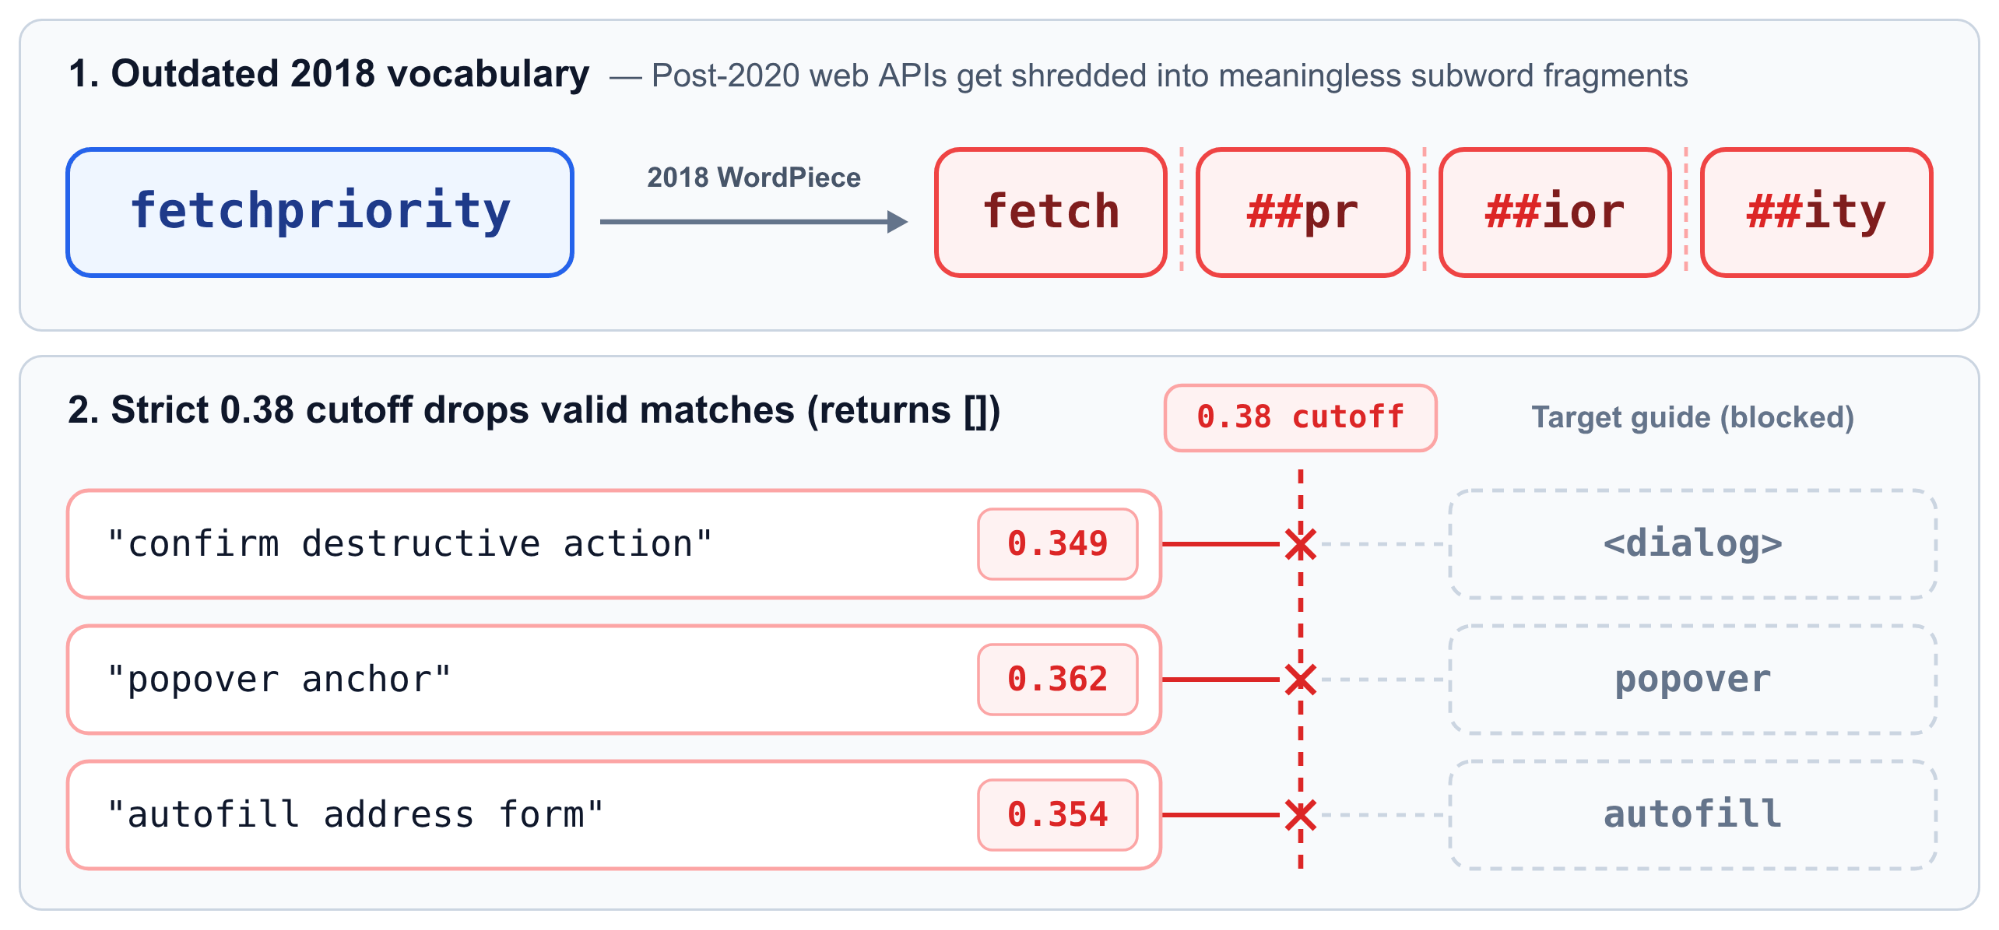
all-MiniLM-L6-v2được huấn luyện trong khoảng thời gian từ năm 2018 đến năm 2020, vì vậy, từ vựng WordPiece của mô hình này hoàn toàn không biết đến sự tồn tại của các API web sau năm 2020. Khi một tác nhân tìm kiếmfetchpriority,popoverhoặcstartViewTransition, trình mã hoá năm 2018 sẽ chia nhỏfetchprioritythành 4 từ phụ vô nghĩa:fetch·##pr·##ior·##ity.- Để ngăn các truy vấn ngoài phạm vi trả về hướng dẫn ngẫu nhiên, một PR trước đó đã thêm giới hạn độ tương đồng cosine
0.38nghiêm ngặt. Vì MiniLM không thể kết nối cụm từ gồm 3 từ"confirm destructive action"với"dialog"trên0.38(đạt điểm0.349, trong khi"popover anchor"đạt0.362và"autofill address form"đạt0.354), nên cổng đã loại bỏ các kết quả khớp hợp lệ. Tệ hơn nữa, mỗi khisearchtrả về[], hướng dẫn về kỹ năng của chúng tôi sẽ yêu cầu tác nhân quay lạimodern-web-guidance list, đưa tất cả ~200 nội dung mô tả hướng dẫn (~1.500 mã thông báo bị lãng phí) vào ngữ cảnh.
Sửa lỗi truy xuất: dữ liệu đo từ xa thực tế, tìm kiếm kết hợp và trả về 10 kết quả
Điểm chuẩn ban đầu của chúng tôi là 850 cụm từ tìm kiếm tổng hợp được tạo từ chính các hướng dẫn, khớp quá sát với cách diễn đạt trong hướng dẫn để phát hiện những lỗi này. Vì vậy, chúng tôi đã xây dựng một bộ công cụ đánh giá mới (pnpm benchmark:rag) dựa trên 4.000 lượt tìm kiếm trực tiếp được lấy mẫu từ dữ liệu đo từ xa của CLI chọn không tham gia (chỉ ghi lại đối số search gồm 2-5 từ của tác nhân, không bao giờ ghi lại câu lệnh của người dùng hoặc mã kho lưu trữ và tuân thủ DISABLE_TELEMETRY=1) cộng với 1.029 lượt tìm kiếm được khai thác từ các bản đánh giá tác nhân hằng đêm trên Claude Code, Codex CLI và Gemini CLI.
Khi xem lại nhật ký git của chúng tôi đối với những truy vấn bị giữ lại đó, chúng tôi nhận thấy rằng ngưỡng 0.38 đã làm tăng số lượng phản hồi [] trống lên 8 lần. Sau khi có điểm chuẩn, chúng tôi đã thực hiện hai điểm cải tiến nhanh trước khi can thiệp vào mô hình nhúng:
- Tìm kiếm kết hợp từ khoá + ngữ nghĩa: Vectơ dày đặc làm mờ tên API chính xác (
:user-invalid,showModal,details-name), trong khi tìm kiếm từ khoá bỏ lỡ các truy vấn ý định khi tác nhân không biết tên API. Chúng tôi đã thêm chỉ mục từ khoá BM25 không phụ thuộc (nếu bạn biết, bạn sẽ hiểu) với tính năng tách gốc từ số nhiều, lập chỉ mụcweb-feature-idscủa mỗi hướng dẫn và kết hợp BM25 với tính năng xếp hạng ngữ nghĩa. Giờ đây,searchchỉ trả về[]khi cả độ tương đồng về ngữ nghĩa là<0.30và BM25 không có kết quả khớp từ khoá nào. - 10 kết quả ngắn gọn thay vì 5 kết quả dài dòng: Chỉ dẫn về kỹ năng đã yêu cầu nhân viên bỏ qua
similarityvàtokenCount. Bằng cách loại bỏ những trường không dùng đến, chúng ta có thể đưa 10 kết quả{id, description}thu gọn vào cùng một ngân sách khoảng 530 mã thông báo như 5 kết quả chi tiết:
// Before: 5 verbose results (~105 tokens each = ~525 tokens)
{
  "id": "dialog",
  "category": "html",
  "description": "Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby.",
  "featuresUsed": ["dialog", "dialog-closedby"],
  "tokenCount": 780,
  "similarity": 0.49
}
// After: 10 compact results (~53 tokens each = ~530 tokens)
{"id":"dialog","description":"Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby."}
Hai thay đổi này đã giúp tăng tỷ lệ tìm kiếm thành công đối với các truy vấn đo từ xa được giữ lại từ 80,6% lên 94,7%, được đo lường dưới dạng Hit@K (liệu hướng dẫn dự kiến có xuất hiện trong K kết quả hàng đầu hay không).
Thế hệ 3: Nhúng được tạo sẵn và vòng lặp for 7 dòng
Ngay cả khi tỷ lệ truy cập là 94.7%, dữ liệu đo từ xa của chúng tôi vẫn cho thấy sự không khớp rõ ràng: 86,7% lượt tìm kiếm nhân viên hỗ trợ trực tiếp chỉ dài từ 2 đến 5 từ (trung bình: 3 từ). Mỗi khi nhân viên hỗ trợ tìm kiếm một cụm từ gồm 3 từ, Node sẽ khởi động TensorFlow.js, phân tích cú pháp mạng nơron 22, 6 MB và tiêu tốn 770 mili giây độ trễ khởi động nguội và 346 MB RAM cao điểm.
Khi được hỏi liệu có cách nào nhẹ hơn để nhúng các truy vấn gồm 3 từ mà không cần mạng nơron hay không, tác nhân Antigravity đã đưa ra một loạt kỹ thuật chắt lọc ML xa lạ: Model2Vec, Tokenlearn, kích thước Matryoshka, Adagrad. (Nếu bạn muốn biết thông tin chi tiết, hãy xem thêm trên trang chất lượng tìm kiếm của chúng tôi.)
RAG cục bộ tiêu chuẩn buộc cả tài liệu và truy vấn phải đi qua cùng một mô hình nhỏ trên CPU của người dùng. Nhưng khoảng 200 hướng dẫn của chúng tôi không thay đổi sau khi chúng tôi phát hành npm, vì vậy, không có lý do gì để nhúng chúng vào một mô hình nhỏ năm 2018. Thay vào đó, embed-guide-chunks.ts chuẩn bị trước tất cả vectơ hướng dẫn tại thời điểm phát hành trên đám mây bằng gemini-embedding-001 và cung cấp dưới dạng vectơ Int8 256 chiều nhị phân (guide-chunks.i8, 335 KB gzipped).
Làm cách nào để một CLI ngoại tuyến, không có khoá API, chiếu câu hỏi trực tiếp của người dùng vào chính không gian vectơ Gemini đó? Vì các truy vấn của nhân viên hỗ trợ hầu như luôn có từ 2 đến 5 từ, nên chúng ta không cần trình biến đổi trong thời gian chạy. Chúng ta chỉ cần một bảng tìm kiếm vectơ cho các từ đã biết (table) và một cách thông minh để tính tổng các vectơ đó. Trong thời gian chạy, toàn bộ quy trình TensorFlow.js 23 MB thu gọn thành một vòng lặp for gồm 7 dòng trong static-embedder.ts:
// Each word's weight and Int8 scale are pre-folded into `scales[i]`
for (const [i, f] of enc) {
  const wt = scales[i] * f;
  const offset = i * 256;
  for (let k = 0; k < 256; k++) {
    out[k] += wt * table[offset + k];
  }
}
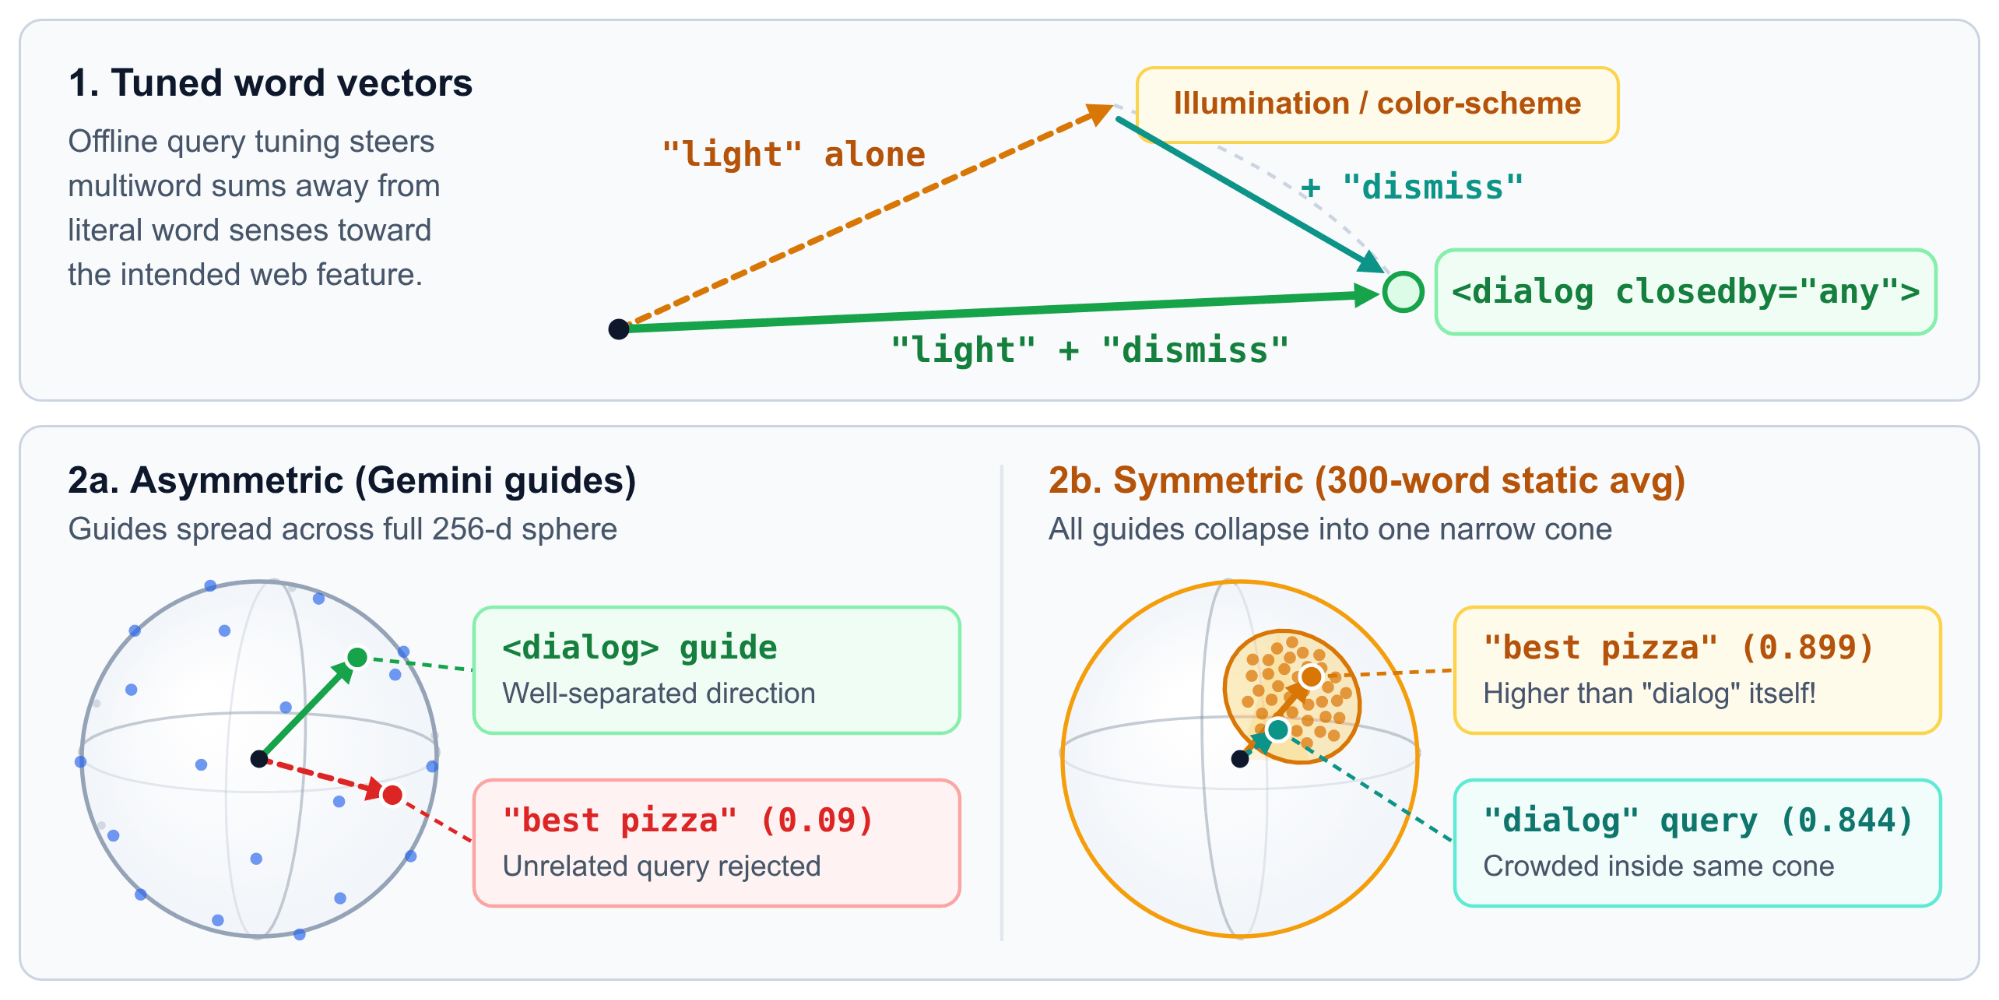
Để xây dựng bảng tìm kiếm đó (train-query-words.ts), chúng tôi đã lấy một vốn từ vựng gồm 29.165 từ (trong đó các thuật ngữ web hiện đại như fetchpriority, light-dismiss, popover và scrollytelling là các từ hoàn chỉnh độc lập), nhúng chúng bằng gemini-embedding-001 và điều chỉnh các vectơ từ ngoại tuyến theo 33.000 cụm từ tìm kiếm thực tế trên web để các tổ hợp nhiều từ nằm đúng vị trí (ví dụ: "light" + "dismiss" trỏ đến <dialog closedby="any">, chứ không phải bảng phối màu hoặc độ sáng). Khi được nén thành Int8 (query-words.i8), toàn bộ bảng tìm kiếm sẽ được nén bằng gzip thành 5.3 MB.
Tại sao không sử dụng bảng tìm kiếm tĩnh đó để nhúng cả hướng dẫn và bỏ qua bước tạo bản dựng trên đám mây? Ban đầu, chúng tôi đã thử cách đó nhưng không hiệu quả với các đoạn văn đầy đủ: việc tính tổng 3 từ truy vấn vẫn chính xác, nhưng việc tính trung bình hàng trăm từ trong một hướng dẫn đầy đủ sẽ thu hẹp mọi hướng dẫn thành một phạm vi hẹp gần với mức trung bình chung của tiếng Anh (đến mức "best pizza in new york" đạt điểm tương đồng cosine là 0.899 so với hướng dẫn dialog của chúng tôi, cao hơn cả chính cụm từ tìm kiếm "dialog" ở mức 0.844!). Việc kết hợp các lượt tra cứu cụm từ tìm kiếm tĩnh gồm 3 từ (query-words.i8) với các mục nhúng hướng dẫn Gemini của mô hình đầy đủ (guide-chunks.i8) mang lại cho chúng tôi độ chính xác ở cấp độ đám mây trong khi các cụm từ tìm kiếm vẫn chạy ngoại tuyến trong 30 µs.
Bảng điểm của cả ba thế hệ
Trong các mốc phát hành, Hit@K đã tăng từ 78,2% khi nhúng toàn bộ tài liệu lên 95,4% khi dùng trình nhúng Int8 tĩnh (so với 96,9% khi dùng Cloud APIs gemini-embedding-001):
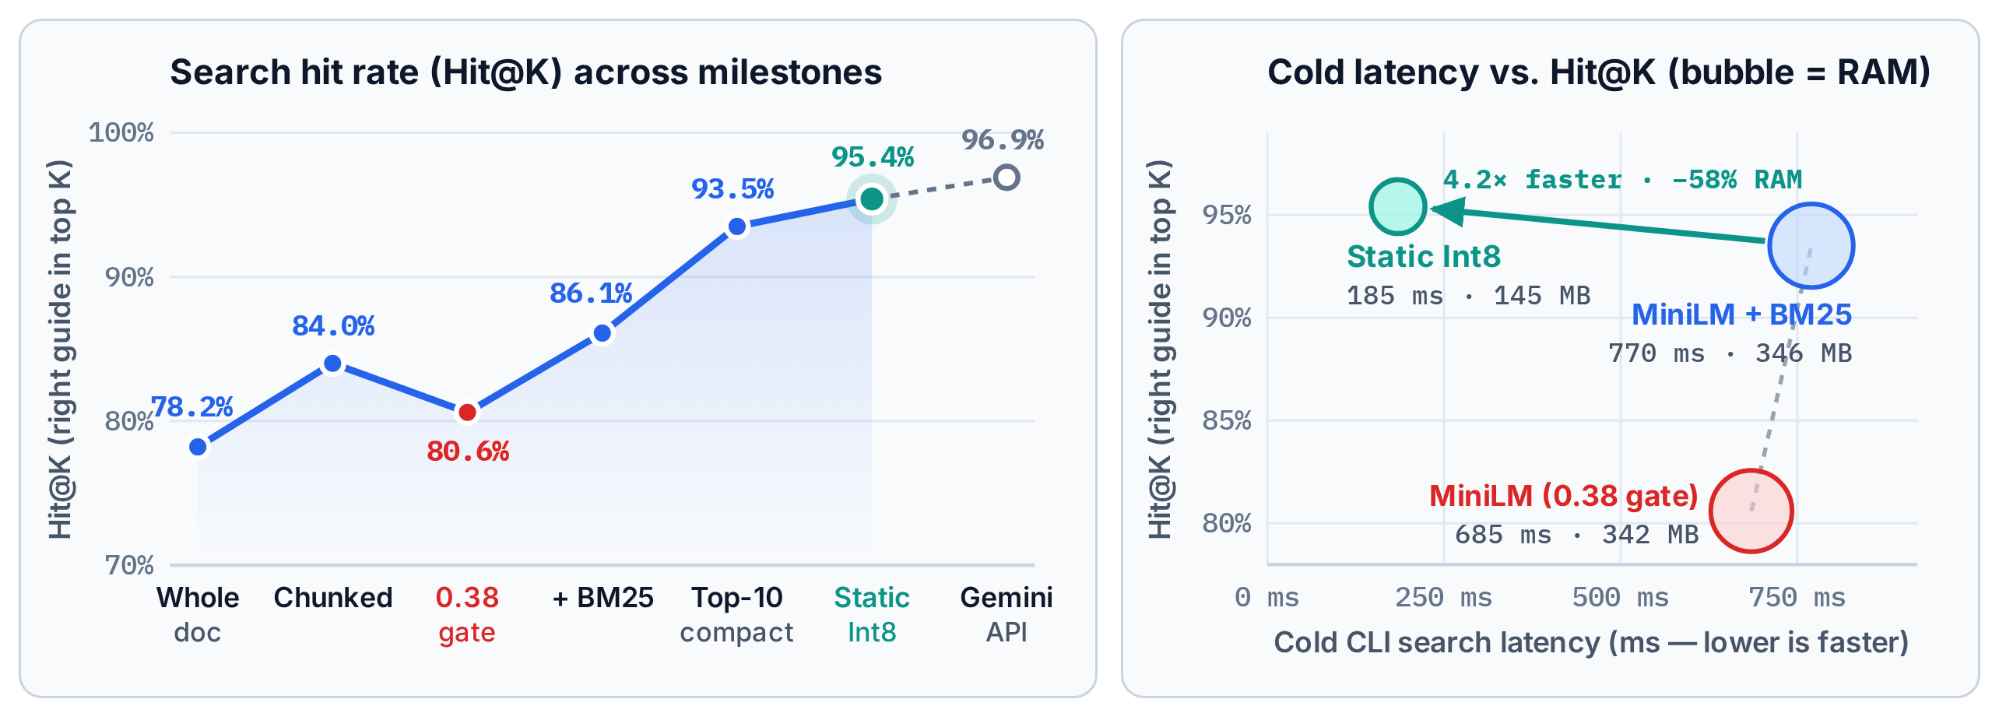
Sau đây là cách ba thế hệ này so sánh với nhau sau khi áp dụng trình nhúng tĩnh:
Và nếu bạn chạy truy vấn Codex bị hỏng từ trước đó:
npx modern-web-guidance@latest search "confirm destructive action"
Hướng dẫn dialog sẽ quay lại đầu danh sách.
(Bạn có thể khám phá các biểu đồ tương tác trên tất cả các mốc, độ dài truy vấn và chân trời K trên Trang tổng quan về chất lượng tìm kiếm của chúng tôi.)
Mã không tốn kém; đo lường mới là công việc chính
Một tác nhân có thể viết một trình xếp hạng BM25 hoặc một tập lệnh chắt lọc vectơ từ trong vài phút. Việc tạo các phương án triển khai không còn là điểm tắc nghẽn nữa. Biết được liệu một thay đổi có thực sự hữu ích hay không (hoặc âm thầm làm hỏng 9% lượt tìm kiếm chính thức như cổng 0.38 của chúng tôi) là gần như toàn bộ công việc.
Sau đây là cách chúng tôi tiếp cận hệ thống này:
- Xác định mục tiêu kim chỉ nam và đầu tư vào hệ thống đo lường thay vì bất kỳ hoạt động triển khai đơn lẻ nào. Chúng tôi dành nhiều thời gian hơn để xây dựng
pnpm benchmark:rag, tuyển chọn 5.000 truy vấn thực tế và hiệu chỉnh điểm số tự động so với điểm số của con người hơn là viết bất kỳ trình truy xuất nào. - Xây dựng một bộ tiêu chí để bạn và các nhân viên đánh giá chất lượng, đồng thời dự kiến bộ tiêu chí này sẽ phát triển khi có dữ liệu thực tế. Mọi người gọi đây là phương pháp "đo lường trước tiên", nhưng điều này chỉ đúng một nửa: bạn có thể viết các quy trình kiểm tra cơ bản dựa trên câu trả lời đã biết ngay từ ngày đầu tiên, nhưng bạn không thể thiết kế một tiêu chí đánh giá tốt trong môi trường tách biệt trước khi kiểm tra các lỗi thực tế (Shankar và cộng sự gọi đây là sự sai lệch tiêu chí trong bài viết Who Validates the Validators? (Ai xác thực trình xác thực?)). Việc thấy các tác nhân kích hoạt cơ chế dự phòng 1.500 token
listlà điều buộc chúng tôi phải phạt tình trạng tăng đột biến token cùng với khả năng truy xuất. - Khi đã có các phép đo lường đáng tin cậy, hãy thử nghiệm mạnh mẽ với nhiều cách triển khai và để bảng điểm giải quyết các tranh luận về cấu trúc. Khi một điểm chuẩn chấm điểm 5.000 truy vấn trong vài giây, bạn không cần phải tranh luận trong PR về việc liệu một vòng lặp
Int87 dòng có thể đánh bại một máy biến áp 23 MB hay không. Thử 5 phương pháp trong một buổi chiều và giữ lại phương pháp hiệu quả nhất.
Tất nhiên, tất cả mã (bao gồm cả trình nhúng, trình chưng cất và bộ đo điểm chuẩn) đều là mã nguồn mở.