


發布日期:2026 年 11 月 12 日
本週我們推出了 Modern Web Guidance 1.0,這項開放原始碼技能可協助程式設計代理使用現代網路平台功能,而非舊版解決方法。本文將介紹本機搜尋引擎,說明如何找出最符合工作需求的指南,避免浪費權杖。
如果您告訴工程師,您為他們的程式設計代理建構了一個 1.7 MB Markdown 文字的知識庫,他們會問兩個問題:
- 「這會將多少詞元傾倒至我的脈絡窗口?」
- 「需要哪種龐大的向量資料庫?」
過去六個月,我們重建了本機檢索引擎三次。我們從 507 MB 的 C++ 繫結,縮減到 23 MB 的純 JavaScript (使用 TensorFlow.js),再縮減到 7 MB 的套件,其中查詢嵌入是 7 行 for 迴圈,同時提高準確度。
代理式 RAG 和漸進式揭露
將 1.7 MB 的 Markdown 文字 (包含超過 200 個 HTML/CSS/Web API 指南) 傾倒至 AGENTS.md 並不切實際。我們相信漸進式揭露,但知道 Markdown 索引在規模擴大時,會停止權杖效率。
為解決這個問題,我們使用由搜尋 CLI 支援的代理式 RAG:
- 在靜態狀態下,代理只會看到技能說明 (約 205 個詞元)。說明遵循 Anthropic 的技能觸發條件指南,讓代理在相關前端工作上叫用技能。
- 在前端工作中,代理可以使用 CLI 搜尋:
modern-web-guidance search "animate height auto",取得 10 個相關相符項目 (~530 個詞元)。 - 代理會執行
modern-web-guidance retrieve animate-to-intrinsic-sizes,提取整份指南 (約 800 個權杖)。現在,這份指南已納入相容性、備用廣告和技術方面的導入最佳做法。
為什麼要使用 CLI 技能,而不是 MCP 伺服器或網頁搜尋?
- MCP 工具會浪費權杖,或觸發機制不可靠 (因為動態工具探索)。技能說明經過最佳化,可確保代理僅在適當情況下採用指引。
- 內建的網頁搜尋功能會顯示 2015 年的 Stack Overflow 答案和參考文件,而非最新、精選的
DO/DO NOT實作模式。此外,透過網路執行需要幾秒鐘,且在離線沙箱中會失敗,而本機 CLI 在 CPU 上執行只需幾毫秒。
第 1 代:507 MB C++ 原型
Modern Web Guidance 的第一個版本使用本機 RAG 堆疊:LanceDB、Apache Arrow 和 Transformers.js 搭配 onnxruntime-native。
這在開發人員機器上運作良好,但不太適合做為代理技能:
- 將技能新增至專案 (或代理透過
npx叫用技能) 時,您不希望等待npm install下載架構相關的.node二進位檔,或node-gypC++ 編譯,因為這些作業在雲端沙箱中經常失敗。 - 解壓縮後的
node_modules目錄大小為 507 MB。
第 2 代:將 TensorFlow.js 縮減至 23 MB
我們希望在任何執行 Node 的地方,都能立即執行,不需原生編譯。因此,我們在 4 月將原生堆疊替換為純 JavaScript CPU 引擎,在 @tensorflow/tfjs 上執行 all-MiniLM-L6-v2:
- 在 esbuild 中移除
onnxruntime-node,並將 Hugging Face 詞元分析器替換為小型樹狀結構內 BERT WordPiece 詞元分析器 (0 個詞元 ID 不相符)。 - 經過一些來源對應探索後,pruned
@tensorflow/tfjs-backend-cpu的 400 多個模組縮減為 MiniLM 實際使用的 26 個核心,將 JS 引擎從 6 MB 縮減為 830 KB。 - 捨棄 LanceDB,改用建構時經 gzip 壓縮的向量,以及記憶體內
<1 ms點積掃描,涵蓋所有 200 多個指南。 - 將嵌入器放在
import()呼叫後方,讓retrieve和list在 10 毫秒內完成。
這樣一來,npm 套件的大小就縮減到 23 MB,且沒有執行階段依附元件。我們推出這項功能後,服務專員對其執行了約 75 萬次搜尋。
MiniLM 在正式環境中發生錯誤的位置
幾個月後,我們觀察了代理已安裝技能,但仍編寫舊版程式碼的情況。
在一次 Codex 執行中,開發人員要求刪除確認提示。我們有一份完整指南,說明如何使用 HTML <dialog closedby="any"> 建構無障礙確認互動視窗。
代理採取正確行動,搜尋了:
npx modern-web-guidance@latest search "confirm destructive action"
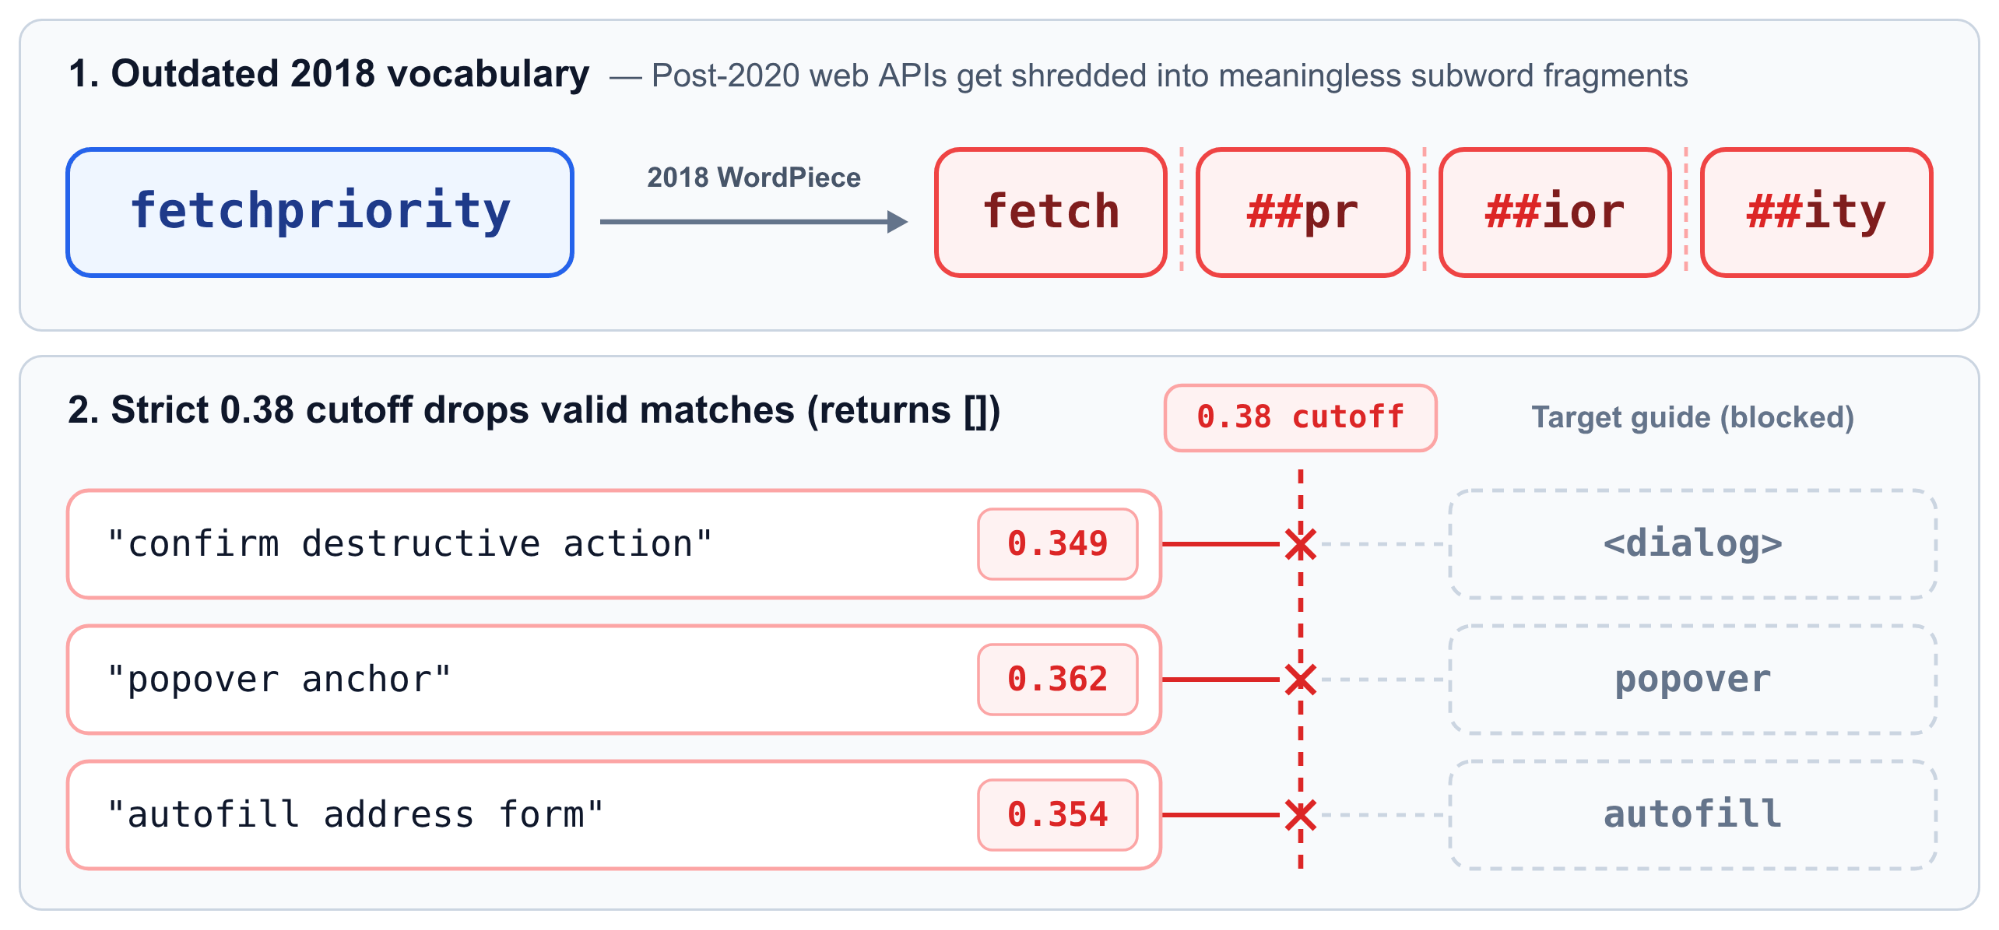
CLI 傳回 []。於是代理聳聳肩,寫下 window.confirm()。
為什麼傳回空白?深入研究記錄和嵌入後,我們發現兩個明顯的檢索落差:
all-MiniLM-L6-v2的訓練時間約在 2018 年至 2020 年,因此其 WordPiece 詞彙完全不知道 2020 年後網路 API 的存在。當代理搜尋fetchpriority、popover或startViewTransition時,2018 詞元分析器會將fetchpriority拆成四個無意義的子字詞:fetch·##pr·##ior·##ity。- 為避免超出範圍的查詢傳回隨機指南,先前的 PR 已新增嚴格的
0.38餘弦相似度截止值。由於 MiniLM 無法將 3 個字詞的詞組「"confirm destructive action"」與「"dialog"」連結,且分數高於0.38(分數為0.349,而「"popover anchor"」為0.362,「"autofill address form"」為0.354),因此閘道會捨棄有效比對。更糟的是,每當search傳回[]時,技能指令就會指示代理改用modern-web-guidance list,將所有約 200 個指南說明 (浪費約 1,500 個詞元) 傾倒至脈絡中。
修正檢索:實際遙測、混合型搜尋和傳回 10 筆結果
我們原本的基準是從指南本身生成的 850 個合成查詢,這些查詢與指南的措辭太過相似,因此無法找出這些失敗。因此,我們建構了新的評估架構 (pnpm benchmark:rag),其中包含從選擇不採用的 CLI 遙測中抽樣的約 4,000 次即時搜尋 (僅記錄代理的 2 到 5 個字詞 search 引數,絕不記錄使用者提示或存放區程式碼,並遵循 DISABLE_TELEMETRY=1),以及從 Claude Code、Codex CLI 和 Gemini CLI 的夜間代理評估中挖掘的 1,029 次搜尋。
我們根據這些保留的查詢重播 git 記錄,發現 0.38 截斷導致空白 [] 回應激增 8 倍。有了基準後,我們在調整嵌入模型前,先進行了兩項快速改善:
- 混合關鍵字 + 語意搜尋:密集向量會模糊確切的 API 名稱 (
:user-invalid、showModal、details-name),而關鍵字搜尋則會在代理不知道 API 名稱時,遺漏意圖查詢。我們新增了零依附元件的 BM25 (懂的人自然懂) 關鍵字索引,並支援複數詞幹分析、為每份指南的web-feature-ids建立索引,以及將 BM25 與語意排名融合。現在,只有在語意相似度為<0.30且 BM25 的關鍵字命中數為零時,search才會傳回[]。 - 10 筆精簡結果,而非 5 筆詳細結果:技能指令已指示代理忽略
similarity和tokenCount。移除這些未使用的欄位後,我們就能在與 5 個詳細結果相同的 ~530 個詞元預算中,放入 10 個精簡的{id, description}結果:
// Before: 5 verbose results (~105 tokens each = ~525 tokens)
{
  "id": "dialog",
  "category": "html",
  "description": "Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby.",
  "featuresUsed": ["dialog", "dialog-closedby"],
  "tokenCount": 780,
  "similarity": 0.49
}
// After: 10 compact results (~53 tokens each = ~530 tokens)
{"id":"dialog","description":"Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby."}
這兩項變更結合後,保留遙測查詢的搜尋命中率從 80.6% 提升至 94.7%,以 Hit@K (預期指南是否出現在前 K 個結果中) 衡量。
第 3 代:預先建立的嵌入和 7 行 for 迴圈
即使命中率為 94.7%,我們的遙測資料仍顯示出明顯的落差:86.7% 的真人服務專員搜尋字詞只有 2 到 5 個字 (中位數:3 個字)。每當服務專員搜尋 3 個字詞的詞組時,Node 就會啟動 TensorFlow.js、剖析 22.6 MB 的類神經網路,並耗費 770 毫秒的冷啟動延遲時間和 346 MB 的 RAM 尖峰用量。
當我們詢問是否有更輕量的方法,可以在不使用類神經網路的情況下嵌入 3 個字詞的查詢時,Antigravity 代理程式傳回了一堆不熟悉的機器學習蒸餾技術:Model2Vec、Tokenlearn、Matryoshka 維度、Adagrad。(如要瞭解技術細節,請參閱搜尋品質頁面)。
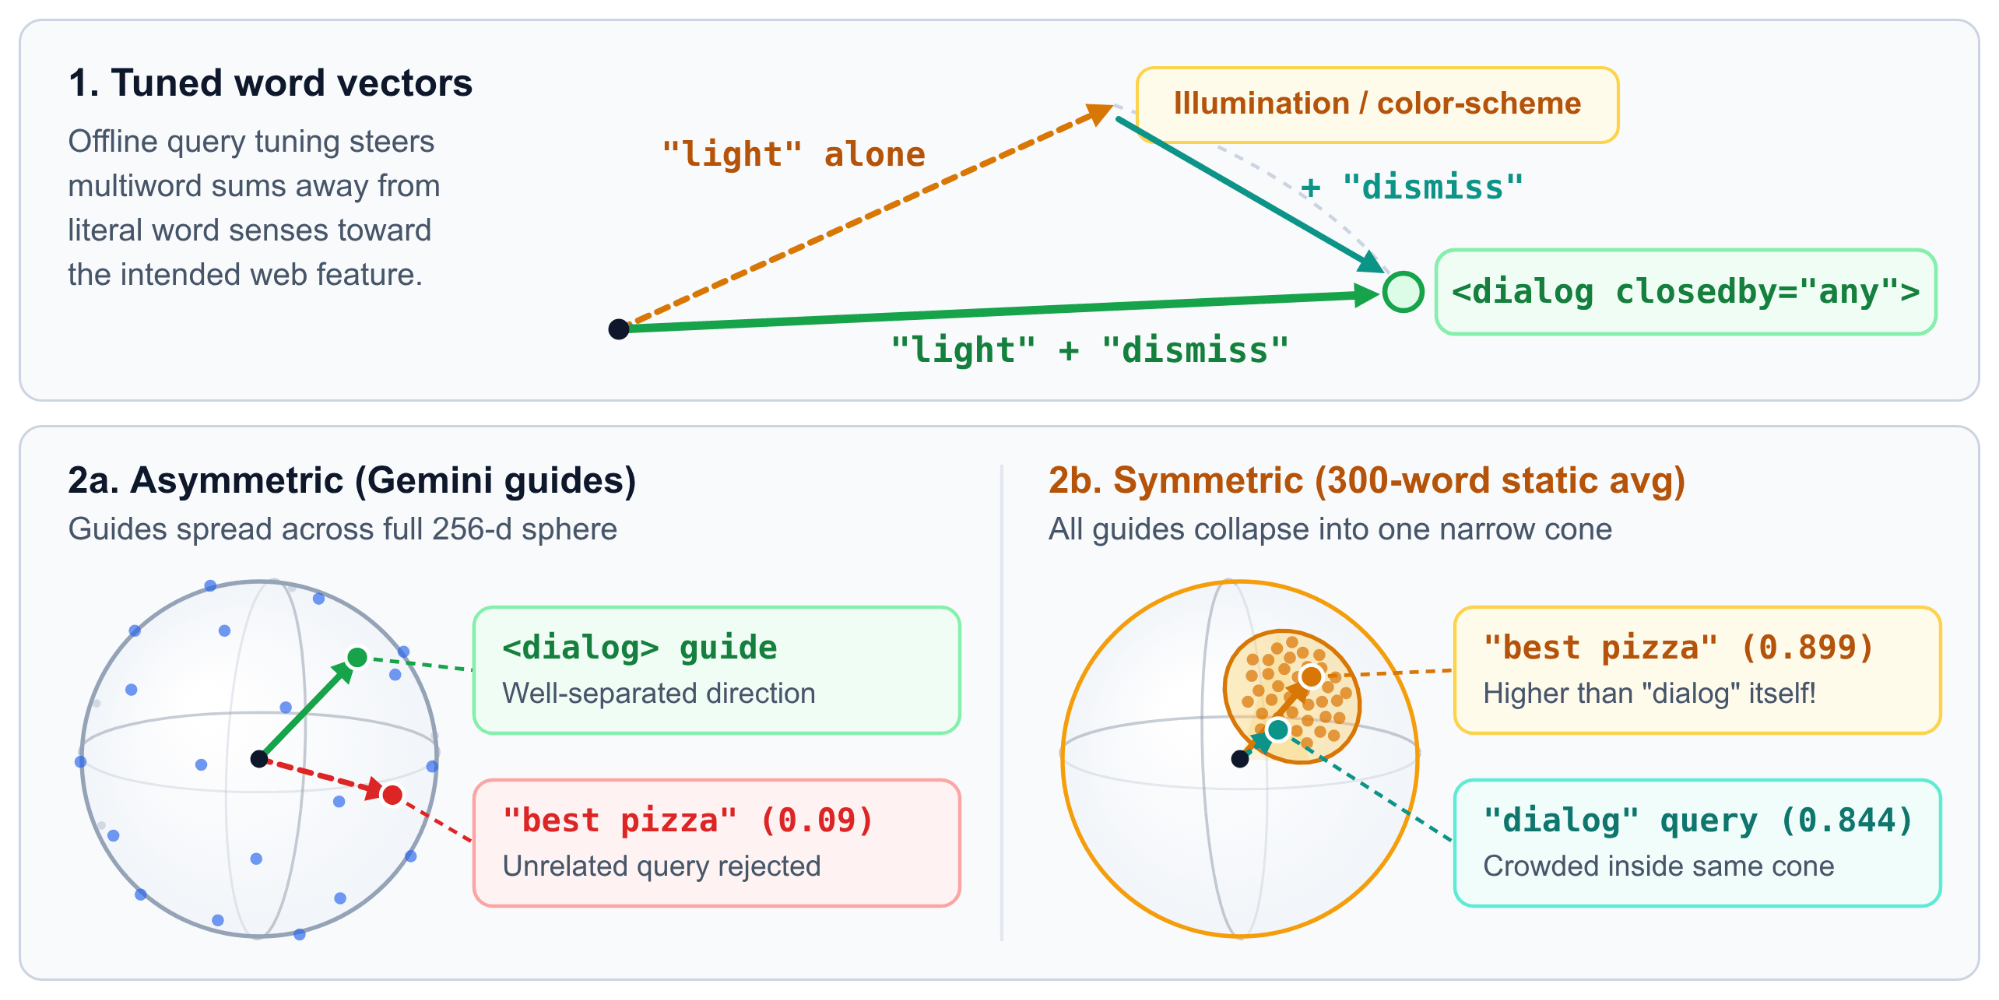
標準本機 RAG 會強制文件和查詢通過使用者 CPU 上的同一個小型模型。不過,我們在發布 npm 版本後,約 200 個指南並未變更,因此沒有理由使用 2018 年的小型模型嵌入這些指南。相反地,embed-guide-chunks.ts 會在發布時使用 gemini-embedding-001 在雲端預先烘焙所有引導向量,並以二進位 256 維 Int8 向量 (guide-chunks.i8,335 KB gzipped) 的形式傳送。
在離線且不使用 API 金鑰的情況下,CLI 專案如何將使用者的即時查詢投射到完全相同的 Gemini 向量空間?由於代理查詢幾乎都是 2 到 5 個字詞,因此我們不需要在執行階段使用轉換器。我們只需要已知字詞 (table) 的向量對照表,以及聰明的加總方式。在執行階段,整個 23 MB 的 TensorFlow.js 管道會 縮減為 static-embedder.ts 中的 7 行 for 迴圈:
// Each word's weight and Int8 scale are pre-folded into `scales[i]`
for (const [i, f] of enc) {
  const wt = scales[i] * f;
  const offset = i * 256;
  for (let k = 0; k < 256; k++) {
    out[k] += wt * table[offset + k];
  }
}
為了建立該查詢表 (train-query-words.ts),我們採用了包含 29,165 個字詞的詞彙表 (其中 fetchpriority、light-dismiss、popover 和 scrollytelling 等現代網路字詞是獨立的完整字詞),使用 gemini-embedding-001 嵌入這些字詞,並針對 33,000 個實際網路查詢離線調整字詞向量,讓多字詞組合落在正確的位置 (例如 "light" + "dismiss" 指向 <dialog closedby="any">,而不是照明或色彩配置)。壓縮至 Int8 (query-words.i8),整個對照表會以 gzip 壓縮至 5.3 MB。
為什麼不使用該靜態對照表嵌入指南,並略過 Cloud Build 步驟?我們一開始嘗試過這種做法,但處理完整段落時就失效了:加總 3 個查詢字詞仍能保持精確,但平均整份指南中的數百個字詞,會導致每份指南都縮減成接近一般英文平均值的狹窄錐體 (甚至 "best pizza in new york" 與 dialog 指南的餘弦相似度分數為 0.899,高於查詢 "dialog" 本身的 0.844!)。將 3 個字詞的靜態查詢對照表 (query-words.i8) 與完整模型 Gemini 指南嵌入 (guide-chunks.i8) 搭配使用,可提供雲端級準確度,同時查詢仍可在 30 微秒內離線執行。
三個世代的計分板
在各個版本里程碑中,Hit@K 從 78.2% (使用整份文件嵌入) 提升至 95.4% (使用靜態 Int8 嵌入器),而雲端 gemini-embedding-001 API 則為 96.9%:
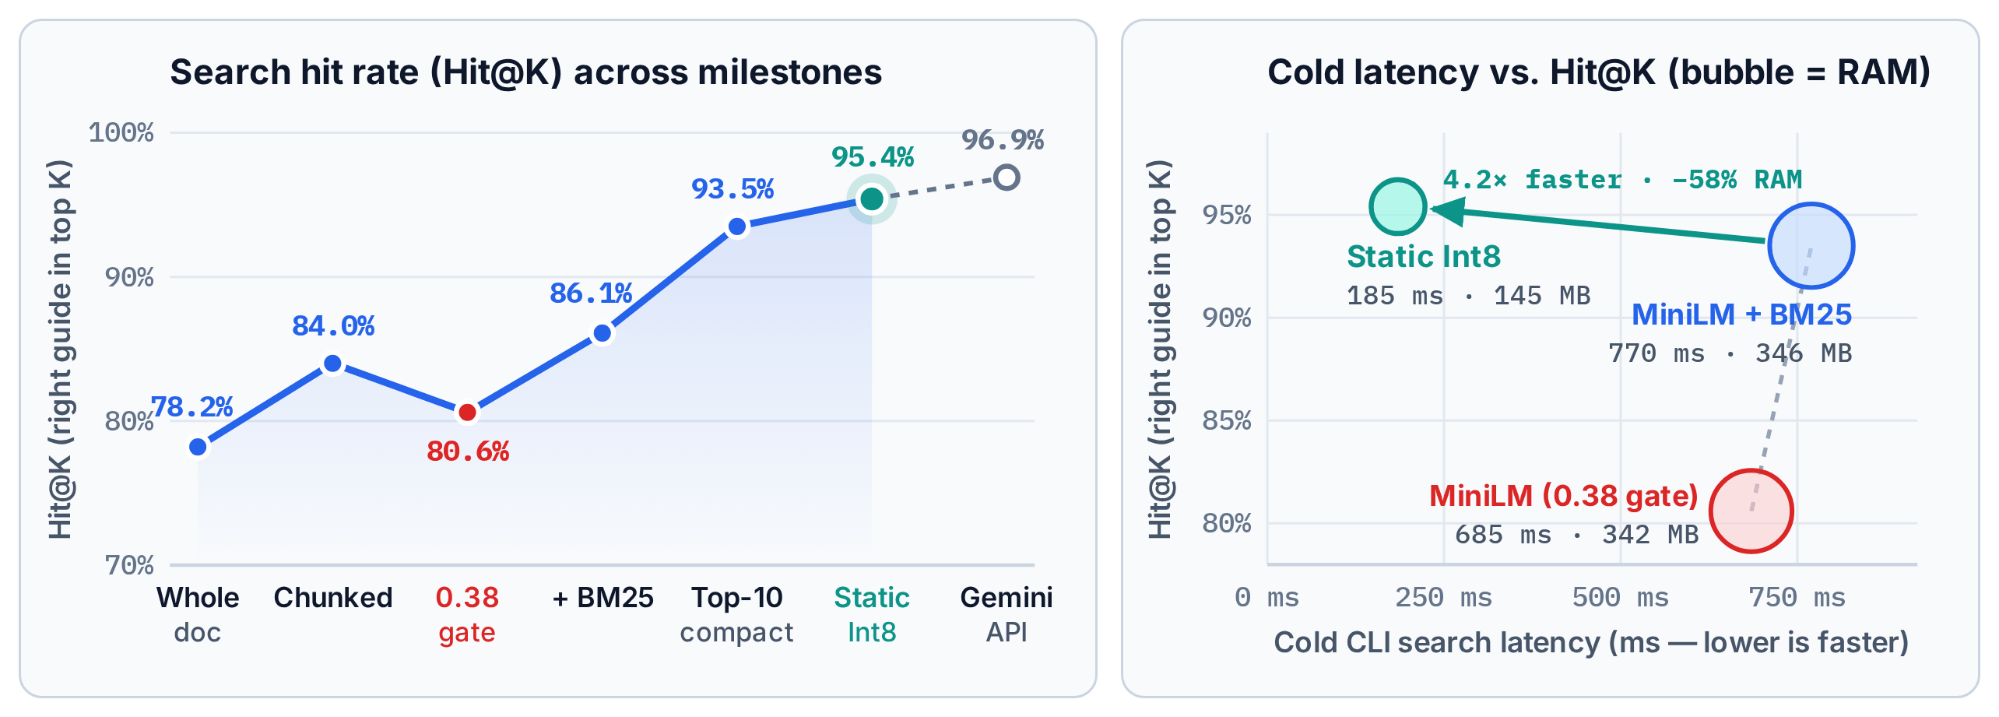
導入靜態嵌入器後,這三個世代的比較結果如下:
如果執行先前有問題的 Codex 查詢:
npx modern-web-guidance@latest search "confirm destructive action"
dialog指南會回到清單頂端。
(您可以在搜尋品質資訊主頁中,探索所有里程碑、查詢長度和 K 範圍的互動式圖表。)
程式碼不值錢,評估才是重點
代理可以在幾分鐘內編寫 BM25 排名器或字詞向量蒸餾指令碼。生成候選實作項目不再是瓶頸。瞭解變更是否確實有幫助 (或像我們的 0.38 閘道一樣,悄悄破壞了 9% 的正式版搜尋),幾乎是整個工作的重點。
我們對這個系統的處理方式如下:
- 定義北極星目標,並投資評估架構,而非單一導入作業。我們花在建構
pnpm benchmark:rag、挑選 5,000 個真實查詢,以及根據人工評分校準自動評分的時間,遠比編寫任何檢索器還要多。 - 建立評估標準,讓您和代理評估品質,並在實際資料出現時調整標準。有人稱這種做法為「評估優先」,但這只對了一半:您可以在第一天就編寫基本的已知答案檢查,但如果沒有先檢查實際失敗案例,就無法憑空設計出良好的評分標準 (Shankar 等人在《Who Validates the Validators?》中稱此為「標準漂移」)。我們發現代理會觸發 1,500 個權杖的
list備用機制,因此決定在評估召回率時,一併對權杖膨脹問題扣分。 - 有了可靠的評估機制,您就能積極嘗試不同的導入方式,並根據評分結果解決架構爭議。一旦基準測試能在幾秒內評估 5,000 個查詢,您就不必在 PR 中爭論 7 行
Int8迴圈是否能勝過 23 MB 的 Transformer。在一個下午嘗試五種方法,並保留成效最佳的方法。
當然,所有程式碼 (包括嵌入器、蒸餾器和基準測試工具) 都是開放原始碼。