

Veröffentlicht: 10. November 2026
Policybazaar ist eine der führenden Versicherungsplattformen in Indien mit mehr als 97 Millionen registrierten Kunden. Etwa 80 % der Kunden besuchen die Website jeden Monat. Die Muttergesellschaft PB Fintech hat vor Kurzem Pensionbazaar eingeführt, eine End-to-End-Plattform für die Altersvorsorge, die eine Marke von Paisabazaar Marketing & Consulting Private Limited ist.
Beide Teams verwenden bereits Coding-Agenten, die Code schnell schreiben, aber nicht sehen können, was dieser Code in einem Browser tut. KI-Agenten griffen oft auf veraltete Webmuster zurück und hatten keine Möglichkeit, zu prüfen, ob ein Bildschirm korrekt gerendert wurde. Daher mussten Entwickler alles manuell überprüfen.
Um dieses Problem zu lösen, haben beide Unternehmen zwei Tools in ihren Agentic Workflow integriert: Modern Web Guidance, um Modellen moderne Webstandards beizubringen, und Chrome-Entwicklertools für KI-Agenten, um diesen KI-Agenten einen Live-Headless-Browser zur Verfügung zu stellen, mit dem sie ihre Arbeit prüfen und verifizieren können.
Das hat folgende Auswirkungen:
92 %
Weniger manueller Prüfaufwand für etwa 30 Landingpages von Policybazaar
> 90 %
Schnellere Entwicklung und Tests neuer Pensionbazaar-Seiten – von etwa vier Tagen auf wenige Stunden
> 90 %
Weniger UI-Fehler bei neuen Pensionbazaar-Bildschirmen
Die Herausforderung: Schneller Code, langsame Überprüfung
Policybazaar und Pensionbazaar stießen auf zwei verschiedene Engpässe, die mit den Standard-KI-Codierungs-Workflows auf Produktionsebene nicht optimiert werden konnten.
Pensionbazaar: Neue Bildschirme mit langen QA-Zyklen
Pensionbazaar benötigte Dutzende neuer, komplexer Bildschirme, z. B. den mehrstufigen Retirement Freedom Score-Rechner, anpassbare Prognosen für Investitionsausgaben und automatisierte Empfehlungsberichte. Das Team hat sie mit Coding-Agenten und dem Figma-MCP-Server erstellt, aber zwei Probleme haben die QA-Zyklen in die Länge gezogen.
Erstens: Die Agenten haben im Dunkeln programmiert. Ein Basismodell könnte Code generieren, aber es könnte nicht die gerenderte Oberfläche sehen, berechnete Stile mit den Designspezifikationen vergleichen, Layoutverschiebungen erkennen oder einen Netzwerk-Wasserfall lesen. So gelangten verwandte Probleme wie abgeschnittene UI-Elemente und Layoutverschiebungen bis zur manuellen Qualitätssicherung.
Zweitens war der generierte Code veraltet. Ohne Kenntnis der modernen Webplattform griffen die Agenten auf veraltete Problemumgehungen zurück, schrieben komplexe JavaScript-Modale, anstatt das integrierte <dialog>-Element zu verwenden, fügten unnötige Polyfills hinzu und ließen Leistungshinweise wie fetchpriority weg.
Policybazaar: 30 Landingpages und eine manuelle Prüfung
Das Lebensversicherungsteam von Policybazaar betreibt etwa 30 Landingpages für verschiedene Versicherungsprodukte. Jede Seite kann Varianten für verschiedene Marketingkampagnen haben. Zusammen verzeichnen sie 200.000 bis 300.000 Besucher pro Tag und jede Seite erhält monatliche Design- und Geschäftslogik-Updates. Das Team muss die Core Web Vitals-Werte hoch halten und dafür sorgen, dass jede Variante barrierefrei bleibt und auf jeder Bildschirmgröße korrekt gerendert wird.
Vor der Automatisierung hat ein Entwickler jede Seite manuell geprüft:
- Führen Sie PageSpeed Insights aus, um Praxisdaten von Nutzern zu erfassen.
- Sehen Sie sich die Core Web Vitals-Werte und -Empfehlungen an.
- Prüfen Sie den Entwicklungs- oder Staging-Build, diagnostizieren Sie die Probleme hinter den Ergebnissen und wenden Sie Codekorrekturen an.
Der Prozess war langsam, repetitiv und nicht skalierbar. Es gab Raum für verpasste Optimierungen, inkonsistente Audit-Abdeckung, unentdeckte Leistungsrückgänge und verzögerte Releases.
Vor der Änderung des Workflows setzten sich die Teams drei Ziele: die Zeit, die Entwickler für Leistungsprüfungen aufwenden, um mehr als 80 % zu reduzieren und gleichzeitig die Prüfungsabdeckung kontinuierlich zu gestalten, die QA-Bearbeitungszeit mit verifizierten Berichten zu verkürzen und die Anzahl der UI-Fehler zu reduzieren, die auftreten, weil ein Bildschirm nicht mit den Wireframes übereinstimmt.
Die Lösung: Ein Code-to-Verify-Loop
Pensionbazaar hat die Lücke zwischen dem Schreiben und dem Prüfen von Code geschlossen. Der Agent schreibt den Code, startet eine neue Browserinstanz, prüft die Seite programmatisch auf visuelle Parität, Layoutfehler, Konsolenfehler und Leistung und behebt die gefundenen Probleme mit minimalem menschlichem Eingriff. Der Agent ruft das Design aus Figma MCP ab, um die gerenderte Seite mit dem Entwurf der Designer zu vergleichen.
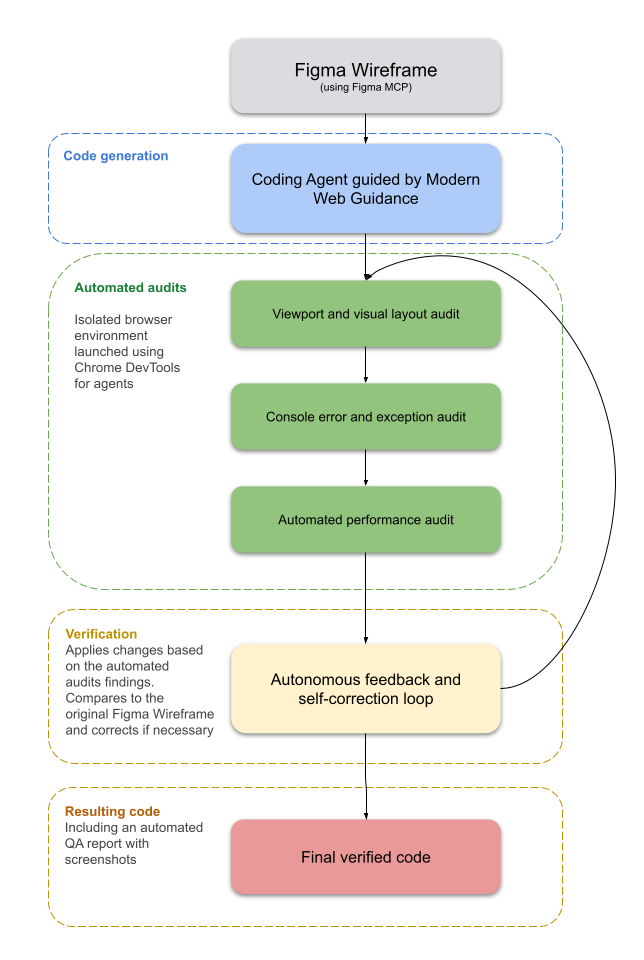
Das folgende Video zeigt diese Schleife in Aktion. Der KI-Agent liest die Figma-Designs für einen neuen Bildschirm, implementiert ihn und verwendet dann die Chrome-Entwicklertools für KI-Agenten, um die gerenderte Seite zu prüfen und die gefundenen Unterschiede zu beheben.
Schritt 1: Agenten auf modernen Webstandards fundieren
Das Pensionbazaar-Team wollte, dass der generierte Code den Best Practices für das moderne Web entspricht, aktuelle Plattformfunktionen nutzt und trotzdem in älteren Browsern funktioniert. Das ist mühsam, manuell zu überprüfen, und die Agenten sind nicht immer auf dem neuesten Stand der Plattform. Modern Web Guidance löst dieses Problem. Es handelt sich um eine Agenten-Skill, die von Webexperten von Chrome und der Web-Community geschrieben und gepflegt wird und mehr als 200 Anwendungsfälle abdeckt. Es lenkt Agenten zu modernen Webplattform-APIs und zu Best Practices für Leistung und Barrierefreiheit, die zu Ihrem Baseline-Ziel passen. Wenn Sie kein Ziel festlegen, wird standardmäßig Baseline Widely Available verwendet.
Nachdem der KI-Agent den Kontext aus den Figma-Dateien abgerufen hat, verwendet er beim Schreiben von Code Modern Web Guidance. Für Pensionbazaar wurde der Code dadurch auf drei Arten geändert:
- Native Elemente ersetzen JavaScript-Workarounds. Der Agent hat das integrierte
<dialog>-Element und die Popover API für die Modalfenster mit den Tarifdetails sowie CSS Grid und Flexbox für die Zusammenfassungskarten verwendet. - Der KI-Agent hat Leistungshinweise hinzugefügt, die von Basismodellen normalerweise weggelassen werden.
Dazu gehörten
fetchpriority="high"für Hero-LCP-Bilder,loading="lazy"für Plan-Karten unterhalb der Falz und ein zeitbasiertes Ausführungsbudget mitscheduler.yield()zum Schutz von Interaction to Next Paint (INP). - Moderne Funktionen haben ältere Browser nicht beeinträchtigt. Pensionbazaar unterstützt ältere Browserversionen, die in Browserslist definiert sind. Der Agent hat Funktionen wie die CSS-Pseudoklasse
:user-invalidundautoComplete="one-time-code"für das Feld für das Einmalpasswort (OTP) verwendet. Ältere Browser ignorieren sie und die Hauptfunktionen bleiben erhalten.
Die Basismodelle waren nicht weit davon entfernt. Das Team stellte fest, dass sie in Bezug auf die Leistung zu etwa 70 % den Best Practices entsprachen. Im Bericht des KI-Agenten selbst wurden 12 Modern Web Guidance-Regeln aufgeführt, die die verbleibende Lücke schlossen. Vier Beispiele:
| Region | Die Lücke im Basismodell | Die Regel „Modern Web Guidance“ |
|---|---|---|
| Bild wird geladen | Halluzinierte widersprüchliche Kombinationen, z. B. die Kombination von fetchpriority="high" mit loading="lazy". |
Verbietet ausdrücklich, sie zu kombinieren, und beschränkt Bilder mit hoher Priorität auf ein oder zwei pro Seite. |
| Layoutstabilität | content-visibility: auto wurde für die Leistung vorgeschlagen, contain-intrinsic-size wurde jedoch weggelassen. |
Die beiden Properties müssen gekoppelt werden, um starke Layoutverschiebungen beim Rendern von Inhalten zu verhindern. |
| Hauptthread-Yielding | scheduler.yield() wurde allgemein ohne Fristmuster verwendet. |
Erzwingt eine strikte zeitbasierte Frist (performance.now() + 50), um Interaction to Next Paint (INP) zu schützen. |
| Service Worker-Caching | Offline-Formulareinreichungen wurden nicht berücksichtigt. | Warnt den Agent, dass Service Worker Nicht-GET-Anfragen nicht nativ im Cache speichern können. |
Bei Pensionbazaar war es uns von Anfang an wichtig, hochwertigen Code zu schreiben, um später technische Schulden zu vermeiden. Modern Web Guidance hat unseren Coding-Agenten dazu gebracht, moderne Webstandards und Best Practices für die Leistung zu übernehmen und gleichzeitig unsere spezifischen Ziele für die Browserkompatibilität zu berücksichtigen. Dadurch wurden unsere Frontend-Codeüberprüfungen erheblich einfacher und schneller, was letztendlich unsere Entwicklungszeit verkürzte.
Aman Soni, Engineering Manager, Policybazaar
Schritt 2: Agenten einen Browser zur Verfügung stellen
Die Chrome-Entwicklertools für KI-Agenten sind eine Reihe von Tools, darunter ein MCP-Server, eine Befehlszeile und Agenten-Skills, die KI-Agenten für die Programmierung Echtzeitzugriff auf Laufzeit-Debugging-Daten wie Konsolenlogs, Netzwerkverkehr, die Barrierefreiheitsstruktur und andere Entwicklertools-Funktionen bieten.
Das Team hat die Chrome-Entwicklertools für KI-Agenten als Plug-in in seinem KI-Agenten für die Programmierung, Claude Code, installiert:
# Add the marketplace registry
/plugin marketplace add ChromeDevTools/chrome-devtools-mcp

# Install the plugin (MCP server and skills)
/plugin install chrome-devtools-mcp@chrome-devtools-plugins
Das Team wollte, dass jeder Test in einer sauberen Browserinstanz ausgeführt wird, damit installierte Chrome-Erweiterungen die Ergebnisse nicht beeinflussen und keine personenbezogenen oder sensiblen Daten preisgegeben werden können. Fügen Sie dazu --isolated zum Array args in der MCP-Serverkonfiguration hinzu:
{
  "args": ["-y", "chrome-devtools-mcp@latest", "--isolated"]
}
Wenn für Ihre Tests stattdessen eine vorhandene angemeldete Browsersitzung erforderlich ist, verwenden Sie --autoConnect.
Schritt 3: Den KI-Agenten seine eigene Arbeit prüfen und korrigieren lassen
Das Engineering-Team listet die Prüfungen in den Anweisungen des Agenten auf, entweder als Prompt oder als Agenten-Skill. Auf übergeordneter Ebene führt der Agent Folgendes aus:
- Prüft den DOM-Baum und das berechnete CSS und vergleicht sie mit dem Figma-Design.
- Passt die Größe der Seite an mobile Darstellungsbereiche an, um die Reaktionsfähigkeit zu testen.
- Zeichnet Leistungs-Traces auf, um Long Animation Frames (LoAF) zu finden, die durch Scripts, Ressourcen, die das Rendering blockieren, und andere Leistungsprobleme verursacht werden.
- Schreibt Code um, um Designabweichungen, Leistungsprobleme und Konsolenausnahmen zu beheben, bevor ein Entwickler ihn überprüft.
In der folgenden Tabelle sehen Sie, welche Chrome-Entwicklertools für KI-Agenten die einzelnen Prüfungen unterstützen:
| Scheck | Tools |
|---|---|
| Reaktionsfähigkeit in verschiedenen Darstellungsbereichen testen | resize_page passt die Größe des Seitenfensters auf explizite Abmessungen an. emulate emuliert bestimmte Geräteumgebungen. take_screenshot erfasst das Ergebnis. |
| DOM und berechnetes CSS mit dem Figma-Design vergleichen | take_snapshot gibt einen Text-Snapshot der Seite basierend auf der Baumstruktur für Barrierefreiheit zurück. get_css_styles liest angewendete CSS-Regeln. evaluate_script führt eine JavaScript-Funktion auf der Seite aus. |
| LoAF, Ressourcen, die das Rendering blockieren, und Core Web Vitals-Probleme finden | click und drag emulieren Interaktionen. performance_start_trace und performance_stop_trace zeichnen einen Leistungstrace auf. performance_analyze_insight gibt detaillierte Diagnosen für die Statistiken im Trace zurück. list_network_requests und get_network_request zeigen die Netzwerkaktivität an. lighthouse_audit prüft nicht leistungsbezogene Bereiche wie SEO und Bedienungshilfen. |
Wenn der KI-Agent ein Problem findet, z. B. abgeschnittenen Text auf kleinen Bildschirmen, einen fehlerhaften Flex-Wrap oder ein nicht optimiertes Bild, das eine Layoutverschiebung verursacht, führt er eine kurze Korrekturschleife aus:
- Die Chrome-Entwicklertools für KI-Agenten erfassen den genauen Fehler.
- Der Agent analysiert die Daten und schreibt das problematische CSS oder JavaScript neu.
- Der Kundenservicemitarbeiter aktualisiert die Seite, um die Behebung des Problems zu bestätigen.
Auf einem Bildschirm hat der Agent die Seite gerendert und festgestellt, dass das Header-Layout, die Abstände und der Farbverlauf nicht dem Design entsprechen. Die relevanten .scss-Dateien wurden korrigiert. Außerdem wurde mit der Seite interagiert, z. B. durch das Erweitern von Akkordeons, um zu prüfen, ob ihr geöffneter Zustand den Designs entspricht.
Schritt 4: Übergeben Sie der Qualitätssicherung einen verifizierten Bericht
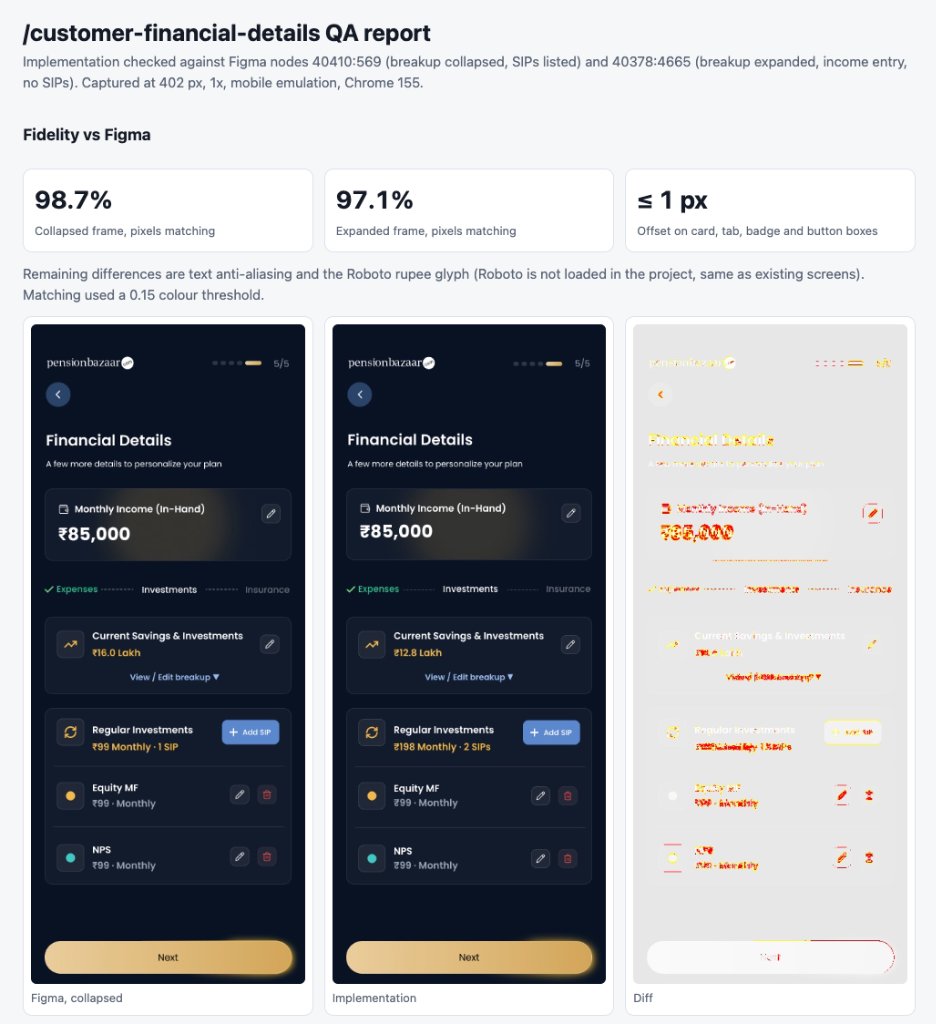
Nach Abschluss der Überprüfung liefert der Agent produktionsreifen Code zusammen mit einem Auditbericht für das QA-Team. Der Bericht enthält folgende Daten:
- Ein visueller Vergleich mit dem Figma-Design, der Pixelunterschiede hervorhebt, erstellt aus Screenshots, DOM-Snapshots und berechneten Stilen.
- Screenshots der gerenderten Seite bei verschiedenen Bildschirmgrößen.
- Core Web Vitals und Leistungsdiagnosen von
performance_start_traceundperformance_analyze_insight, z. B. Speed Index und Total Blocking Time (TBT). - Lighthouse-Ergebnisse für SEO, Best Practices und Barrierefreiheit im Internet von
lighthouse_audit. - Prüfungen für Interaktionen wie das Minimieren von Zeilen und Ein-/Aus-Schaltflächen sowie Konsolenfehler und Änderungen des Anwendungsstatus wie das Bearbeiten von Zeilen, das Löschen von Zeilen und leere Status werden bestanden oder nicht bestanden.
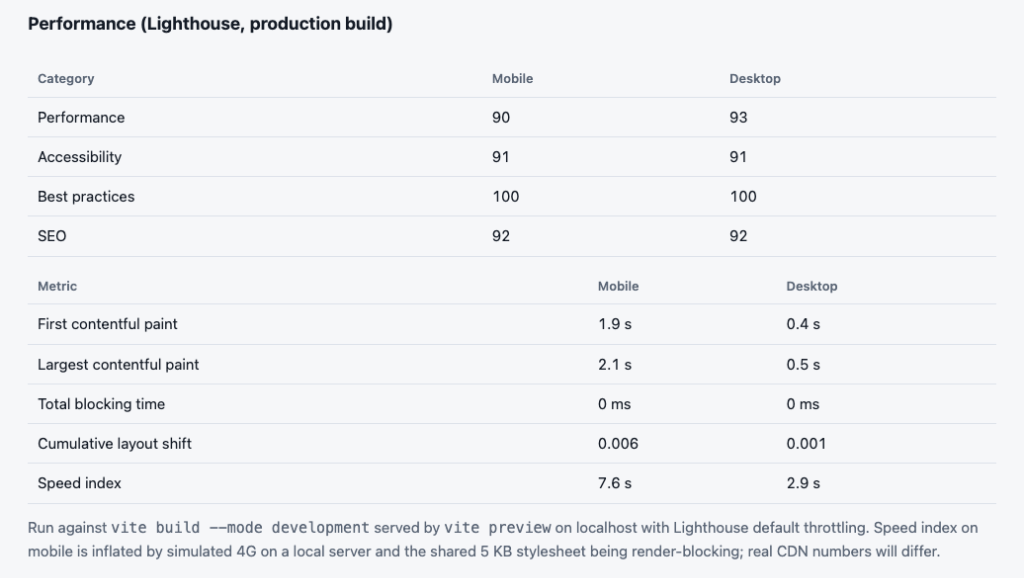
Diesen Ansatz auf 30 Kampagnenseiten anwenden
Auf der Hauptplattform wurden die manuellen PageSpeed Insights-Ausführungen durch Audits ersetzt, die über die Chrome-Entwicklertools für KI-Agenten in Kiro ausgeführt werden. Bevor eine Kampagnenseite live geht, löst ein Entwickler eine Prüfung der Staging-URL für Mobilgeräte und Computer aus. Der KI-Agent führt Leistungs- und Lighthouse-Audits durch. Die Chrome-Entwicklertools für KI-Agenten rufen automatisch Felddaten aus dem Chrome User Experience Report (CrUX) sowie Labordaten ab. Dadurch wurde der PageSpeed Insights-Schritt vollständig ersetzt.
Der Agent meldet dann die Leistungswerte, die gefundenen Engpässe und eine priorisierte Liste von Verbesserungen, die ein Entwickler beheben kann. In einer Vorabveröffentlichungsprüfung wurden nicht kritische API-Aufrufe gemeldet, die nacheinander während des Seitenaufbaus ausgelöst wurden und mit kritischen Rendering-Aufgaben konkurrierten. Das Team hat das Problem behoben, bevor die Seite live ging.
Der KI-Agent führt jetzt 12 Leistungsprüfungen in der Zeit durch, die ein Entwickler für eine benötigt. Das entspricht einer Reduzierung des manuellen Aufwands um 92 %.
Die Webleistung ist wichtig, um eine gute Nutzererfahrung zu bieten. Die manuelle Prüfung und Auswertung von Wasserfällen und Traces auf Dutzenden von Landingpages war jedoch mühsam und ein großer Engpass. Die Chrome-Entwicklertools für KI-Agenten haben diesen Prozess verändert und die Zeit, die unsere Entwickler für die Leistungsprüfung benötigen, um 92 % reduziert. So können sie sich auf komplexere Aufgaben konzentrieren.
Aman Soni, Engineering Manager, Policybazaar
Auswirkungen
Dank Modern Web Guidance und den Chrome-Entwicklertools für KI-Agenten wurde das Frontend-Testing bei Policybazaar und Pensionbazaar von einem manuellen, reaktiven Prozess zu einem automatisierten, proaktiven Prozess. In der folgenden Tabelle werden die Workflows vor und nach der Änderung verglichen:
| Region | Vorher: Manuelle Überprüfung und Basismodelle | Nachher: Modern Web Guidance und Chrome-Entwicklertools für KI-Agenten |
|---|---|---|
| Leistungsprüfung (Policybazaar) | Ein Entwickler führte PageSpeed Insights aus, überprüfte die Core Web Vitals und nahm für jede der etwa 30 Landingpages manuell Korrekturen vor. | 92 % weniger manueller Aufwand. Der Agent führt 12 Audits in der Zeit durch, die ein Entwickler für einen Audit benötigt. |
| Prüfung der Abdeckung (Policybazaar) | Die Abdeckung der Prüfung war bei den Kampagnenvarianten uneinheitlich. | 100 % Abdeckung der Leistungstests für Kampagnenseiten. |
| Neuer Bildschirm (Pensionbazaar) | Vom Code bis zum verifizierten Bildschirm dauert es nur wenige Tage. | Ein paar Stunden, mehr als 90 % schneller. |
| Fehler bei der Designparität (Pensionbazaar) | Abgeschnittene UI-Elemente und Layoutverschiebungen haben die manuelle Qualitätssicherung erreicht. | Es wurden über 90 % weniger UI-Fehler gemeldet. |
Die Reduzierung um 92 % übertraf das Ziel des Teams von mehr als 80 %. Landingpage-Regressionen werden erkannt, bevor sie die Staging- oder QA-Phase erreichen. Bei Pensionbazaar wird der Code bereits mit Screenshots für mehrere Darstellungsbereiche geprüft, was den Aufwand für Design, Entwicklung und Qualitätssicherung reduziert.
Wichtige Erkenntnisse für Ihr Team
- KI-Agenten mit verlässlichen Informationen verknüpfen Ausgewählte Anleitungen wie Modern Web Guidance halten Agenten von veralteten Mustern fern und sorgen dafür, dass Ihr Code innerhalb Ihrer Baseline-Ziele bleibt.
- Lassen Sie einen Agenten eine Frontend-Aufgabe erst dann als erledigt markieren, wenn er die gerenderte Seite geprüft hat. Mit den Chrome-Entwicklertools für KI-Agenten können KI-Agenten Layout, Darstellungsbereiche und Leistungs-Traces in einem echten Browser prüfen.
- Geben Sie der Schleife klare Abbruchkriterien. Legen Sie Schrittlimits und explizite Bedingungen für das Bestehen und Nichtbestehen fest, damit der Agent nicht in eine Schleife gerät und Tokens verschwendet.
- Beginnen Sie mit häufig aufgerufenen, vorlagenbasierten Seiten. Closed-Loop-Workflows lohnen sich am meisten, wenn es auf die Bearbeitungszeit ankommt.
- Führen Sie Audits in einem sauberen Browser aus. Verwenden Sie
--isolated, damit Erweiterungen und im Cache gespeicherte Daten die Ergebnisse nicht beeinflussen oder personenbezogene Daten preisgeben.