


Dipublikasikan: 12 November 2026
Minggu ini, kami meluncurkan Modern Web Guidance 1.0, sebuah kemampuan open source yang membantu agen coding menggunakan fitur platform web modern, bukan solusi lama. Postingan ini membahas mesin telusur lokal yang menemukan panduan paling relevan untuk tugas Anda, tanpa membuang-buang token.
Jika Anda memberi tahu engineer bahwa Anda telah membuat pusat informasi dengan teks Markdown sebesar 1,7 MB untuk agen coding mereka, mereka akan mengajukan dua pertanyaan:
- "Berapa banyak token yang akan dimasukkan ke dalam jendela konteks saya?"
- "Jenis database vektor yang membengkak seperti apa yang diperlukan?"
Selama enam bulan terakhir, kami telah membangun ulang mesin pengambilan lokal kami sebanyak tiga kali. Kami beralih dari binding C++ sebesar 507 MB, lalu turun menjadi 23 MB JavaScript murni menggunakan TensorFlow.js, dan kemudian turun menjadi paket 7 MB dengan embedding kueri berupa loop for sepanjang 7 baris, semuanya sambil meningkatkan akurasi.
RAG agentic dan pengungkapan progresif
Memasukkan 1,7 MB teks Markdown yang berisi lebih dari 200 panduan HTML/CSS/Web API ke dalam AGENTS.md tidaklah praktis. Kami percaya pada pengungkapan progresif, tetapi tahu bahwa indeks Markdown akan berhenti efisien dalam penggunaan token pada skala besar.
Untuk mengatasinya, kita menggunakan RAG agentic yang didukung oleh CLI penelusuran:
- Saat tidak aktif, agen hanya melihat deskripsi keahlian (~205 token). Deskripsi ini mengikuti panduan pemicu keahlian Anthropic sehingga agen memanggil keahlian pada tugas frontend yang relevan.
- Pada tugas frontend, agen dapat menggunakan CLI untuk menelusuri:
modern-web-guidance search "animate height auto", mendapatkan 10 kecocokan yang relevan (~530 token). - Agen menjalankan
modern-web-guidance retrieve animate-to-intrinsic-sizesuntuk mengambil seluruh panduan (sekitar 800 token). Panduan ini kini dilengkapi dengan praktik terbaik penerapan untuk kompatibilitas, penggantian, dan teknik.
Mengapa menggunakan keterampilan CLI, bukan server MCP atau penelusuran web?
- Alat MCP memboroskan token atau memiliki mekanisme pemicu yang tidak dapat diandalkan (karena penemuan alat yang dinamis). Deskripsi keahlian kami dioptimalkan untuk efektivitas dan memungkinkan agen menggunakan panduan hanya jika diperlukan.
- Penelusuran web bawaan menampilkan jawaban Stack Overflow dan dokumen referensi tahun 2015, bukan pola implementasi
DO/DO NOTyang terbaru dan diseleksi. Proses ini juga memerlukan waktu beberapa detik melalui jaringan dan gagal di sandbox offline, sedangkan CLI lokal berjalan di CPU dalam milidetik.
Gen 1: Prototipe C++ 507 MB
Versi pertama Modern Web Guidance menggunakan stack RAG lokal: LanceDB, Apache Arrow, dan Transformers.js dengan onnxruntime-native.
Alat ini berfungsi dengan baik di mesin pengembangan, tetapi kurang cocok untuk keahlian agen:
- Saat Anda menambahkan skill ke project (atau agen memanggilnya dengan
npx), Anda tidak perlu menunggunpm installmendownload biner.nodeyang bergantung pada arsitektur atau kompilasi C++node-gypyang secara rutin gagal di sandbox cloud. - Direktori
node_modulesyang diekstrak berukuran 507 MB.
Gen 2: Memperkecil TensorFlow.js hingga 23 MB
Kami ingin kompilasi native nol dan eksekusi instan di mana pun Node berjalan. Jadi pada bulan April, kami mengganti stack native dengan mesin CPU JavaScript murni yang menjalankan all-MiniLM-L6-v2 di @tensorflow/tfjs:
- Menghapus
onnxruntime-nodedi esbuild dan mengganti tokenizer Hugging Face dengan tokenizer WordPiece BERT dalam hierarki yang kecil (0 ketidakcocokan ID token). - Setelah menjelajahi peta sumber, pangkas 400+ modul
@tensorflow/tfjs-backend-cpumenjadi 26 kernel yang benar-benar digunakan MiniLM, sehingga memperkecil mesin JS dari 6 MB menjadi 830 KB. - Menghapus LanceDB untuk vektor yang di-gzip pada waktu build dan pemindaian perkalian titik
<1 msdalam memori di sekitar 200 panduan. - Tempatkan embedder di balik panggilan
import()agarretrievedanlistselesai dalam waktu kurang dari sepuluh milidetik.
Hal ini mengurangi ukuran paket npm menjadi 23 MB tanpa dependensi runtime. Kami meluncurkannya, dan agen menjalankan sekitar 750.000 penelusuran terhadapnya.
Tempat MiniLM rusak dalam produksi
Beberapa bulan kemudian, kami melihat lintasan tempat agen telah menginstal keterampilan, tetapi masih menulis kode lama.
Dalam satu operasi Codex, seorang developer meminta perintah konfirmasi penghapusan. Kami memiliki panduan lengkap tentang cara membuat modal konfirmasi yang mudah diakses dengan HTML <dialog closedby="any">.
Agen melakukan hal yang benar dan menelusuri:
npx modern-web-guidance@latest search "confirm destructive action"
CLI menampilkan []. Jadi, agen mengangkat bahu dan menulis window.confirm().
Mengapa hasilnya kosong? Saat kami mempelajari log dan embedding, dua kesenjangan pengambilan terlihat jelas:
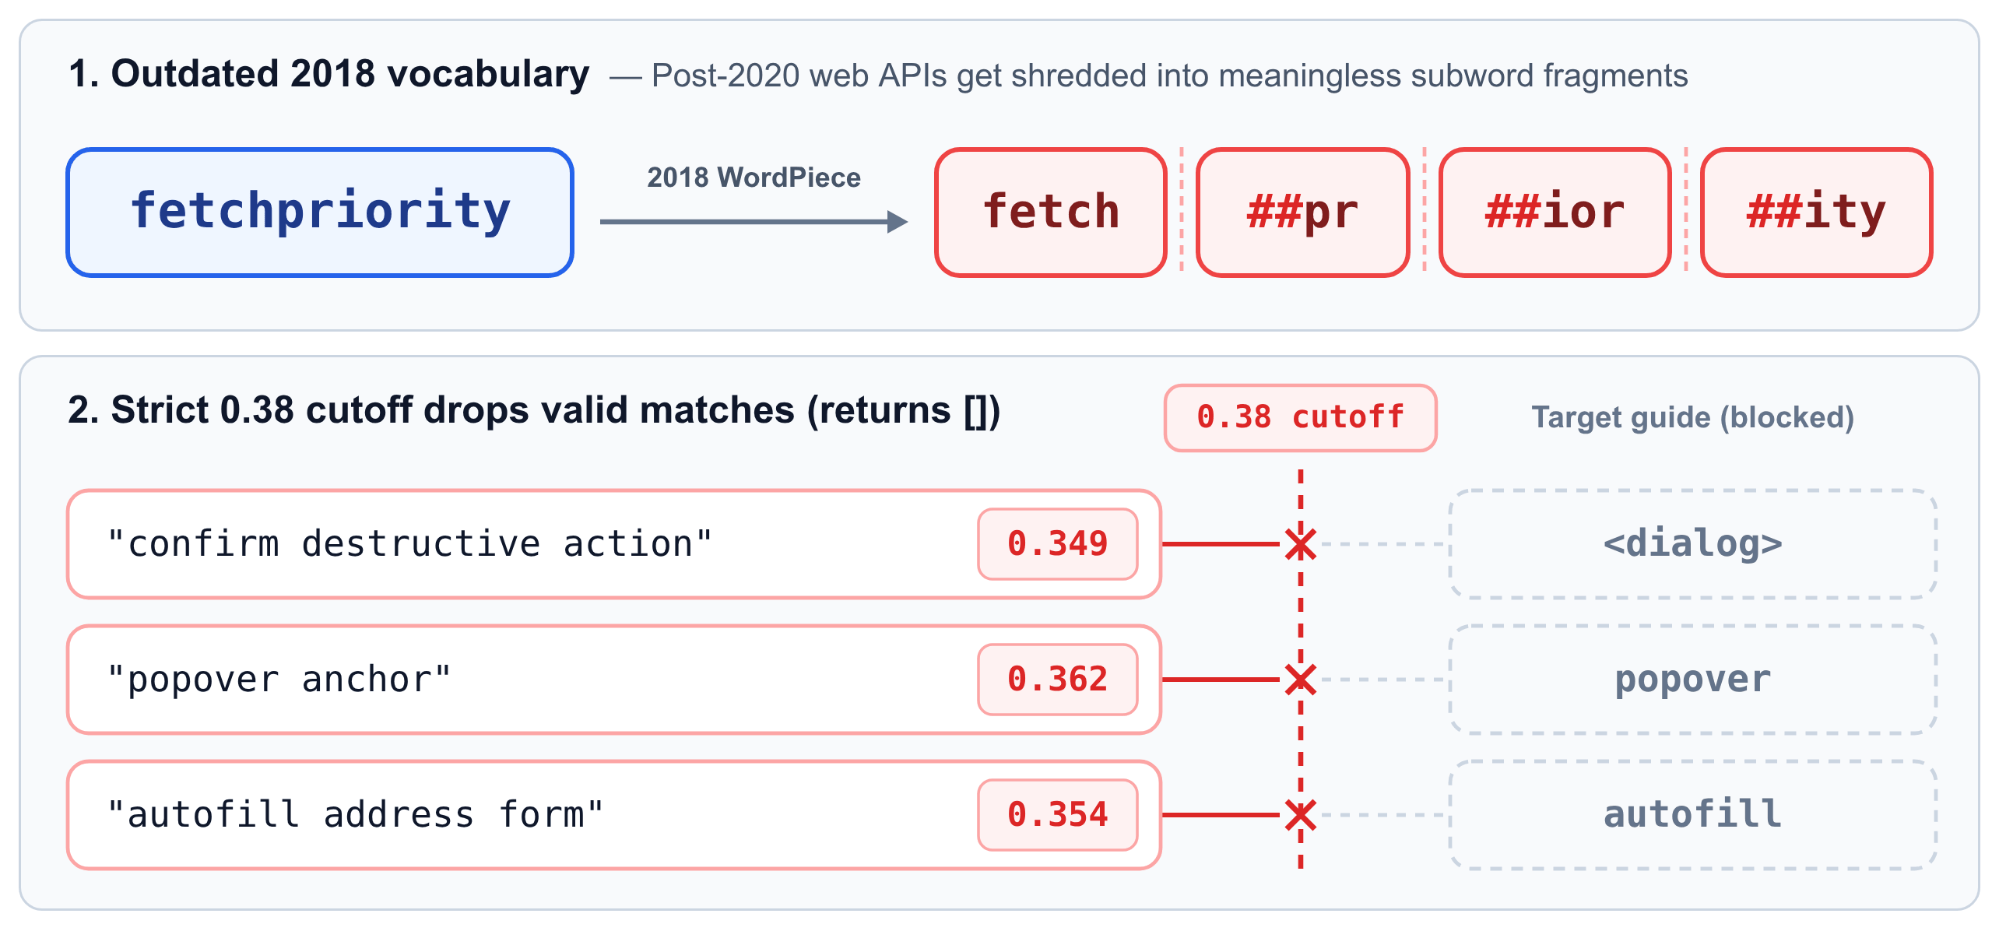
all-MiniLM-L6-v2dilatih sekitar tahun 2018–2020, sehingga kosakata WordPiece-nya benar-benar tidak mengetahui keberadaan Web API pasca-2020. Saat agen menelusurifetchpriority,popover, ataustartViewTransition, tokenizer 2018 memecahfetchprioritymenjadi empat subkata yang tidak bermakna:fetch·##pr·##ior·##ity.- Untuk mencegah kueri di luar cakupan menampilkan panduan acak, PR sebelumnya telah menambahkan batas kesamaan kosinus
0.38yang ketat. Karena MiniLM tidak dapat menjembatani frasa 3 kata"confirm destructive action"ke"dialog"di atas0.38(skor0.349, sedangkan"popover anchor"mendapatkan0.362dan"autofill address form"mendapatkan0.354), gerbang membuang kecocokan yang valid. Parahnya, setiap kalisearchmenampilkan[], petunjuk kemampuan kami memberi tahu agen untuk beralih kemodern-web-guidance list, sehingga membuang sekitar 200 deskripsi panduan (~1.500 token terbuang) ke dalam konteks.
Memperbaiki pengambilan: telemetri nyata, penelusuran hybrid, dan menampilkan 10 hasil
Tolok ukur awal kami adalah 850 kueri sintetis yang dihasilkan dari panduan itu sendiri, yang terlalu mirip dengan frasa panduan sehingga tidak dapat mendeteksi kegagalan ini. Oleh karena itu, kami membangun harness evaluasi baru (pnpm benchmark:rag) yang mencakup sekitar 4.000 penelusuran langsung yang diambil dari telemetri CLI yang tidak diaktifkan (yang hanya mencatat argumen search agen sepanjang 2–5 kata, tidak pernah mencatat perintah pengguna atau kode repositori, dan mematuhi DISABLE_TELEMETRY=1) ditambah 1.029 penelusuran yang diambil dari evaluasi agen harian di Claude Code, Codex CLI, dan Gemini CLI.
Memutar ulang histori git kami terhadap kueri yang ditahan tersebut menunjukkan bahwa batas 0.38 telah meningkatkan respons [] kosong sebesar 8x. Dengan adanya tolok ukur, kami melakukan dua peningkatan cepat sebelum menyentuh model embedding:
- Penelusuran kata kunci + semantik hybrid: Vektor padat mengaburkan nama API yang tepat (
:user-invalid,showModal,details-name), sedangkan penelusuran kata kunci melewatkan kueri intent saat agen tidak mengetahui nama API. Kami menambahkan indeks kata kunci BM25 (yang tahu, tahu) tanpa dependensi dengan stemming jamak, mengindeksweb-feature-idssetiap panduan, dan menggabungkan BM25 dengan peringkat semantik. Sekarangsearchhanya menampilkan[]jika kesamaan semantik adalah<0.30dan BM25 memiliki nol hit kata kunci. - 10 hasil ringkas, bukan 5 hasil panjang: Petunjuk keterampilan sudah memberi tahu agen untuk mengabaikan
similaritydantokenCount. Dengan menghapus kolom yang tidak digunakan tersebut, kita dapat memasukkan 10 hasil{id, description}ringkas ke dalam anggaran ~530 token yang sama persis dengan 5 hasil panjang:
// Before: 5 verbose results (~105 tokens each = ~525 tokens)
{
  "id": "dialog",
  "category": "html",
  "description": "Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby.",
  "featuresUsed": ["dialog", "dialog-closedby"],
  "tokenCount": 780,
  "similarity": 0.49
}
// After: 10 compact results (~53 tokens each = ~530 tokens)
{"id":"dialog","description":"Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby."}
Bersama-sama, kedua perubahan ini meningkatkan rasio hit penelusuran kami pada kueri telemetri yang ditahan dari 80,6% menjadi 94,7%, yang diukur sebagai Hit@K (apakah panduan yang diharapkan muncul di hasil K teratas).
Gen 3: Embedding yang telah dipersiapkan dan loop for 7 baris
Bahkan dengan rasio hit 94.7%, telemetri kami menunjukkan ketidakcocokan yang mencolok: 86,7% penelusuran agen langsung hanya terdiri dari 2 hingga 5 kata (median: 3 kata). Setiap kali agen menelusuri frasa 3 kata, Node akan mem-booting TensorFlow.js, mengurai jaringan neural 22,6 MB, dan menghabiskan latensi cold-start 770 md dan RAM puncak 346 MB.
Saat ditanya apakah ada cara yang lebih ringan untuk menyematkan kueri 3 kata tanpa jaringan neural, agen Antigravity kami memberikan serangkaian teknik distilasi ML yang tidak umum: Model2Vec, Tokenlearn, dimensi Matryoshka, Adagrad. (Jika Anda ingin mengetahui detail teknisnya, ada informasi selengkapnya di halaman kualitas penelusuran kami.)
RAG lokal standar memaksa dokumen dan kueri melalui model kecil yang sama di CPU pengguna. Namun, sekitar 200 panduan kami tidak berubah setelah kami merilis npm, jadi tidak ada alasan untuk menyematkannya dengan model kecil tahun 2018. Sebagai gantinya, embed-guide-chunks.ts melakukan pra-bake semua vektor panduan kami pada waktu rilis di cloud menggunakan gemini-embedding-001 dan mengirimkannya sebagai vektor Int8 256 dimensi biner (guide-chunks.i8, 335 KB di-gzip).
Bagaimana project CLI offline tanpa kunci API memproyeksikan kueri live pengguna ke ruang vektor Gemini yang sama persis? Karena kueri agen hampir selalu terdiri dari 2 hingga 5 kata, kita tidak memerlukan transformer saat runtime. Kita hanya memerlukan tabel pencarian vektor untuk kata-kata yang diketahui (table) dan cara cerdas untuk menjumlahkannya. Saat runtime, seluruh pipeline TensorFlow.js sebesar 23 MB disederhanakan menjadi loop for sepanjang 7 baris di static-embedder.ts:
// Each word's weight and Int8 scale are pre-folded into `scales[i]`
for (const [i, f] of enc) {
  const wt = scales[i] * f;
  const offset = i * 256;
  for (let k = 0; k < 256; k++) {
    out[k] += wt * table[offset + k];
  }
}
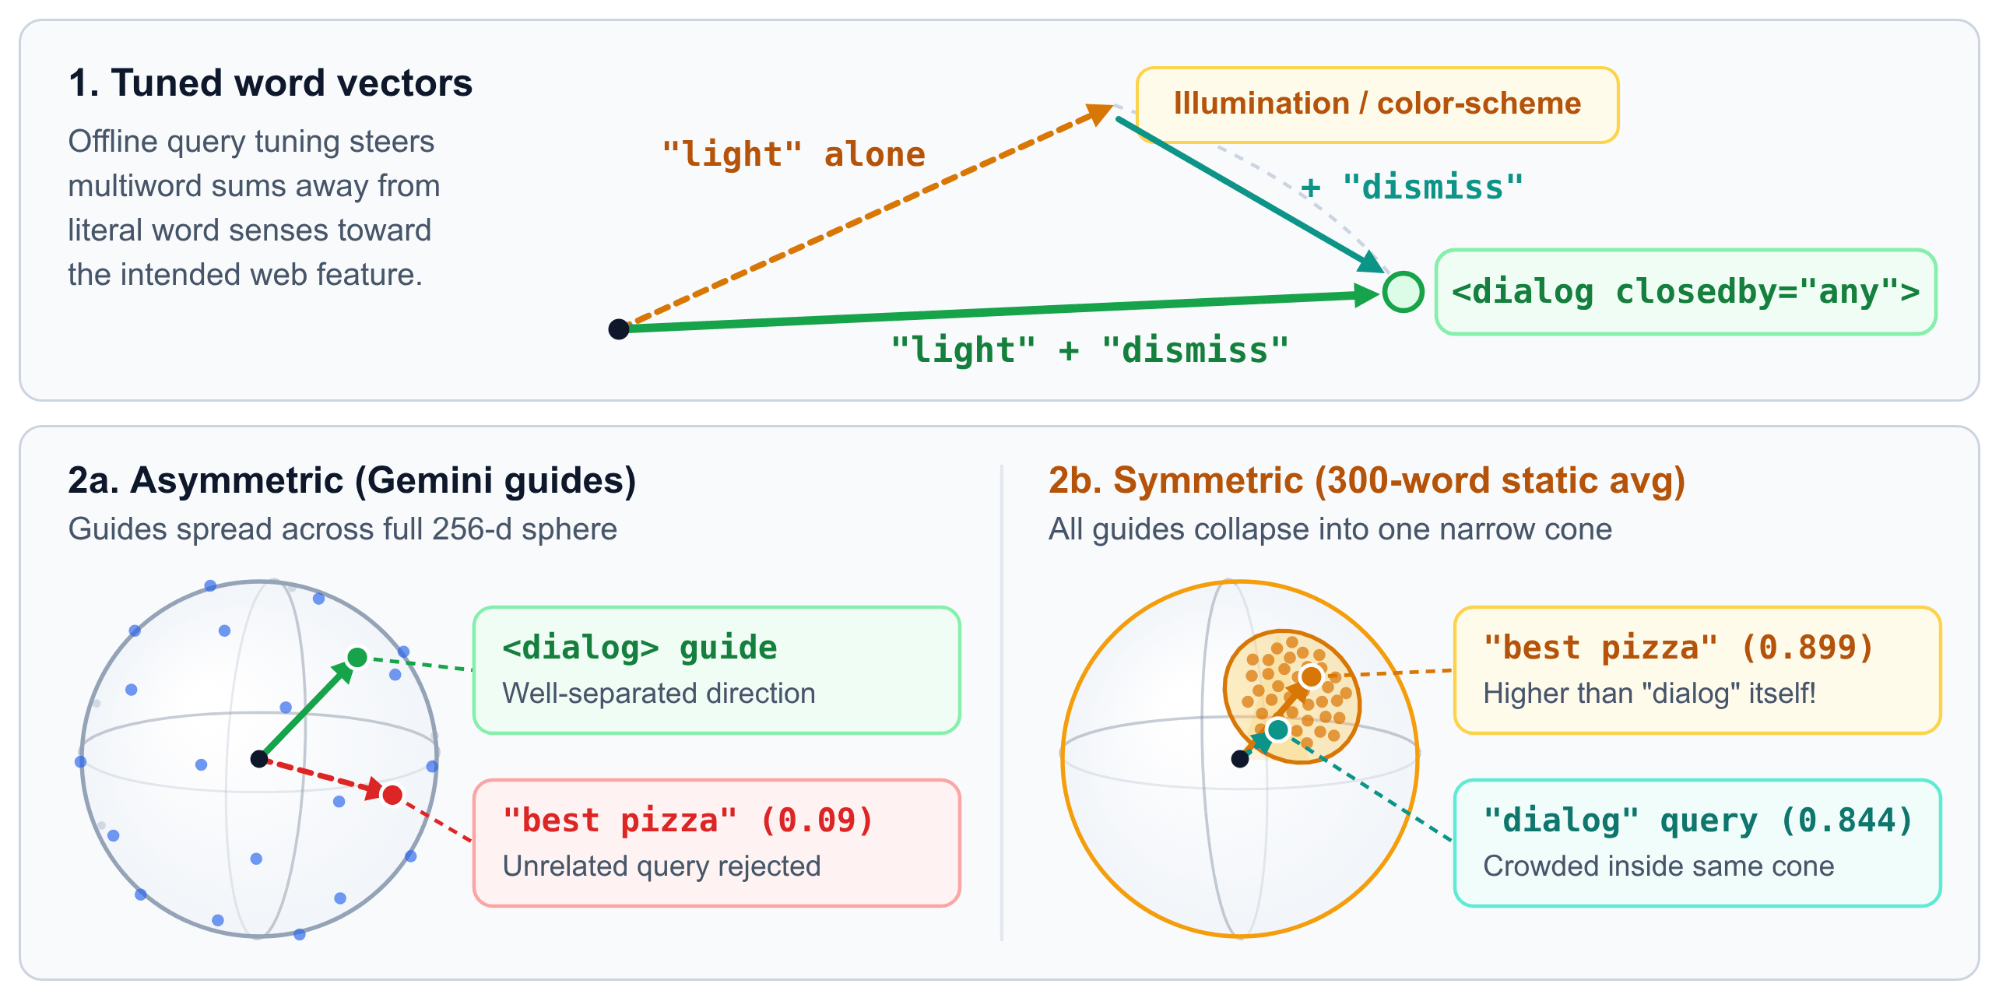
Untuk membuat tabel pencarian tersebut (train-query-words.ts), kami mengambil kosakata yang berisi 29.165 kata (dengan istilah web modern seperti fetchpriority, light-dismiss, popover, dan scrollytelling sebagai kata utuh yang berdiri sendiri), menyematkannya dengan gemini-embedding-001, dan menyesuaikan vektor kata secara offline terhadap 33.000 kueri web sungguhan sehingga kombinasi multi-kata berada di tempat yang tepat (misalnya, "light" + "dismiss" mengarah ke <dialog closedby="any">, bukan pencahayaan atau skema warna). Dikompresi menjadi Int8 (query-words.i8), seluruh tabel pemeta di-gzip 5.3 MB.
Mengapa tidak menggunakan tabel pencarian statis tersebut untuk menyematkan panduan juga, dan melewati langkah build cloud? Kami mencobanya terlebih dahulu dan gagal pada paragraf lengkap: menjumlahkan 3 kata kueri tetap tajam, tetapi merata-ratakan ratusan kata di seluruh panduan lengkap akan menciutkan setiap panduan menjadi kerucut sempit di dekat rata-rata bahasa Inggris umum (hingga "best pizza in new york" mencetak skor kesamaan kosinus 0.899 terhadap panduan dialog kami, lebih tinggi daripada kueri "dialog" itu sendiri di 0.844!). Memasangkan pencarian kueri statis 3 kata (query-words.i8) dengan embedding panduan Gemini model lengkap (guide-chunks.i8) memberi kami akurasi tingkat cloud sementara kueri masih berjalan offline dalam 30 µs.
Papan skor di ketiga generasi
Di seluruh pencapaian rilis kami, Hit@K meningkat dari 78,2% dengan embedding seluruh dokumen menjadi 95,4% dengan embedder Int8 statis (dibandingkan dengan 96,9% dengan API gemini-embedding-001 cloud):
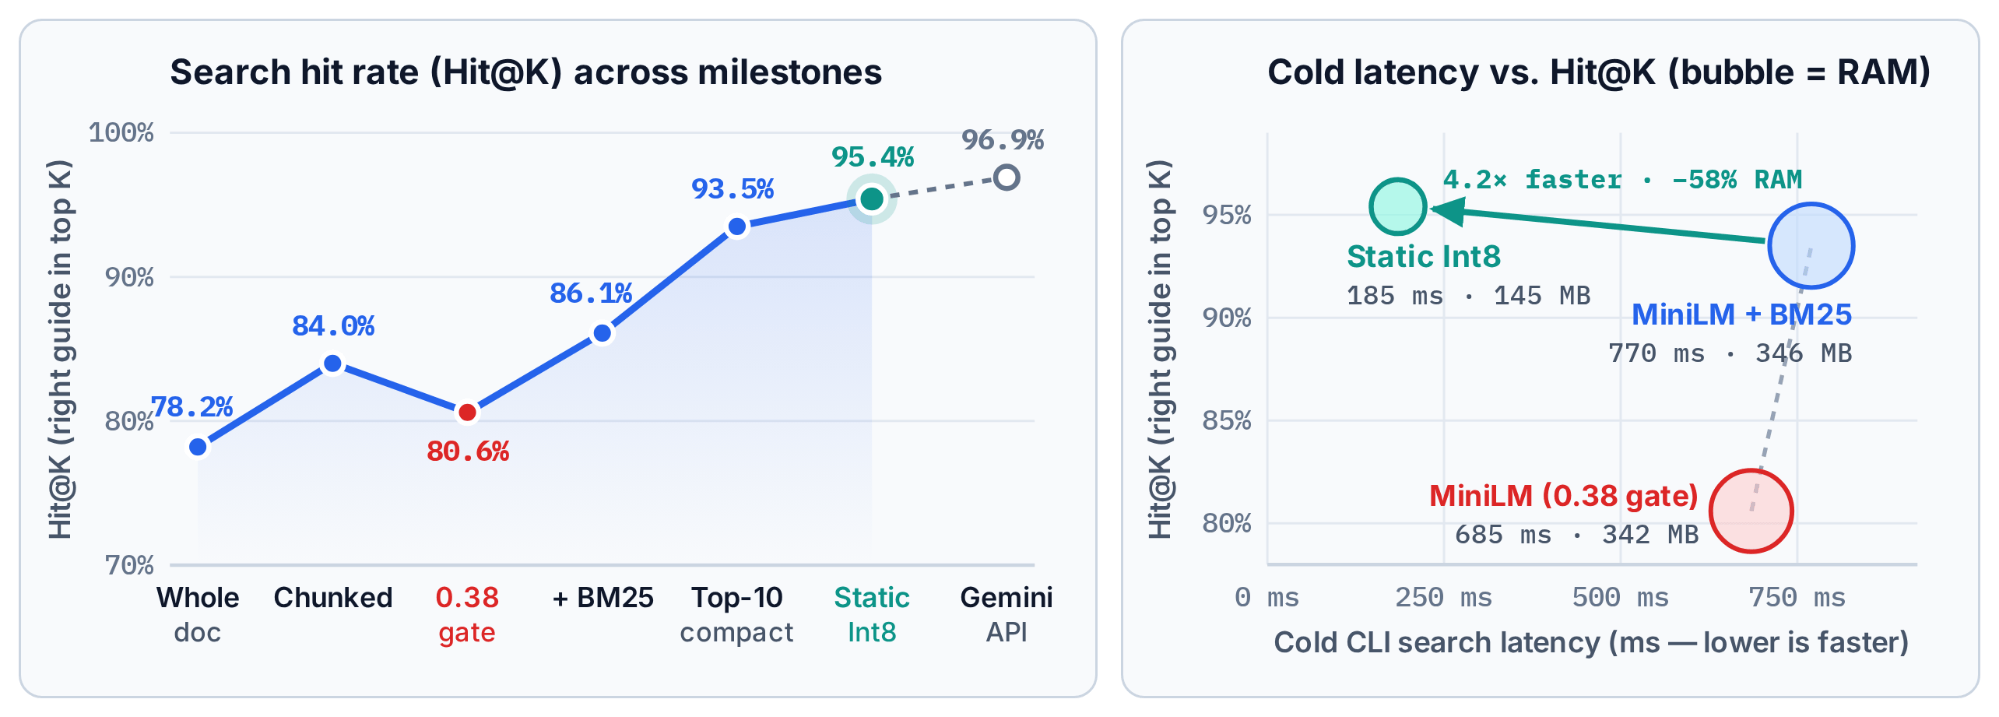
Berikut perbandingan ketiga generasi setelah menerapkan penyemat statis:
Dan jika Anda menjalankan kueri Codex yang rusak dari sebelumnya:
npx modern-web-guidance@latest search "confirm destructive action"
Panduan dialog akan kembali ke bagian atas daftar.
(Anda dapat mempelajari diagram interaktif di semua pencapaian, panjang kueri, dan horizon K di Dasbor Kualitas Penelusuran kami.)
Kode itu murah; pengukuran adalah pekerjaan yang sebenarnya
Agen dapat menulis skrip penyulingan vektor kata atau pemberi peringkat BM25 dalam hitungan menit. Membuat implementasi kandidat tidak lagi menjadi hambatan. Mengetahui apakah suatu perubahan benar-benar membantu (atau secara diam-diam merusak 9% penelusuran produksi seperti yang dilakukan gerbang 0.38 kami) adalah hampir seluruh tugasnya.
Berikut cara kami menangani sistem ini:
- Tentukan sasaran utama dan investasikan dalam harness pengukuran, bukan dalam satu penerapan. Kami menghabiskan lebih banyak waktu untuk membangun
pnpm benchmark:rag, mengumpulkan 5.000 kueri nyata, dan mengkalibrasi penilaian otomatis kami terhadap rating manusia daripada menulis retriever apa pun. - Buat rubrik untuk cara Anda dan agen Anda menilai kualitas, dan perkirakan rubrik tersebut akan berkembang setelah diterapkan pada data dunia nyata. Orang-orang menyebutnya "pengukuran terlebih dahulu", yang hanya separuh benar: Anda dapat menulis pemeriksaan jawaban dasar yang diketahui pada hari pertama, tetapi Anda tidak dapat merancang rubrik yang baik dalam ruang hampa sebelum memeriksa kegagalan yang sebenarnya (Shankar dkk. menyebutnya pergeseran kriteria dalam Who Validates the Validators?). Melihat agen memicu penggantian
list1.500 token adalah hal yang memaksa kami untuk menghukum pembengkakan token bersama dengan recall. - Dengan pengukuran tepercaya, bereksperimenlah secara agresif dengan berbagai implementasi dan biarkan papan skor menyelesaikan perdebatan arsitektur. Setelah benchmark menilai 5.000 kueri dalam hitungan detik, Anda tidak perlu berdebat dalam PR tentang apakah loop
Int87 baris dapat mengalahkan transformer 23 MB. Coba lima pendekatan dalam satu sore dan pertahankan yang terbaik.
Tentu saja, semua kode (termasuk embedder, distiller, dan harness benchmark) bersifat open source.