


Gepubliceerd: 12 november 2026
Deze week hebben we Modern Web Guidance 1.0 gelanceerd, een open-source vaardigheid die programmeer-agents helpt moderne webplatformfuncties te gebruiken in plaats van verouderde tijdelijke oplossingen. In deze post kijken we naar de lokale zoekmachine die de meest relevante gids voor je taak vindt, zonder je tokens te verspillen.
Als je een engineer vertelt dat je een kennisdatabase hebt gemaakt met 1,7 MB aan Markdown-tekst voor hun programmeeragent, stelt die 2 vragen:
- "Hoeveel tokens worden er in mijn contextvenster gedumpt?"
- "What kind of bloated vector database does it require?"
In de afgelopen 6 maanden hebben we onze lokale ophaalengine 3 keer opnieuw opgebouwd. We gingen van 507 MB aan C++-bindingen naar 23 MB aan pure JavaScript met TensorFlow.js en daarna naar een pakket van 7 MB waarin query-insluiting een for-lus van 7 regels is. En dat alles terwijl de nauwkeurigheid verbeterde.
Agentic RAG en progressieve onthulling
Het is niet praktisch om 1,7 MB aan Markdown-tekst met meer dan 200 HTML-/CSS-/Web API-handleidingen in AGENTS.md te dumpen. We geloven in progressieve openbaarmaking, maar weten dat een Markdown-index op schaal niet meer tokenefficiënt is.
Om dit op te lossen, gebruiken we agentic RAG, ondersteund door een zoek-CLI:
- In rust ziet de agent alleen de beschrijving van de vaardigheid (~205 tokens). De beschrijving volgt de richtlijnen voor vaardigheidstriggers van Anthropic, zodat de agent de vaardigheid aanroept voor relevante frontend-taken.
- Voor frontendtaken kan de agent de CLI gebruiken om te zoeken:
modern-web-guidance search "animate height auto", wat 10 relevante overeenkomsten oplevert (~530 tokens). - De agent voert
modern-web-guidance retrieve animate-to-intrinsic-sizesuit om de hele gids op te halen (ongeveer 800 tokens). De functie is nu uitgerust met de best practices voor implementatie voor compatibiliteit, fallbacks en techniek.
Waarom een CLI-vaardigheid in plaats van een MCP-server of een online zoekopdracht?
- MCP-tools verspillen tokens of hebben onbetrouwbare triggermechanismen (vanwege dynamische toolontdekking). De beschrijving van onze vaardigheid is geoptimaliseerd voor effectiviteit en zorgt dat de agent alleen richtlijnen gebruikt wanneer dat nodig is.
- De ingebouwde zoekfunctie op internet toont Stack Overflow-antwoorden en referentiedocumenten uit 2015 in plaats van up-to-date, beheerde implementatiepatronen voor
DO/DO NOT. Het duurt ook seconden via het netwerk en mislukt in offline sandboxes, terwijl de lokale CLI in milliseconden op de CPU wordt uitgevoerd.
1e generatie: het C++-prototype van 507 MB
De eerste versie van Modern Web Guidance gebruikte een lokale RAG-stack: LanceDB, Apache Arrow en Transformers.js met onnxruntime-native.
Het werkte prima op een computer voor ontwikkeling, maar het was niet echt geschikt voor een agentvaardigheid:
- Als je een vaardigheid aan een project toevoegt (of een agent deze aanroept met
npx), verwacht je niet dat je moet wachten op eennpm installdie architectuurafhankelijke.nodebinaire bestanden downloadt ofnode-gypC++-compilatie die routinematig mislukt in cloud-sandboxes. - De uitgepakte
node_modules-directory was 507 MB.
2e generatie: TensorFlow.js verkleinen tot 23 MB
We wilden geen native compilatie en onmiddellijke uitvoering overal waar Node wordt uitgevoerd. In april hebben we de native stack vervangen door een pure JavaScript CPU-engine die all-MiniLM-L6-v2 uitvoert op @tensorflow/tfjs:
onnxruntime-nodein esbuild is vervangen door een shim en de Hugging Face-tokenizer is vervangen door een kleine in-tree BERT WordPiece-tokenizer (0 token-ID-mismatches).- Na wat verkenning van de bronkaarten hebben we de 400+ modules van
@tensorflow/tfjs-backend-cpugesnoeid tot de 26 kernels die MiniLM daadwerkelijk gebruikt. Zo hebben we de JS-engine verkleind van 6 MB naar 830 KB. - LanceDB is vervangen door gzipped vectoren tijdens de build en een in-memory
<1 msinwendig product-scan voor alle ongeveer 200 gidsen. - Plaats de insluiter achter een
import()-aanroep, zodatretrieveenlistin minder dan 10 milliseconden worden afgerond.
Zo werd het npm-pakket verkleind tot 23 MB zonder runtime-afhankelijkheden. We hebben de tool gelanceerd en medewerkers hebben er ongeveer 750.000 zoekopdrachten mee uitgevoerd.
Waar MiniLM is verbroken in productie
Na een paar maanden hebben we gekeken naar trajecten waarin agents de vaardigheid hadden geïnstalleerd, maar nog steeds verouderde code schreven.
In één Codex-uitvoering vroeg een ontwikkelaar om een bevestigingsprompt voor verwijderen. We hebben een hele gids over het maken van toegankelijke bevestigingsmodals met HTML <dialog closedby="any">.
De medewerker deed het juiste en zocht naar:
npx modern-web-guidance@latest search "confirm destructive action"
De CLI heeft [] geretourneerd. De agent haalde zijn schouders op en schreef window.confirm() op.
Waarom is het resultaat leeg? Toen we de logboeken en embeddings onderzochten, vielen ons 2 hiaten in de ophaalresultaten op:
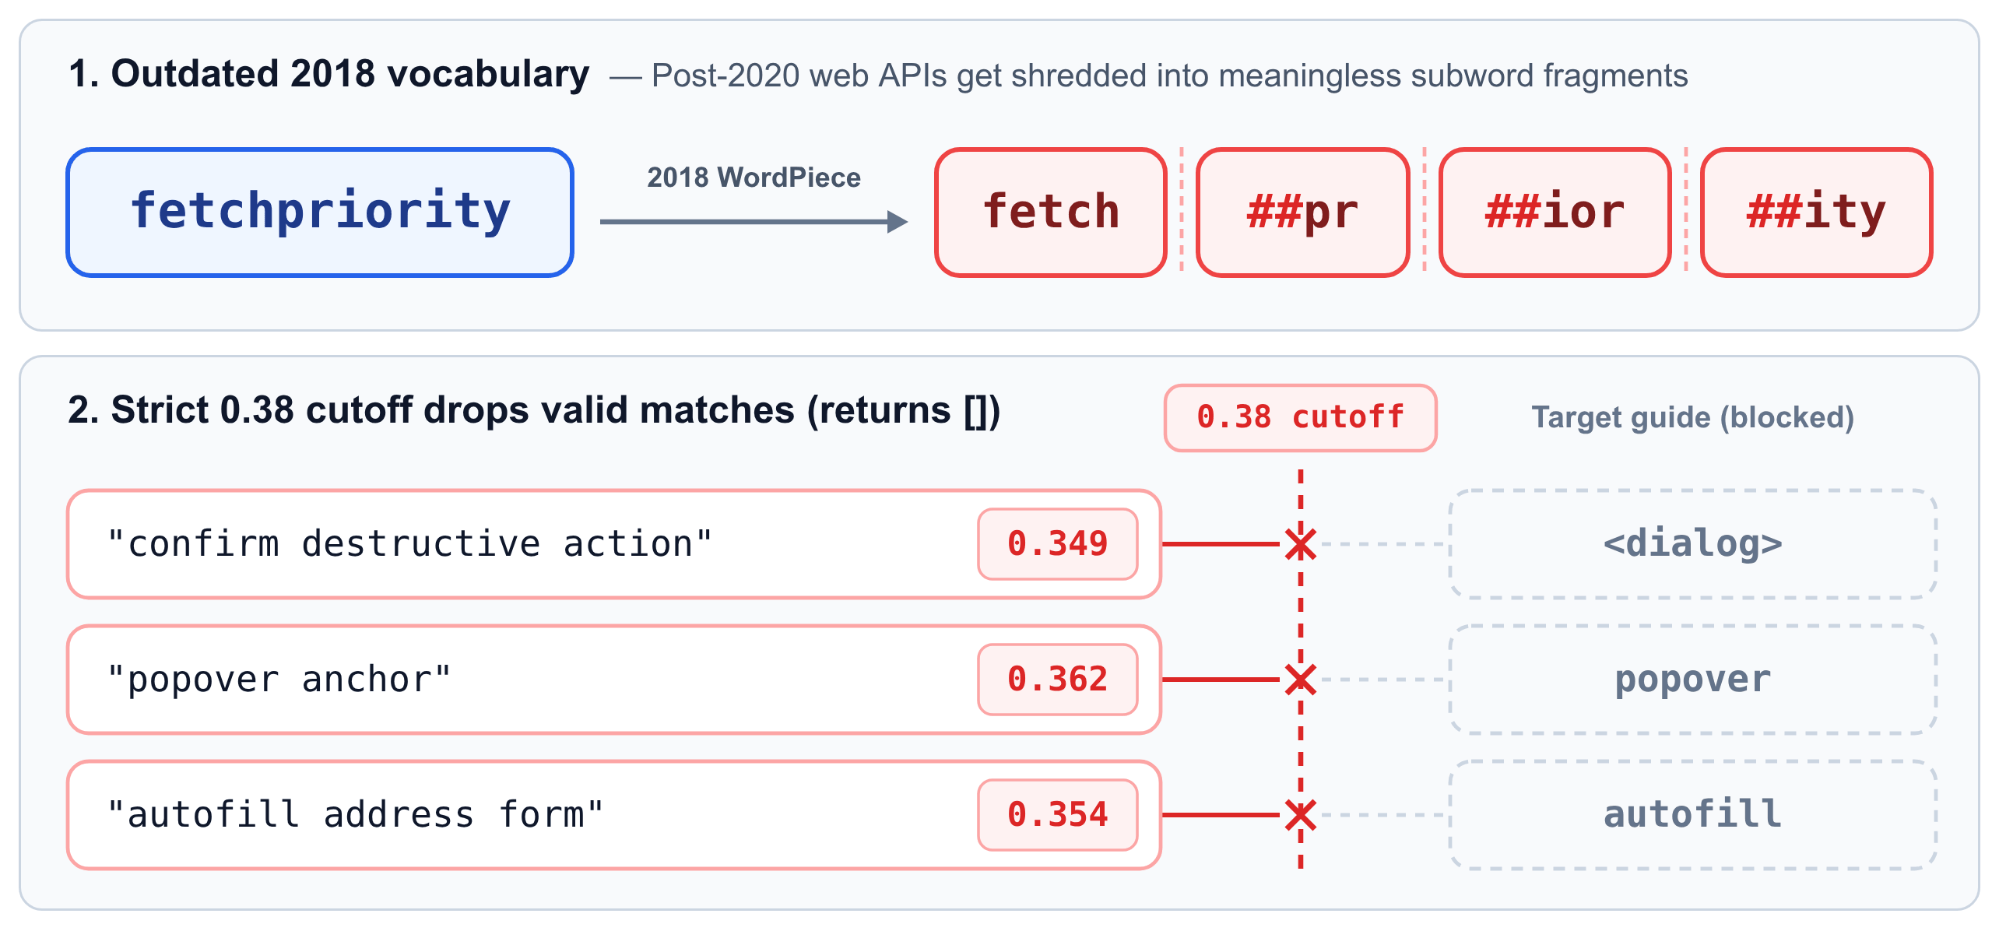
all-MiniLM-L6-v2is getraind rond 2018-2020, dus de WordPiece-vocabulaire weet letterlijk niet dat er web-API's van na 2020 bestaan. Als een agent zoekt naarfetchpriority,popoverofstartViewTransition, splitst de tokenizer uit 2018fetchpriorityop in 4 betekenisloze subwoorden:fetch·##pr·##ior·##ity.- Om te voorkomen dat zoekopdrachten buiten het bereik willekeurige gidsen retourneren, had een eerdere PR een strikte
0.38cosinus-overeenkomstafkap toegevoegd. Omdat MiniLM de woordgroep van 3 woorden"confirm destructive action"niet kon overbruggen naar"dialog"boven0.38(score0.349, terwijl"popover anchor"0.362kreeg en"autofill address form"0.354kreeg), heeft de poort geldige overeenkomsten weggegooid. Erger nog, wanneersearch[]retourneerde, gaven onze vaardigheidsinstructies de agent de opdracht om terug te vallen opmodern-web-guidance list, waardoor alle ~200 gidsbeschrijvingen (~1500 verspilde tokens) in de context werden gedumpt.
Ophalen herstellen: echte telemetrie, hybride zoekopdrachten en 10 resultaten retourneren
Onze oorspronkelijke benchmark was 850 synthetische zoekopdrachten die op basis van de gidsen zelf waren gegenereerd. Deze kwamen te veel overeen met de bewoordingen in de gidsen om deze fouten op te sporen. Daarom hebben we een nieuwe evaluatieharnas (pnpm benchmark:rag) gebouwd rond 4000 live zoekopdrachten die zijn gesampled uit afgemelde CLI-telemetrie (die alleen het argument van 2-5 woorden van de agent search registreert, nooit prompts van gebruikers of repositorycode, en DISABLE_TELEMETRY=1 respecteert) plus 1029 zoekopdrachten die zijn gemined uit nachtelijke agentevaluaties in Claude Code, Codex CLI en Gemini CLI.
Toen we onze git-geschiedenis opnieuw afspeelden voor die achtergehouden zoekopdrachten, bleek dat de drempelwaarde van 0.38 het aantal lege []-reacties met 8x had verhoogd. Met de benchmark op zijn plaats, hebben we 2 snelle verbeteringen doorgevoerd voordat we het embeddingmodel aanpasten:
- Hybride zoekwoord + semantisch zoeken: Dichte vectoren vervagen exacte API-namen (
:user-invalid,showModal,details-name), terwijl zoekwoordzoekopdrachten intentiequery's missen als de agent de API-naam niet kent. We hebben een zoekwoordindex van BM25 (als je het weet, weet je het) zonder afhankelijkheden toegevoegd met meervoudsstammen, deweb-feature-idsvan elke gids geïndexeerd en BM25 samengevoegd met semantische rangschikking.searchretourneert nu alleen[]als de semantische overeenkomst<0.30is en BM25 geen zoekwoordtreffers heeft. - 10 compacte resultaten in plaats van 5 uitgebreide: De instructies van de vaardigheid hebben de medewerkers al verteld om
similarityentokenCountte negeren. Door die ongebruikte velden te verwijderen, passen we 10 compacte{id, description}-resultaten in exact hetzelfde budget van ~530 tokens als 5 uitgebreide resultaten:
// Before: 5 verbose results (~105 tokens each = ~525 tokens)
{
  "id": "dialog",
  "category": "html",
  "description": "Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby.",
  "featuresUsed": ["dialog", "dialog-closedby"],
  "tokenCount": 780,
  "similarity": 0.49
}
// After: 10 compact results (~53 tokens each = ~530 tokens)
{"id":"dialog","description":"Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby."}
Samen hebben deze 2 wijzigingen ons zoekhitpercentage voor vastgehouden telemetriequery's verhoogd van 80,6% naar 94,7%, gemeten als Hit@K (of de verwachte handleiding in de top K resultaten verschijnt).
Gen 3: Vooraf gemaakte embeddings en een for-lus van 7 regels
Zelfs met een hitpercentage van 94.7% toonde onze telemetrie een duidelijke mismatch: 86, 7% van de zoekopdrachten voor medewerkers van de klantenservice was maar 2 tot 5 woorden lang (mediaan: 3 woorden). Elke keer dat een medewerker een woordgroep van 3 woorden zocht, startte Node TensorFlow.js, parseerde het een neuraal netwerk van 22, 6 MB en verbruikte het 770 ms aan cold-start-latentie en 346 MB aan piek-RAM.
Toen we vroegen of er een lichtere manier was om zoekopdrachten van 3 woorden in te sluiten zonder een neuraal netwerk, kwam onze Antigravity-agent terug met een stapel onbekende ML-distillatietechnieken: Model2Vec, Tokenlearn, Matryoshka-dimensies, Adagrad. (Als je de technische details wilt weten, vind je meer informatie op onze pagina over zoekkwaliteit.)
Standaard lokale RAG dwingt zowel documenten als query's door hetzelfde kleine model op de CPU van de gebruiker. Maar onze ongeveer 200 handleidingen veranderen niet nadat we een npm-release hebben uitgebracht, dus er is geen reden om ze in te sluiten met een klein model uit 2018. In plaats daarvan berekent embed-guide-chunks.ts al onze gidsvectoren vooraf op het moment van de release in de cloud met gemini-embedding-001 en stuurt deze als binaire 256-dimensionale Int8-vectoren (guide-chunks.i8, 335 KB gzipped).
Hoe projecteert een offline CLI-project zonder API-sleutel de live query van een gebruiker in die exacte Gemini-vectorruimte? Omdat agentquery's bijna altijd 2 tot 5 woorden bevatten, hebben we tijdens de runtime geen transformator nodig. We hebben alleen een lookup-tabel met vectoren voor bekende woorden (table) en een slimme manier om ze op te tellen nodig. Tijdens de runtime wordt de hele TensorFlow.js-pipeline van 23 MB samengevouwen tot een for-lus van 7 regels in static-embedder.ts:
// Each word's weight and Int8 scale are pre-folded into `scales[i]`
for (const [i, f] of enc) {
  const wt = scales[i] * f;
  const offset = i * 256;
  for (let k = 0; k < 256; k++) {
    out[k] += wt * table[offset + k];
  }
}
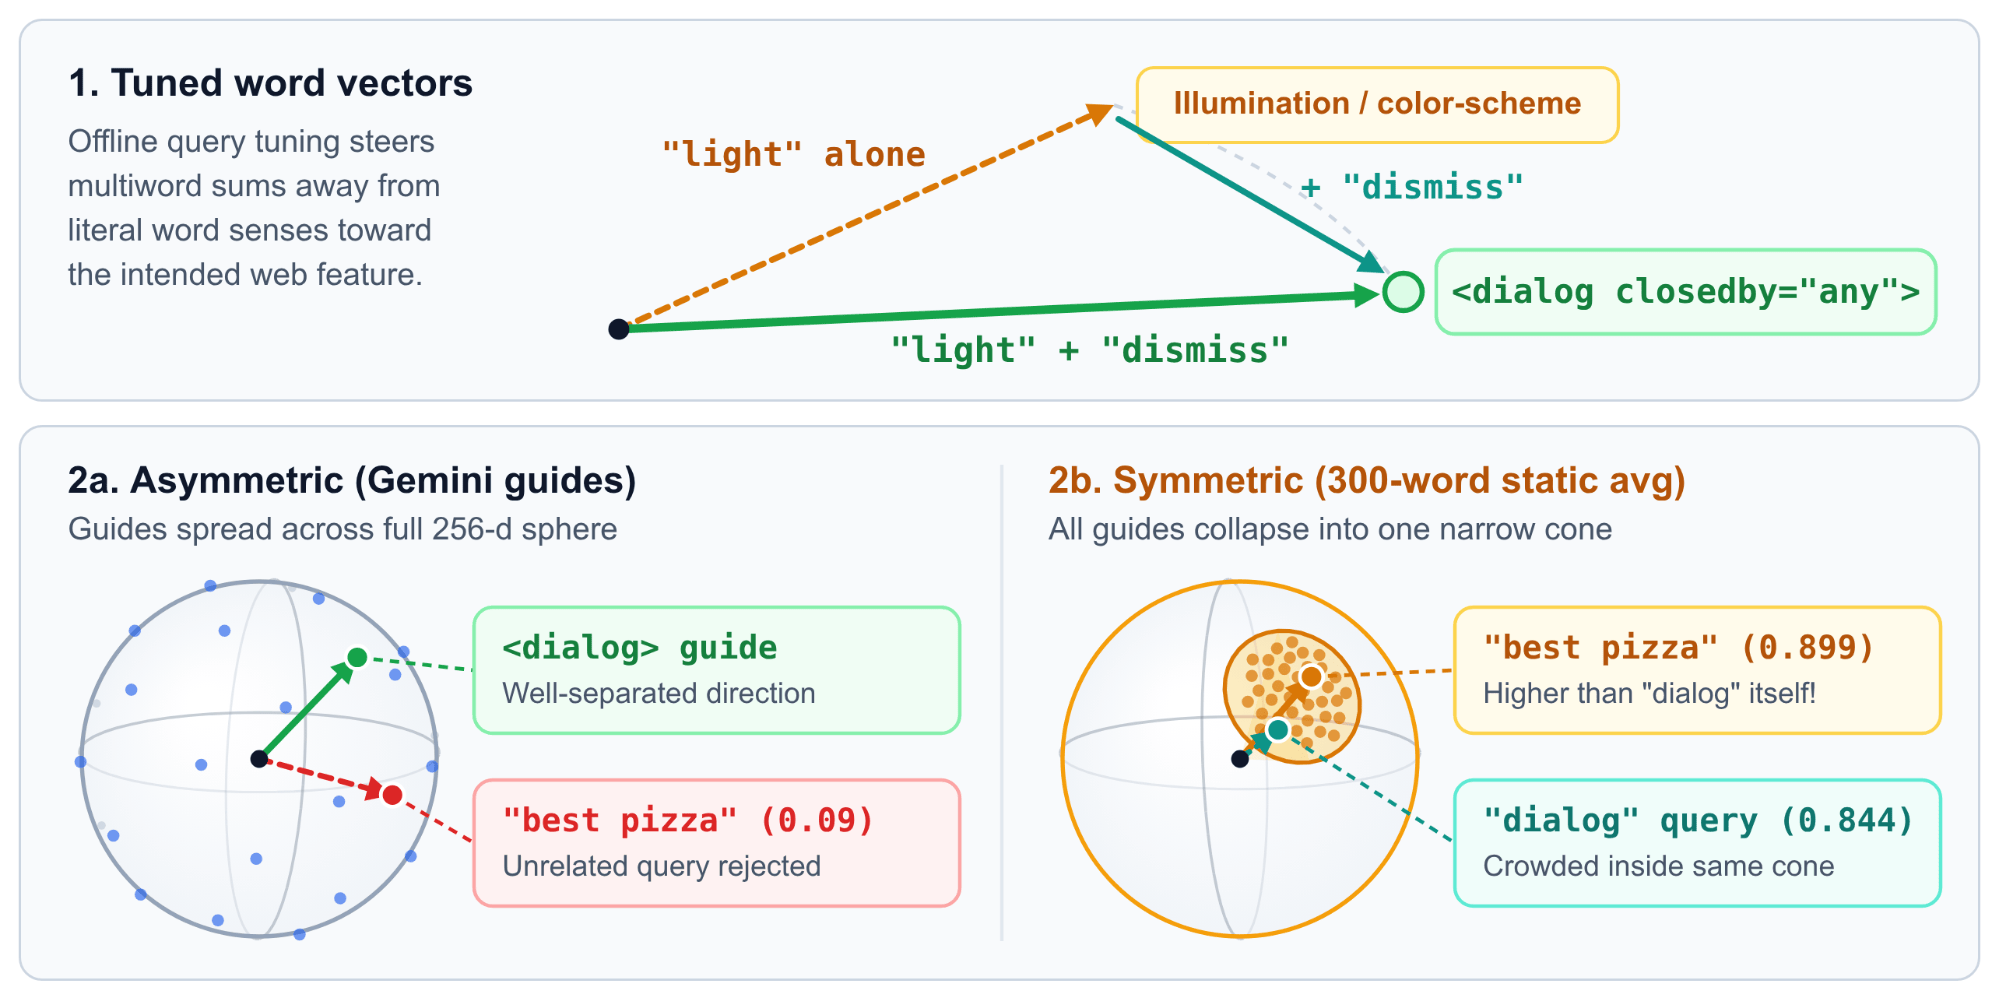
Voor die lookup-tabel (train-query-words.ts) hebben we een vocabulaire van 29.165 woorden gebruikt (waarin moderne webtermen zoals fetchpriority, light-dismiss, popover en scrollytelling zelfstandige hele woorden zijn), deze ingesloten met gemini-embedding-001 en de woordvectoren offline afgestemd op 33.000 echte webzoekopdrachten, zodat combinaties van meerdere woorden op de juiste plek terechtkomen (bijvoorbeeld "light" + "dismiss" verwijst naar <dialog closedby="any">, niet naar verlichting of kleurenschema's). Gecomprimeerd tot Int8 (query-words.i8), de hele lookup-tabel is 5.3 MB gzipped.
Waarom gebruik je die statische lookup-tabel niet om de gidsen ook in te sluiten en de cloudbuild-stap over te slaan? We hebben dat eerst geprobeerd en het werkte niet voor hele alinea's: de som van 3 zoekwoorden blijft scherp, maar het gemiddelde van honderden woorden in een hele gids zorgt ervoor dat elke gids wordt samengevouwen tot een smalle kegel in de buurt van het algemene Engelse gemiddelde (tot het punt waarop "best pizza in new york" een cosinusovereenkomst van 0.899 scoorde met onze dialog-gids, hoger dan de zoekopdracht "dialog" zelf met 0.844!). Door statische zoekopdrachten van 3 woorden (query-words.i8) te koppelen aan Gemini-gids-embeddings van het hele model (guide-chunks.i8), krijgen we nauwkeurigheid op cloudniveau, terwijl zoekopdrachten nog steeds offline worden uitgevoerd in 30 µs.
Het scorebord voor alle 3 de generaties
Tijdens onze releasemijlpalen steeg Hit@K van 78,2% met embeddings van hele documenten naar 95,4% met de statische Int8-embedder (vergeleken met 96,9% met de cloud-gemini-embedding-001-API):
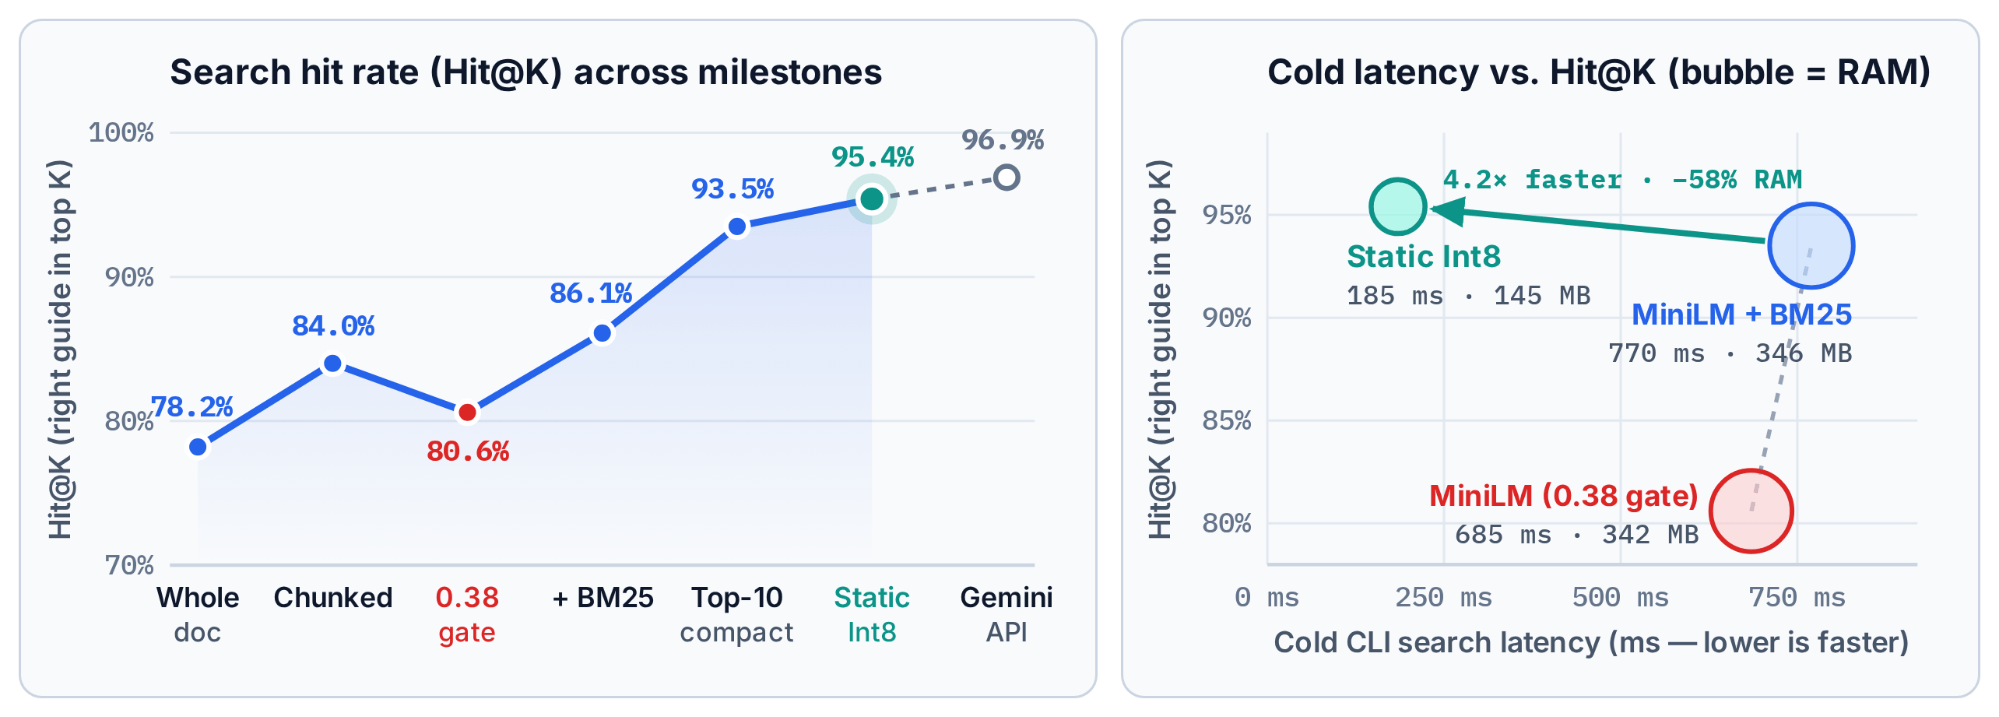
Zo verhouden de 3 generaties zich tot elkaar na de implementatie van de statische insluiting:
En als je die niet-werkende Codex-query van eerder uitvoert:
npx modern-web-guidance@latest search "confirm destructive action"
De dialog-gids staat weer bovenaan de lijst.
(Je kunt de interactieve diagrammen voor alle mijlpalen, querylengtes en K-horizonten verkennen op ons dashboard voor zoekkwaliteit.)
Code is goedkoop, meten is het werk
Een agent kan binnen een paar minuten een BM25-ranker of een script voor woordvectordistillatie schrijven. Het genereren van kandidaat-implementaties is niet langer de bottleneck. Weten of een wijziging daadwerkelijk heeft geholpen (of stilletjes 9% van de productiezoekopdrachten heeft verbroken, zoals onze 0.38-poort deed) is bijna de hele taak.
Zo hebben we dit systeem aangepakt:
- Definieer het kerndoel en investeer in het meetinstrument in plaats van in een enkele implementatie. We hebben veel meer tijd besteed aan het bouwen van
pnpm benchmark:rag, het beheren van 5000 echte zoekopdrachten en het kalibreren van onze geautomatiseerde beoordeling op basis van menselijke beoordelingen dan aan het schrijven van een retriever. - Maak een rubriek voor hoe jij en je agents de kwaliteit beoordelen en verwacht dat deze zich verder ontwikkelt zodra deze echte gegevens tegenkomt. Mensen noemen dit 'measurement-first', wat maar half klopt: je kunt op dag één basiscontroles met bekende antwoorden schrijven, maar je kunt geen goede rubriek ontwerpen in een vacuüm voordat je echte fouten hebt onderzocht (Shankar et al. noemen dit criteria drift in Who Validates the Validators?). Omdat we zagen dat agents fallbacks van 1500 tokens
listactiveerden,moesten we tokenbloat naast recall bestraffen. - Als je eenmaal betrouwbare metingen hebt, kun je experimenteren met verschillende implementaties en de resultaten gebruiken om discussies over de architectuur te beslechten. Zodra een benchmark 5000 query's in seconden beoordeelt, hoef je in PR's niet meer te discussiëren over de vraag of een
Int8-lus van 7 regels een transformer van 23 MB kan verslaan. Probeer 5 benaderingen in een middag en houd de winnaar.
Alle code (waaronder de embedder, distiller en benchmark-harness) is natuurlijk open source.