


เผยแพร่เมื่อวันที่ 12 พฤศจิกายน 2026
สัปดาห์นี้เราได้เปิดตัวคำแนะนำในการพัฒนาเว็บที่ทันสมัย 1.0 ซึ่งเป็นทักษะโอเพนซอร์สที่ช่วยให้เอเจนต์การเขียนโค้ดใช้ฟีเจอร์แพลตฟอร์มเว็บที่ทันสมัยแทนวิธีแก้ปัญหาชั่วคราวแบบเดิม โพสต์นี้จะพูดถึงเครื่องมือค้นหาในเครื่องที่ค้นหาคำแนะนำที่เกี่ยวข้องมากที่สุดสำหรับงานของคุณ โดยไม่ทำให้โทเค็นของคุณสูญเปล่า
หากคุณบอกวิศวกรว่าคุณสร้างฐานความรู้ด้วยข้อความ Markdown ขนาด 1.7 MB สำหรับเอเจนต์การเขียนโค้ด วิศวกรจะถามคำถาม 2 ข้อดังนี้
- "การดำเนินการนี้จะเพิ่มโทเค็นลงในหน้าต่างบริบทของฉันกี่รายการ"
- "ต้องใช้ฐานข้อมูลเวกเตอร์ที่ซับซ้อนแบบไหน"
ในช่วง 6 เดือนที่ผ่านมา เราได้สร้างเครื่องมือดึงข้อมูลในเครื่องขึ้นมาใหม่ถึง 3 ครั้ง เราเปลี่ยนจากการใช้การเชื่อมโยง C++ ขนาด 507 MB มาเป็น JavaScript ล้วนขนาด 23 MB โดยใช้ TensorFlow.js จากนั้นก็ลดลงเหลือแพ็กเกจขนาด 7 MB ซึ่งการฝังการค้นหาเป็นลูป for 7 บรรทัด โดยที่ปรับปรุงความแม่นยำไปพร้อมกัน
Agentic RAG และการเปิดเผยข้อมูลแบบต่อเนื่อง
การใส่ข้อความ Markdown ขนาด 1.7 MB ที่มีคู่มือ HTML/CSS/Web API กว่า 200 รายการลงใน AGENTS.md นั้นไม่สามารถทำได้จริง เราเชื่อในการเปิดเผยข้อมูลแบบก้าวหน้า แต่ก็ทราบว่าดัชนี Markdown จะหยุดใช้โทเค็นอย่างมีประสิทธิภาพเมื่อมีขนาดใหญ่ขึ้น
เพื่อแก้ปัญหานี้ เราใช้ RAG แบบ Agentic ที่สนับสนุนโดย CLI การค้นหา
- เมื่อไม่ได้ใช้งาน Agent จะเห็นเฉพาะคำอธิบายของทักษะ (~205 โทเค็น) คำอธิบายเป็นไปตามหลักเกณฑ์ทริกเกอร์ทักษะของ Anthropic เพื่อให้ Agent เรียกใช้ทักษะในงานส่วนหน้า (Frontend) ที่เกี่ยวข้อง
- ในงานส่วนหน้า เอเจนต์สามารถใช้ CLI เพื่อค้นหา
modern-web-guidance search "animate height auto"โดยได้รับผลการค้นหาที่เกี่ยวข้อง 10 รายการ (ประมาณ 530 โทเค็น) - Agent จะเรียกใช้
modern-web-guidance retrieve animate-to-intrinsic-sizesเพื่อดึงข้อมูลคู่มือทั้งหมด (ประมาณ 800 โทเค็น) ตอนนี้เราได้เพิ่มแนวทางปฏิบัติแนะนำในการติดตั้งใช้งานเพื่อความเข้ากันได้ การสำรอง และเทคนิค
ทำไมจึงใช้ทักษะ CLI แทนเซิร์ฟเวอร์ MCP หรือการค้นเว็บ
- เครื่องมือ MCP อาจทำให้โทเค็นสูญเปล่าหรือมีกลไกทริกเกอร์ที่ไม่น่าเชื่อถือ (เนื่องจากการค้นพบเครื่องมือแบบไดนามิก) คำอธิบายทักษะของเราได้รับการปรับแต่งให้มีประสิทธิภาพสูงสุดและช่วยให้ Agent ใช้คำแนะนำได้เฉพาะเมื่อเหมาะสมเท่านั้น
- การค้นเว็บในตัวจะแสดงคำตอบและเอกสารอ้างอิงจาก Stack Overflow ในปี 2015 แทนที่จะเป็นรูปแบบการใช้งาน
DO/DO NOTที่ได้รับการดูแลจัดการและเป็นปัจจุบัน นอกจากนี้ยังใช้เวลาหลายวินาทีผ่านเครือข่ายและดำเนินการไม่สำเร็จในแซนด์บ็อกซ์ออฟไลน์ ในขณะที่ CLI ในเครื่องทำงานบน CPU ในหน่วยมิลลิวินาที
รุ่นที่ 1: ต้นแบบ C++ ขนาด 507 MB
คำแนะนำในการพัฒนาเว็บที่ทันสมัยเวอร์ชันแรกใช้สแต็ก RAG ในเครื่อง ได้แก่ LanceDB, Apache Arrow และ Transformers.js พร้อม onnxruntime-native
วิธีนี้ทำงานได้ดีในคอมพิวเตอร์สำหรับการพัฒนาซอฟต์แวร์ แต่ไม่เหมาะกับทักษะของ Agent ดังนี้
- เมื่อเพิ่มทักษะลงในโปรเจ็กต์ (หรือ Agent เรียกใช้ด้วย
npx) คุณไม่จำเป็นต้องรอให้npm installดาวน์โหลดไบนารี.nodeที่ขึ้นอยู่กับสถาปัตยกรรมหรือการคอมไพล์ C++node-gypซึ่งมักจะล้มเหลวในแซนด์บ็อกซ์ระบบคลาวด์ - ไดเรกทอรี
node_modulesที่แตกไฟล์แล้วมีขนาด 507 MB
รุ่นที่ 2: การลดขนาด TensorFlow.js ลงเหลือ 23 MB
เราต้องการให้ไม่มีการคอมไพล์แบบเนทีฟและดำเนินการได้ทันทีไม่ว่า Node จะทำงานที่ใดก็ตาม ดังนั้นในเดือนเมษายน เราจึงแทนที่สแต็กแบบเนทีฟด้วยเครื่องมือ CPU แบบ JavaScript ล้วนที่เรียกใช้ all-MiniLM-L6-v2 ใน @tensorflow/tfjs ดังนี้
- Shimmed out
onnxruntime-nodein esbuild and replaced the Hugging Face tokenizer with a tiny in-tree BERT WordPiece tokenizer (0 token-ID mismatches). - หลังจากสำรวจแผนที่แหล่งที่มาแล้ว ตัดโมดูลกว่า 400 รายการของ
@tensorflow/tfjs-backend-cpuลงเหลือ 26 เคอร์เนลที่ MiniLM ใช้จริง ซึ่งลดขนาดเครื่องมือ JS จาก 6 MB เหลือ 830 KB - เลิกใช้ LanceDB สำหรับเวกเตอร์ที่บีบอัดด้วย gzip ในเวลาบิลด์ และการสแกนดอทโปรดักต์
<1 msในหน่วยความจำในคู่มือทั้งหมดประมาณ 200 รายการ - วาง Embedder ไว้หลังการเรียก
import()เพื่อให้retrieveและlistทำงานเสร็จภายในเวลาไม่ถึง 10 มิลลิวินาที
ซึ่งทำให้แพ็กเกจ npm มีขนาดลดลงเหลือ 23 MB โดยไม่มีทรัพยากร Dependency ของรันไทม์ เราเปิดตัวฟีเจอร์นี้ และตัวแทนได้ทำการค้นหาประมาณ 750,000 ครั้งโดยใช้ฟีเจอร์นี้
ตำแหน่งที่ MiniLM เสียในเวอร์ชันที่ใช้งานจริง
หลังจากผ่านไป 2-3 เดือน เราได้ดูวิถีการทำงานที่ตัวแทนติดตั้งทักษะแล้ว แต่ยังคงเขียนโค้ดเดิมอยู่
ในการเรียกใช้ Codex ครั้งหนึ่ง นักพัฒนาซอฟต์แวร์ได้ขอข้อความแจ้งให้ยืนยันการลบ เรามีคู่มือฉบับเต็มเกี่ยวกับการสร้างโมดัลการยืนยันที่เข้าถึงได้ด้วย HTML <dialog closedby="any">
ตัวแทนทำสิ่งที่ถูกต้องและค้นหาดังนี้
npx modern-web-guidance@latest search "confirm destructive action"
CLI แสดงผล [] ตัวแทนจึงยักไหล่และเขียนว่า window.confirm()
เหตุใดจึงแสดงผลเป็นค่าว่าง เมื่อเราเจาะลึกเข้าไปในบันทึกและการฝัง เราพบช่องว่างในการดึงข้อมูล 2 อย่างที่เห็นได้ชัด ดังนี้
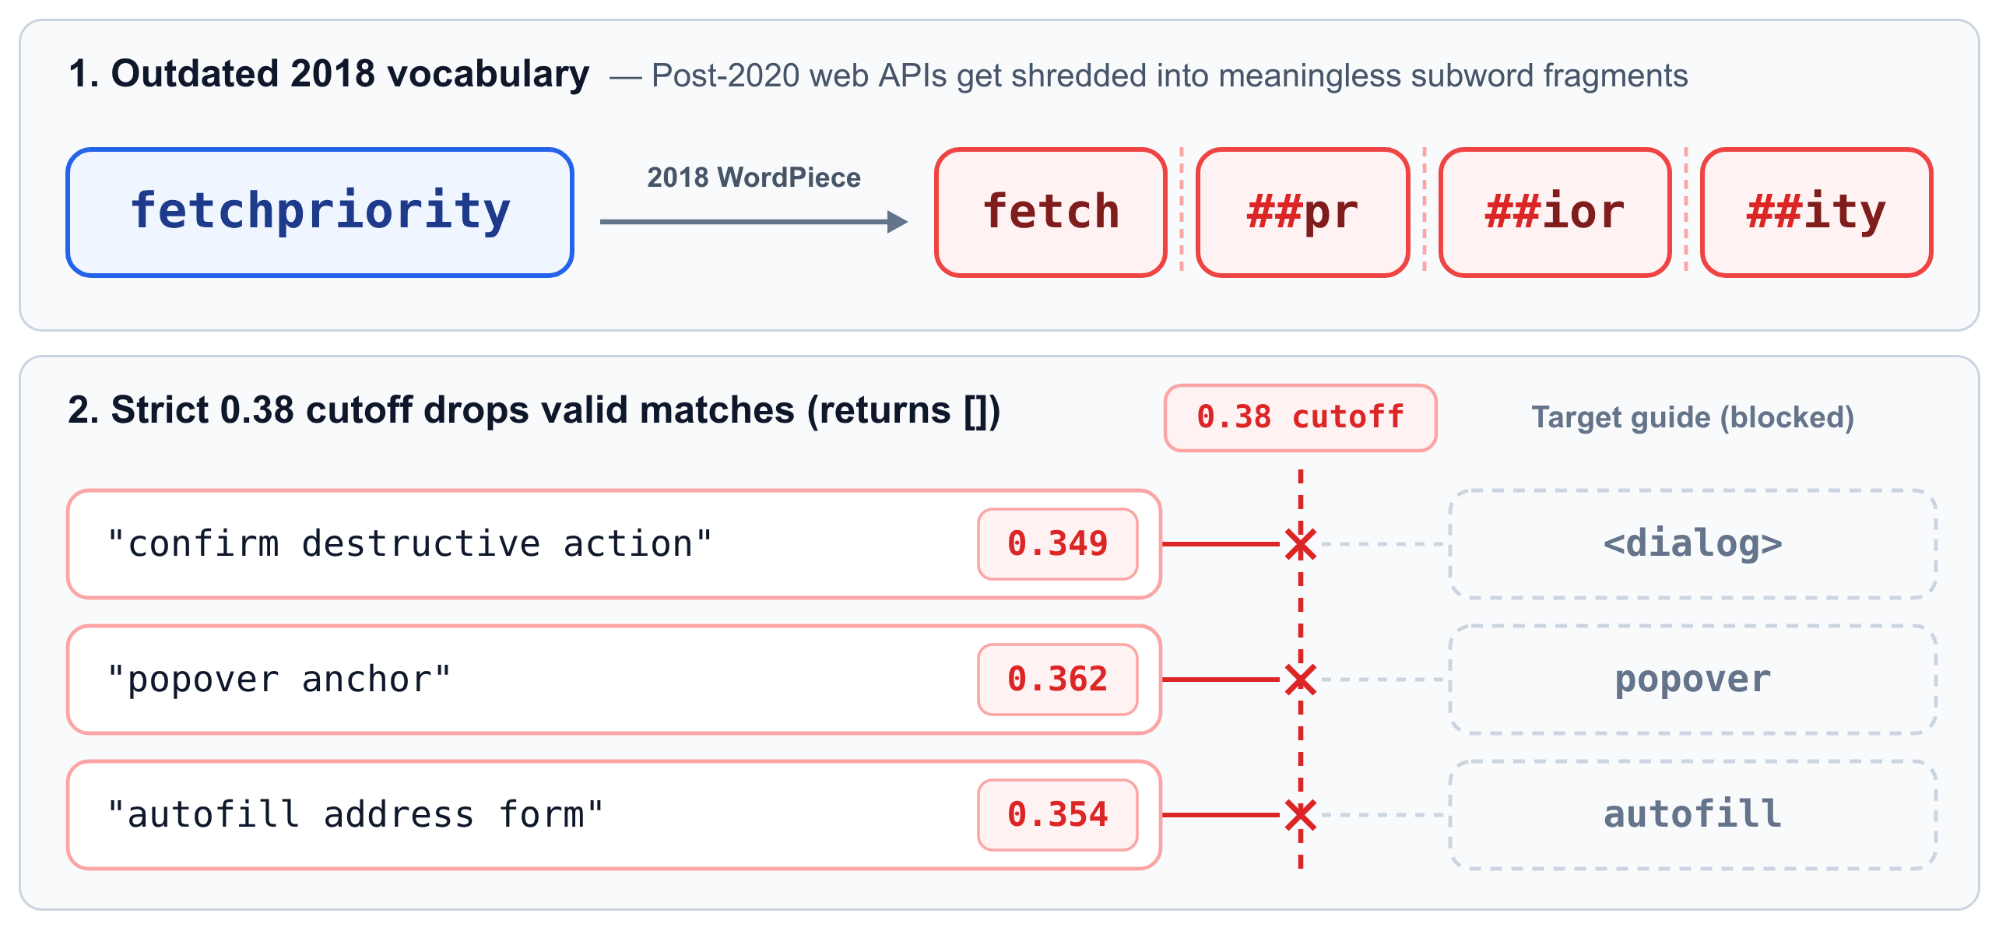
all-MiniLM-L6-v2ได้รับการฝึกในช่วงปี 2018-2020 ดังนั้นคำศัพท์ WordPiece ของโมเดลนี้จึงไม่ทราบเลยว่ามี Web API หลังปี 2020 อยู่ เมื่อ Agent ค้นหาfetchpriority,popoverหรือstartViewTransitionเครื่องมือสร้างโทเค็นปี 2018 จะแยกfetchpriorityออกเป็นคำย่อยที่ไม่มีความหมาย 4 คำ ได้แก่fetch·##pr·##ior·##ity- เพื่อป้องกันไม่ให้คำค้นหาที่อยู่นอกขอบเขตแสดงคำแนะนำแบบสุ่ม PR ก่อนหน้านี้ได้เพิ่มการตัดความคล้ายคลึงกันของโคไซน์ที่
0.38เข้มงวด เนื่องจาก MiniLM ไม่สามารถเชื่อมโยงวลี 3 คำ"confirm destructive action"กับ"dialog"ที่สูงกว่า0.38(คะแนน0.349ขณะที่"popover anchor"ได้0.362และ"autofill address form"ได้0.354) เกตจึงทิ้งการจับคู่ที่ถูกต้อง ที่แย่กว่านั้นคือเมื่อใดก็ตามที่searchแสดงผล[]คำสั่งทักษะของเราจะบอกให้ Agent กลับไปใช้modern-web-guidance listโดยทิ้งคำอธิบายไกด์ทั้งหมดประมาณ 200 รายการ (โทเค็นที่สูญเปล่าประมาณ 1,500 รายการ) ไว้ในบริบท
การแก้ไขการดึงข้อมูล: การตรวจวัดระยะไกลจริง การค้นหาแบบผสม และการแสดงผลลัพธ์ 10 รายการ
เกณฑ์มาตรฐานเดิมของเราคือคำค้นหาที่สังเคราะห์ขึ้น 850 รายการซึ่งสร้างขึ้นจากคำแนะนำเอง ซึ่งตรงกับวลีในคำแนะนำมากเกินไปจนตรวจจับความล้มเหลวเหล่านี้ไม่ได้ เราจึงสร้างชุดทดสอบการประเมินใหม่ (pnpm benchmark:rag) โดยใช้การค้นหาแบบเรียลไทม์ประมาณ 4,000 รายการที่สุ่มตัวอย่างจากการวัดและส่งข้อมูลทางไกลของ CLI ที่เลือกไม่ใช้ (ซึ่งบันทึกเฉพาะอาร์กิวเมนต์ search ที่มีความยาว 2-5 คำของ Agent โดยไม่บันทึกพรอมต์ของผู้ใช้หรือโค้ดที่เก็บ และเคารพ DISABLE_TELEMETRY=1) รวมถึงการค้นหา 1,029 รายการที่ขุดจากการประเมิน Agent ทุกคืนใน Claude Code, Codex CLI และ Gemini CLI
การเล่นประวัติ Git ซ้ำกับคำค้นหาที่ถูกระงับเหล่านั้นแสดงให้เห็นว่าการตัด 0.38 ทำให้การตอบกลับ [] ที่ว่างเปล่าเพิ่มขึ้น 8 เท่า เมื่อมีการเปรียบเทียบประสิทธิภาพแล้ว เราได้ทำการปรับปรุงอย่างรวดเร็ว 2 รายการก่อนที่จะแตะโมเดลการฝัง ดังนี้
- คีย์เวิร์ดแบบไฮบริด + การค้นหาเชิงความหมาย: เวกเตอร์แบบหนาแน่นจะเบลอชื่อ API ที่ตรงกันทุกประการ (
:user-invalid,showModal,details-name) ในขณะที่การค้นหาคีย์เวิร์ดจะพลาดคำค้นหาตามเจตนาเมื่อ Agent ไม่ทราบชื่อ API เราได้เพิ่มดัชนีคีย์เวิร์ด BM25 (ถ้าคุณรู้ คุณก็รู้) ที่ไม่มีทรัพยากร Dependency พร้อมการตัดคำพหูพจน์ จัดทำดัชนีweb-feature-idsของคำแนะนำแต่ละรายการ และรวม BM25 เข้ากับการจัดอันดับเชิงความหมาย ตอนนี้searchจะแสดงผล[]เท่านั้นเมื่อทั้งความคล้ายคลึงกันของความหมายเป็น<0.30และ BM25 มีคีย์เวิร์ดที่ตรงกันเป็น 0 รายการ - ผลลัพธ์แบบกระชับ 10 รายการแทนที่จะเป็นแบบละเอียด 5 รายการ: คำสั่งของทักษะได้บอกให้ Agent ละเว้น
similarityและtokenCountแล้ว การตัดฟิลด์ที่ไม่ได้ใช้ออกทำให้เราสามารถใส่ผลลัพธ์แบบกะทัดรัดได้ 10 รายการ{id, description}ในงบประมาณโทเค็น ~530 รายการเท่ากับผลลัพธ์แบบละเอียด 5 รายการ ดังนี้
// Before: 5 verbose results (~105 tokens each = ~525 tokens)
{
  "id": "dialog",
  "category": "html",
  "description": "Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby.",
  "featuresUsed": ["dialog", "dialog-closedby"],
  "tokenCount": 780,
  "similarity": 0.49
}
// After: 10 compact results (~53 tokens each = ~530 tokens)
{"id":"dialog","description":"Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby."}
การเปลี่ยนแปลงทั้ง 2 อย่างนี้ช่วยเพิ่มอัตราการค้นหาที่ตรงกับคำค้นหาทางไกลที่ถูกระงับจาก 80.6% เป็น 94.7% โดยวัดเป็น Hit@K (คำแนะนำที่คาดไว้ปรากฏในผลการค้นหา K อันดับแรกหรือไม่)
Gen 3: การฝังที่สร้างไว้ล่วงหน้าและลูป for 7 บรรทัด
แม้จะมีอัตรา Hit อยู่ที่ 94.7% แต่การตรวจวัดระยะไกลของเราก็แสดงให้เห็นถึงความไม่สอดคล้องกันอย่างชัดเจน นั่นคือ 86.7% ของการค้นหาตัวแทนแบบเรียลไทม์มีความยาวเพียง 2-5 คำ (ค่ามัธยฐาน: 3 คำ) ทุกครั้งที่ตัวแทนค้นหาวลี 3 คำ Node จะบูต TensorFlow.js, แยกวิเคราะห์โครงข่ายระบบประสาทเทียมขนาด 22.6 MB และใช้เวลาในการตอบสนองแบบ Cold Start 770 มิลลิวินาที และ RAM สูงสุด 346 MB
เมื่อถามว่ามีวิธีที่เบากว่าในการฝังคำค้นหา 3 คำโดยไม่ต้องใช้โครงข่ายระบบประสาทเทียมหรือไม่ Agent ของ Antigravity ของเราก็กลับมาพร้อมกับเทคนิคการกลั่น ML ที่ไม่คุ้นเคยมากมาย เช่น Model2Vec, Tokenlearn, มิติข้อมูล Matryoshka, Adagrad (หากต้องการทราบรายละเอียดทางเทคนิค โปรดดูข้อมูลเพิ่มเติมในหน้าคุณภาพการค้นหา)
RAG ในเครื่องแบบมาตรฐานจะบังคับให้ทั้งเอกสารและคำค้นหาผ่านโมเดลขนาดเล็กเดียวกันบน CPU ของผู้ใช้ แต่คู่มือประมาณ 200 รายการของเราไม่ได้เปลี่ยนแปลงหลังจากที่เราตัดการเผยแพร่ npm ออก ดังนั้นจึงไม่มีเหตุผลที่จะฝังคู่มือเหล่านั้นด้วยโมเดลขนาดเล็กปี 2018 แต่ embed-guide-chunks.ts จะเตรียมเวกเตอร์คำแนะนำทั้งหมดไว้ล่วงหน้า ณ เวลาที่เผยแพร่ในระบบคลาวด์โดยใช้ gemini-embedding-001 และจัดส่งเป็นเวกเตอร์ Int8 แบบไบนารี 256 มิติ (guide-chunks.i8, 335 KB gzipped)
CLI แบบออฟไลน์ที่ไม่มีคีย์ API จะฉายภาพคำค้นหาแบบเรียลไทม์ของผู้ใช้ไปยังพื้นที่เวกเตอร์ Gemini เดียวกันทุกประการได้อย่างไร เนื่องจากคำค้นหาของตัวแทนมักมี 2-5 คำเสมอ เราจึงไม่จำเป็นต้องใช้ Transformer ขณะรันไทม์ เราแค่ต้องการตารางตรวจสอบเวกเตอร์สำหรับคำที่รู้จัก (table) และวิธีที่ชาญฉลาดในการรวมเวกเตอร์เหล่านั้น ในรันไทม์ ไปป์ไลน์ TensorFlow.js ขนาด 23 MB ทั้งหมดจะยุบเป็นลูป for 7 บรรทัดใน static-embedder.ts ดังนี้
// Each word's weight and Int8 scale are pre-folded into `scales[i]`
for (const [i, f] of enc) {
  const wt = scales[i] * f;
  const offset = i * 256;
  for (let k = 0; k < 256; k++) {
    out[k] += wt * table[offset + k];
  }
}
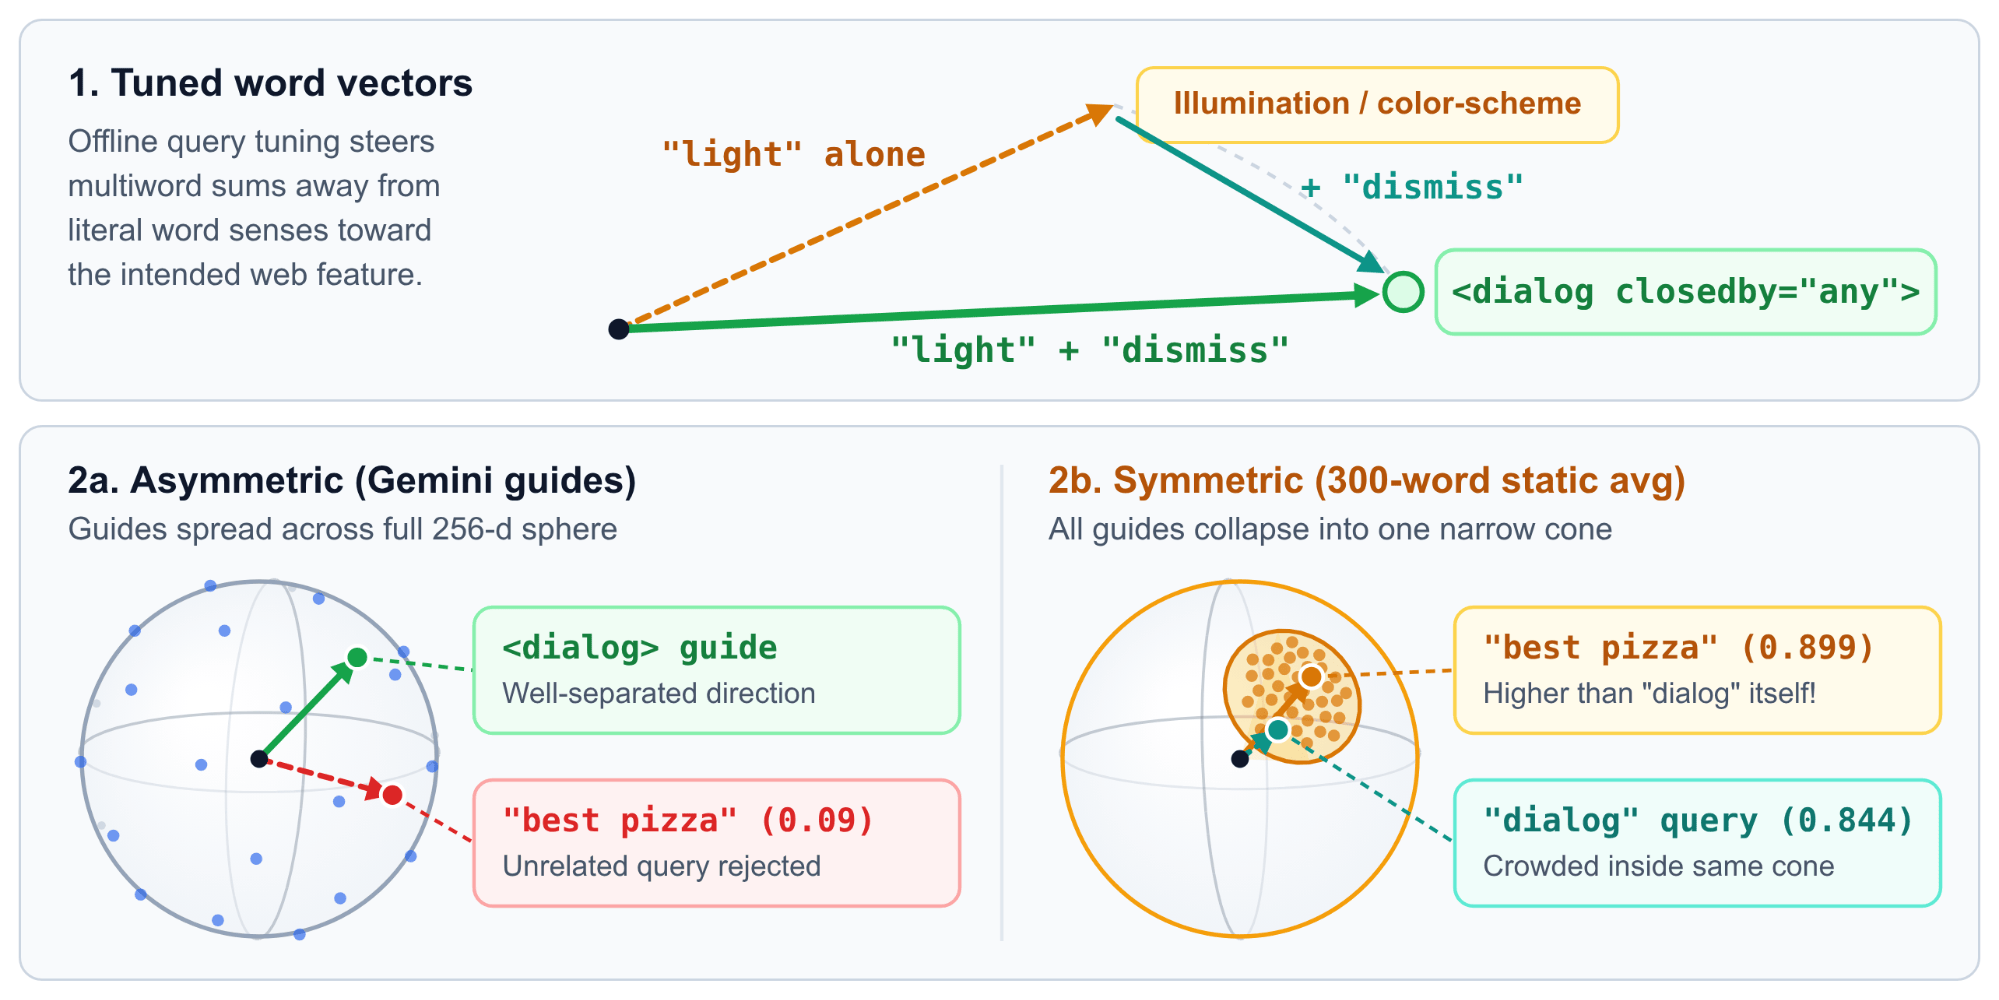
ในการสร้างตารางการค้นหา (train-query-words.ts) เราได้นำคำศัพท์ 29,165 คำ (ซึ่งคำศัพท์บนเว็บสมัยใหม่อย่าง fetchpriority, light-dismiss, popover และ scrollytelling เป็นคำเดี่ยวๆ) มาฝังด้วย gemini-embedding-001 และปรับแต่งเวกเตอร์คำแบบออฟไลน์กับคำค้นหาจริงบนเว็บ 33,000 รายการ เพื่อให้การรวมคำหลายคำอยู่ในจุดที่ถูกต้อง (เช่น "light" + "dismiss" ชี้ไปที่ <dialog closedby="any"> ไม่ใช่การส่องสว่างหรือรูปแบบสี) เมื่อบีบอัดเป็น Int8 (query-words.i8) ตารางตรวจสอบทั้งหมดจะได้รับการบีบอัดด้วย gzip เป็น 5.3 MB
ทำไมไม่ใช้ตารางตรวจสอบแบบคงที่นั้นเพื่อฝังคำแนะนำด้วย และข้ามขั้นตอนการสร้างระบบคลาวด์ไปเลย เราลองวิธีนั้นก่อนและพบว่าใช้ไม่ได้กับทั้งย่อหน้า: การรวมคำค้นหา 3 คำยังคงแม่นยำ แต่การหาค่าเฉลี่ยของคำหลายร้อยคำในคู่มือทั้งเล่มทำให้คู่มือทุกเล่มยุบลงเหลือเพียงกรวยแคบๆ ใกล้กับค่าเฉลี่ยภาษาอังกฤษทั่วไป (จนถึงจุดที่ "best pizza in new york" ได้คะแนนความคล้ายคลึงกันของโคไซน์ 0.899 เทียบกับคู่มือ dialog ของเรา ซึ่งสูงกว่าคำค้นหา "dialog" เองที่ 0.844!) การจับคู่การค้นหาคำค้นหาแบบคงที่ 3 คำ (query-words.i8) กับการฝังคู่มือ Gemini แบบเต็มโมเดล (guide-chunks.i8) ช่วยให้เรามีความแม่นยำระดับคลาวด์ในขณะที่คำค้นหายังคงทำงานแบบออฟไลน์ใน 30 µs
กระดานคะแนนของทั้ง 3 เจเนอเรชัน
ตลอดเป้าหมายการเปิดตัวของเรา Hit@K เพิ่มขึ้นจาก 78.2% ด้วยการฝังทั้งเอกสารเป็น 95.4% ด้วยเครื่องมือฝัง Int8 แบบคงที่ (เทียบกับ 96.9% ด้วย Cloud APIs gemini-embedding-001)
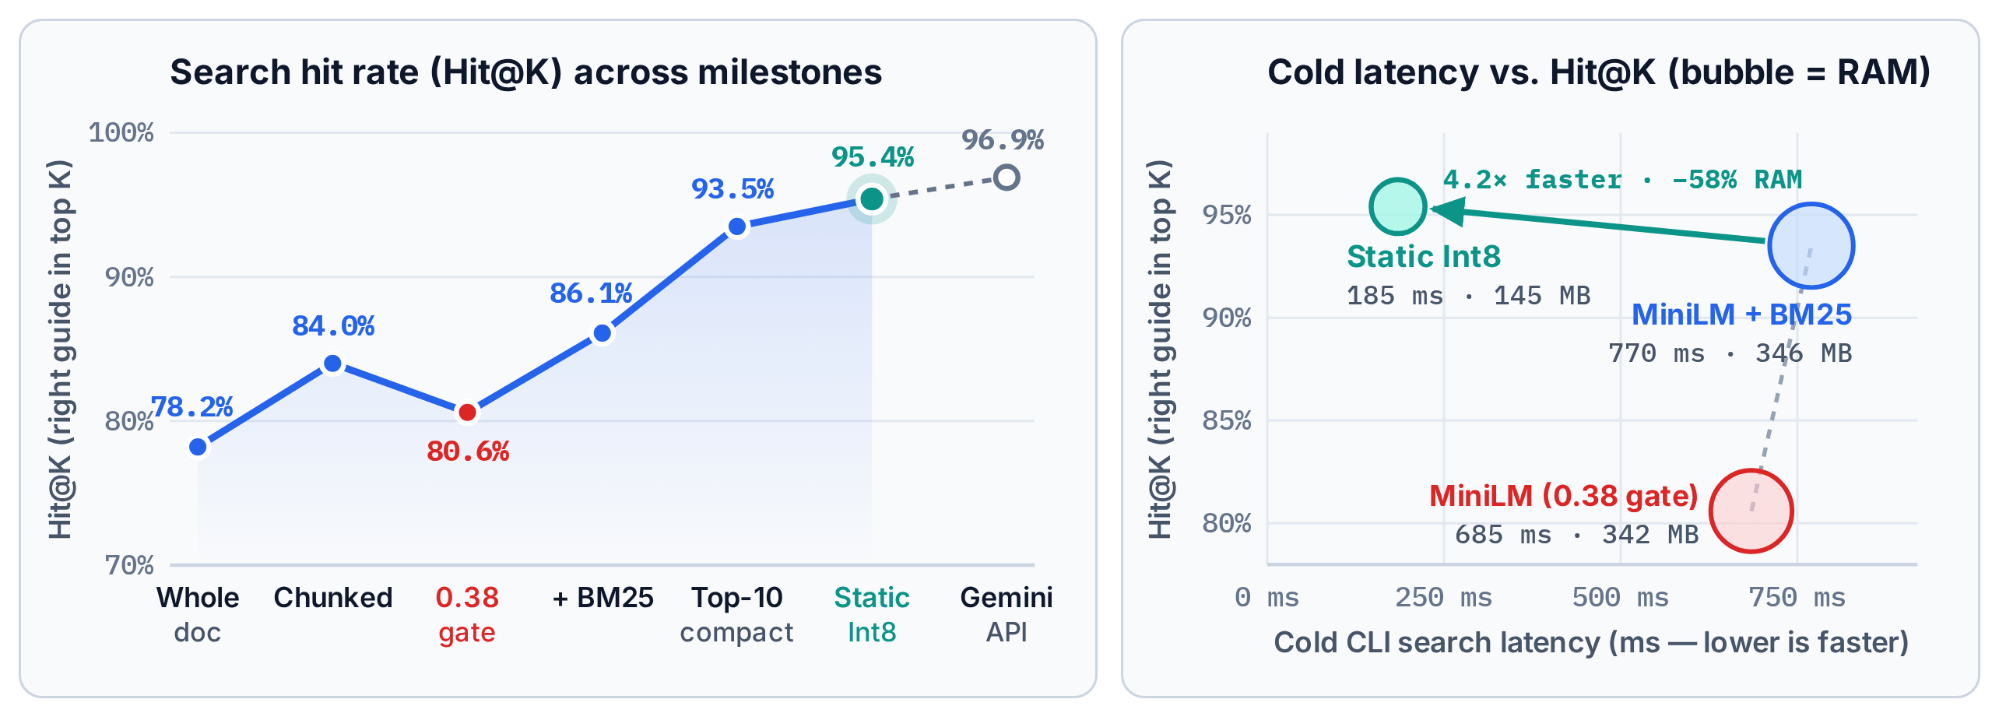
ต่อไปนี้คือประสิทธิภาพของทั้ง 3 รุ่นหลังจากเปิดตัวเครื่องมือฝังแบบคงที่
และหากคุณเรียกใช้คำค้นหา Codex ที่ใช้งานไม่ได้จากก่อนหน้านี้
npx modern-web-guidance@latest search "confirm destructive action"
คำแนะนำ dialog จะกลับมาอยู่ที่ด้านบนของรายการ
(คุณสามารถสำรวจแผนภูมิแบบอินเทอร์แอกทีฟในทุกเหตุการณ์สำคัญ ความยาวของคำค้นหา และขอบเขต K ได้ในแดชบอร์ดคุณภาพการค้นหา)
โค้ดเป็นเรื่องง่าย การวัดผลต่างหากที่เป็นงาน
Agent สามารถเขียนสคริปต์การจัดอันดับ BM25 หรือการกลั่นเวกเตอร์คำได้ในไม่กี่นาที การสร้างการติดตั้งใช้งานที่เป็นไปได้ไม่ใช่ปัญหาคอขวดอีกต่อไป การรู้ว่าการเปลี่ยนแปลงช่วยได้จริงหรือไม่ (หรือทำให้การค้นหาในเวอร์ชันที่ใช้งานจริง 9% เสียไปอย่างเงียบๆ เหมือนที่เกต 0.38 ของเราทำ) ถือเป็นงานเกือบทั้งหมด
เราใช้แนวทางต่อไปนี้ในการสร้างระบบนี้
- กำหนดเป้าหมายที่ใช้เป็นแนวทางหลักและลงทุนในเครื่องมือวัดผลมากกว่าการติดตั้งใช้งานเพียงอย่างเดียว เราใช้เวลาไปกับการสร้าง
pnpm benchmark:rag, การดูแลจัดการคำค้นหาจริง 5,000 รายการ และการปรับเทียบการให้คะแนนอัตโนมัติกับการให้คะแนนของมนุษย์มากกว่าการเขียน Retriever - สร้างเกณฑ์การให้คะแนนสำหรับวิธีที่คุณและตัวแทนตัดสินคุณภาพ และคาดหวังว่าเกณฑ์ดังกล่าวจะพัฒนาขึ้นเมื่อพบกับข้อมูลในโลกแห่งความเป็นจริง ผู้คนเรียกสิ่งนี้ว่า "การวัดผลเป็นอันดับแรก" ซึ่งถูกต้องเพียงครึ่งเดียว กล่าวคือ คุณสามารถเขียนการตรวจสอบคำตอบที่ทราบพื้นฐานได้ตั้งแต่วันแรก แต่คุณไม่สามารถออกแบบเกณฑ์การให้คะแนนที่ดีในสุญญากาศก่อนที่จะตรวจสอบความล้มเหลวจริง (Shankar และคณะเรียกสิ่งนี้ว่าการเปลี่ยนแปลงของเกณฑ์ใน Who Validates the Validators?) การเห็น Agent ทริกเกอร์การใช้
listสำรอง 1,500 โทเค็นทำให้เราต้องลงโทษการใช้โทเค็นมากเกินไปควบคู่ไปกับการเรียกคืน - เมื่อมีการวัดผลที่เชื่อถือได้แล้ว ให้ทดลองใช้การติดตั้งใช้งานที่แตกต่างกันอย่างจริงจัง และให้ตารางสรุปสถิติเป็นตัวตัดสินการถกเถียงเกี่ยวกับสถาปัตยกรรม เมื่อการเปรียบเทียบให้คะแนนคำค้นหา 5,000 รายการได้ในไม่กี่วินาที คุณก็ไม่ต้องโต้เถียงใน PR ว่าลูป
Int87 บรรทัดจะเอาชนะ Transformer ขนาด 23 MB ได้หรือไม่ ลองใช้ 5 แนวทางในช่วงบ่ายและเก็บแนวทางที่ได้ผลดีที่สุดไว้
แน่นอนว่าโค้ดทั้งหมด (รวมถึง Embedder, Distiller และชุดทดสอบการเปรียบเทียบ) เป็นโอเพนซอร์ส