


Дата публикации: 12 ноября 2026 г.
На этой неделе мы запустили Modern Web Guidance 1.0 – навык с открытым исходным кодом, который помогает агентам-программистам использовать современные функции веб-платформы вместо устаревших обходных решений. В этой статье мы расскажем о локальной поисковой системе, которая находит наиболее подходящее руководство для вашей задачи, не тратя ваши токены.
Если вы скажете инженеру, что создали базу знаний с 1,7 МБ текста Markdown для его агента кодирования, он задаст два вопроса:
- "Сколько токенов будет добавлено в мое окно контекста?"
- "Какая раздутая векторная база данных для этого нужна?"
За последние полгода мы трижды перестраивали локальную поисковую систему. Мы перешли от 507 МБ привязок C++ к 23 МБ чистого JavaScript с использованием TensorFlow.js, а затем к пакету размером 7 МБ, в котором встраивание запросов представляет собой цикл for из 7 строк. При этом точность повысилась.
Агентская RAG и постепенное раскрытие информации
Загружать в AGENTS.md 1,7 МБ текста в формате Markdown, содержащего более 200 руководств по HTML, CSS и Web API, нецелесообразно. Мы верим в постепенное раскрытие информации, но знаем, что индекс Markdown перестанет быть эффективным с точки зрения токенов в масштабе.
Чтобы решить эту проблему, мы используем агентскую RAG, поддерживаемую CLI поиска:
- В режиме ожидания агент видит только описание навыка (около 205 токенов). Описание соответствует рекомендациям Anthropic по триггерам навыков, поэтому агент вызывает навык для соответствующих задач интерфейса.
- При выполнении задач, связанных с интерфейсом, агент может использовать CLI для поиска:
modern-web-guidance search "animate height auto", получая 10 релевантных совпадений (~530 токенов). - Агент запускает
modern-web-guidance retrieve animate-to-intrinsic-sizes, чтобы получить все руководство (около 800 токенов). Теперь в нем есть рекомендации по реализации, касающиеся совместимости, резервных объявлений и методов.
Почему навык CLI, а не MCP-сервер или поиск в интернете?
- Инструменты MCP либо тратят токены впустую, либо имеют ненадежные механизмы запуска (из-за динамического обнаружения инструментов). Описание навыка оптимизировано для эффективности и позволяет агенту использовать рекомендации только тогда, когда это необходимо.
- Встроенный веб-поиск выдает ответы со Stack Overflow за 2015 год и справочную документацию, а не актуальные, проверенные шаблоны реализации
DO/DO NOT. Кроме того, на выполнение запроса по сети уходит несколько секунд, а в офлайн-песочницах он завершается ошибкой. Локальный интерфейс командной строки выполняется на ЦП за миллисекунды.
Первое поколение: прототип на C++ размером 507 МБ
В первой версии Modern Web Guidance использовался локальный стек RAG: LanceDB, Apache Arrow и Transformers.js с onnxruntime-native.
На компьютере разработчика все работало отлично, но для навыка агента это не подходило:
- Когда вы добавляете навык в проект (или агент вызывает его с помощью
npx), вы не ожидаете, что придется ждать, покаnpm installскачает зависимые от архитектуры двоичные файлы.nodeили скомпилирует код C++node-gyp, что обычно не удается сделать в облачных песочницах. - Размер извлеченного каталога
node_modulesсоставил 507 МБ.
Второе поколение: уменьшение размера TensorFlow.js до 23 МБ
Мы хотели, чтобы не было нативной компиляции и чтобы код мгновенно выполнялся везде, где работает Node. Поэтому в апреле мы заменили нативный стек на процессорный движок на чистом JavaScript, который запускает all-MiniLM-L6-v2 на @tensorflow/tfjs:
- Заменили
onnxruntime-nodeв esbuild и токенизатор Hugging Face на крошечный токенизатор BERT WordPiece (0 несовпадений идентификаторов токенов). - Изучив карты кода, мы сократили более 400 модулей
@tensorflow/tfjs-backend-cpuдо 26 ядер, которые действительно используются в MiniLM. В результате размер JS-движка уменьшился с 6 МБ до 830 КБ. - Мы отказались от LanceDB в пользу сжатых векторов, создаваемых во время сборки, и сканирования скалярного произведения
<1 msв памяти по всем 200 руководствам. - Поместите встраиваемый код за вызовом
import(), чтобыretrieveиlistзавершались менее чем за 10 миллисекунд.
Это позволило уменьшить размер пакета npm до 23 МБ без зависимостей среды выполнения. Мы запустили его, и агенты выполнили около 750 000 поисковых запросов.
Где MiniLM сломался в рабочей версии
Через пару месяцев мы проанализировали траектории, в которых у агентов был установлен навык, но они все равно писали устаревший код.
В одном из запусков Codex разработчик попросил добавить запрос на подтверждение удаления. У нас есть целое руководство по созданию доступных модальных окон подтверждения с помощью HTML-элемента <dialog closedby="any">.
Агент поступил правильно и выполнил поиск:
npx modern-web-guidance@latest search "confirm destructive action"
Интерфейс командной строки вернул []. Агент пожал плечами и написал window.confirm().
Почему он пустой? Изучив журналы и эмбеддинги, мы обнаружили две проблемы с извлечением данных:
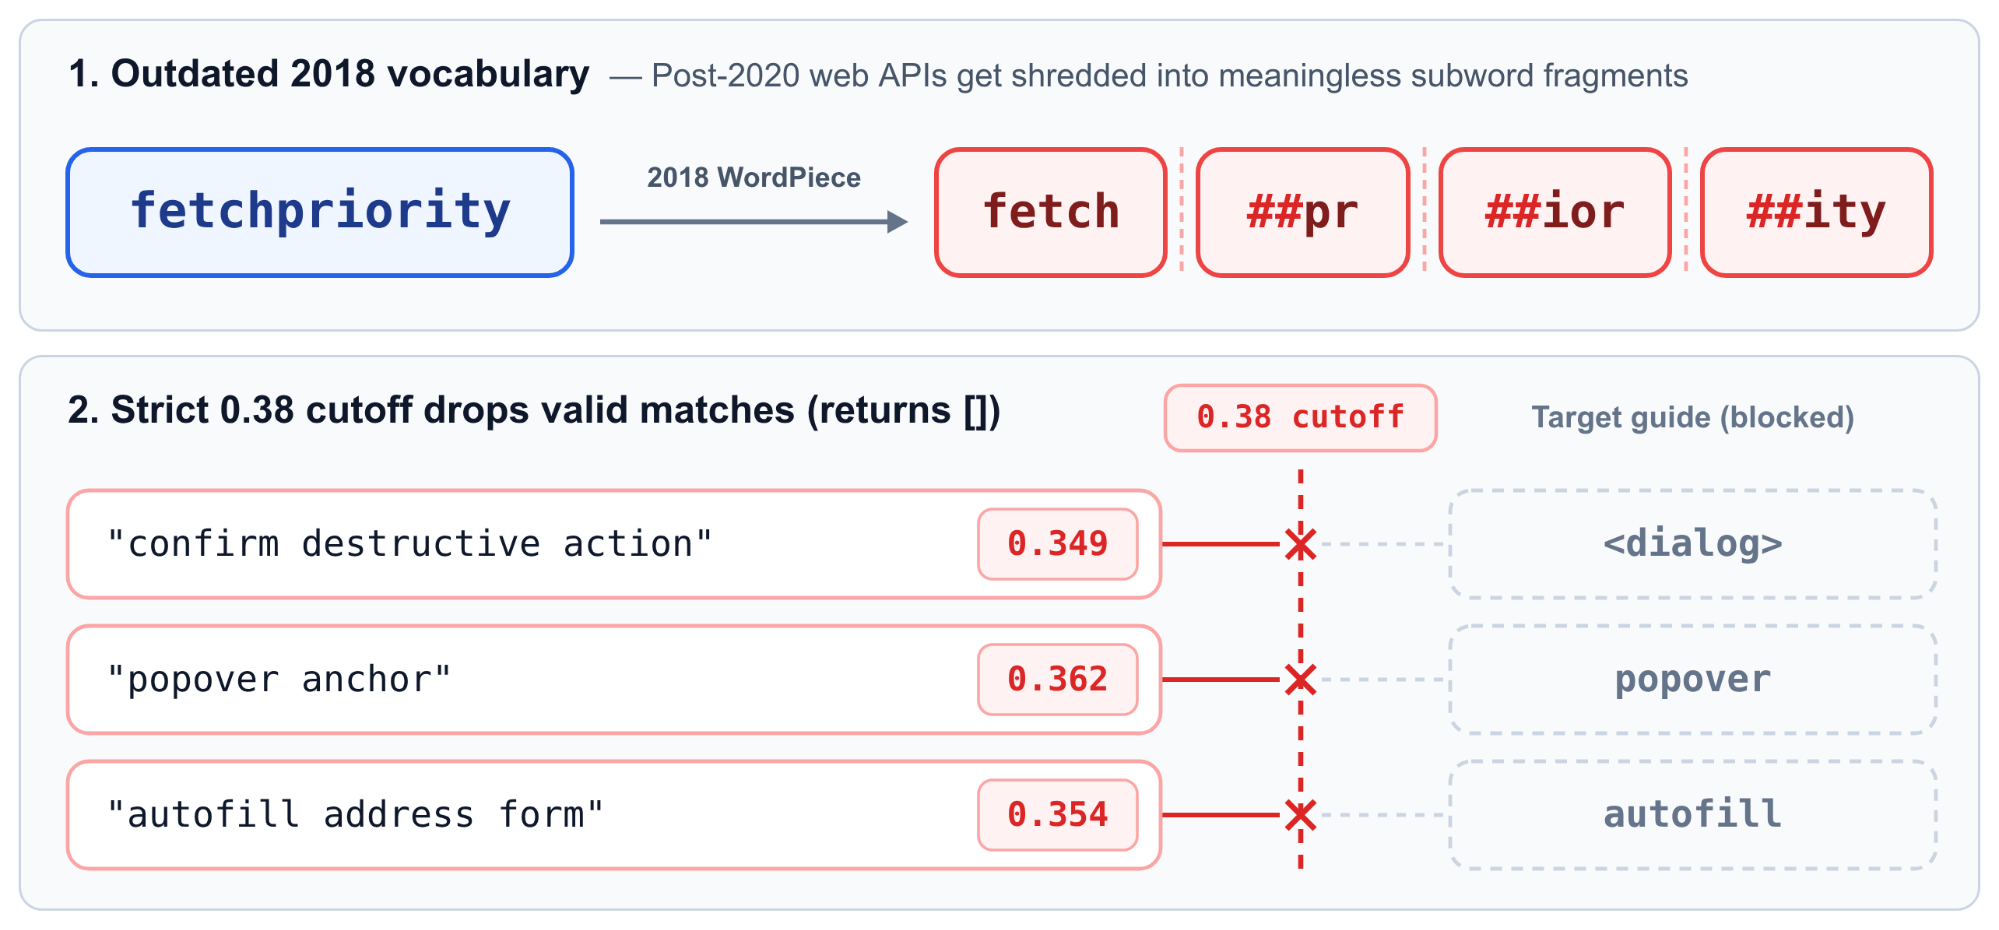
all-MiniLM-L6-v2обучалась примерно в 2018–2020 годах, поэтому в ее словаре WordPiece буквально нет информации о веб-API, появившихся после 2020 года. Когда агент ищетfetchpriority,popoverилиstartViewTransition, токенизатор 2018 года разбиваетfetchpriorityна четыре бессмысленных подслова:fetch·##pr·##ior·##ity.- Чтобы предотвратить возврат случайных руководств по запросам, выходящим за рамки области, в предыдущем PR было добавлено строгое ограничение косинусного сходства
0.38. Поскольку MiniLM не смогла связать фразу из трех слов"confirm destructive action"с"dialog"выше0.38(оценка0.349, в то время как"popover anchor"получила0.362, а"autofill address form"–0.354), шлюз отбросил действительные совпадения. Хуже того, когдаsearchвозвращал[], инструкции по навыкам предписывали агенту вернуться кmodern-web-guidance list, сбрасывая все ~200 описаний руководств (~1500 потраченных токенов) в контекст.
Исправление извлечения: реальная телеметрия, гибридный поиск и возврат 10 результатов
Наш первоначальный контрольный показатель составлял 850 синтетических запросов, сгенерированных на основе самих руководств, которые слишком точно соответствовали формулировкам руководства, чтобы уловить эти сбои. Поэтому мы создали новую систему оценки (pnpm benchmark:rag) на основе 4000 поисковых запросов, полученных из телеметрии CLI (которая регистрирует только аргумент search агента из 2–5 слов, никогда не сохраняет запросы пользователей или код репозитория и соблюдает DISABLE_TELEMETRY=1), а также 1029 поисковых запросов, полученных в результате ночных оценок агентов в Claude Code, Codex CLI и Gemini CLI.
Проанализировав историю git, мы обнаружили, что после изменения порогового значения 0.38 количество пустых ответов [] выросло в восемь раз. После этого мы внесли два быстрых улучшения, не затрагивая модель встраивания:
- Гибридный поиск по ключевым словам и семантический поиск. Плотные векторы размывают точные названия API (
:user-invalid,showModal,details-name), а поиск по ключевым словам пропускает запросы о намерениях, когда агент не знает название API. Мы добавили индекс ключевых слов BM25 (если вы понимаете, о чем речь) с нулевой зависимостью и стеммингом множественного числа, проиндексировалиweb-feature-idsкаждого руководства и объединили BM25 с семантическим ранжированием. Теперьsearchвозвращает[]только в том случае, если семантическое сходство равно<0.30и BM25 не находит совпадений по ключевым словам. - 10 кратких результатов вместо 5 подробных. В инструкциях к навыку агентам уже было сказано игнорировать
similarityиtokenCount. Удалив неиспользуемые поля, мы можем уместить 10 компактных результатов{id, description}в тот же лимит в 530 токенов, что и 5 подробных:
// Before: 5 verbose results (~105 tokens each = ~525 tokens)
{
  "id": "dialog",
  "category": "html",
  "description": "Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby.",
  "featuresUsed": ["dialog", "dialog-closedby"],
  "tokenCount": 780,
  "similarity": 0.49
}
// After: 10 compact results (~53 tokens each = ~530 tokens)
{"id":"dialog","description":"Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby."}
Вместе эти два изменения повысили долю успешных поисков по телеметрическим запросам с 80, 6 % до 94,7 %. Этот показатель измеряется как Hit@K (появляется ли ожидаемое руководство в первых K результатах).
Поколение 3. Предварительно запеченные эмбеддинги и цикл for из семи строк
Даже при 94.7% точности наша телеметрия показала явное несоответствие: 86, 7 % поисковых запросов операторов состояли всего из 2–5 слов (медиана – 3 слова). Каждый раз, когда агент искал фразу из трех слов, Node загружал TensorFlow.js, анализировал нейронную сеть размером 22,6 МБ и тратил 770 мс на холодный запуск и 346 МБ пиковой оперативной памяти.
Когда мы спросили, можно ли встроить запросы из трех слов без нейросети, агент Antigravity предложил несколько незнакомых нам методов дистилляции машинного обучения: Model2Vec, Tokenlearn, Matryoshka dimensions и Adagrad. Если вы хотите узнать больше, посетите страницу, посвященную качеству поиска.
Стандартная локальная RAG-система обрабатывает и документы, и запросы с помощью одной и той же небольшой модели на ЦП пользователя. Но наши ~200 руководств не меняются после того, как мы выпускаем npm, поэтому нет причин встраивать их с помощью крошечной модели 2018 года. Вместо этого embed-guide-chunks.ts предварительно создает все направляющие векторы в облаке во время выпуска с помощью gemini-embedding-001 и поставляет их в виде двоичных 256-мерных векторов Int8 (guide-chunks.i8, 335 KB в формате gzip).
Как офлайн-инструмент командной строки без ключа API проецирует запрос пользователя в то же самое векторное пространство Gemini? Поскольку запросы агентов почти всегда состоят из 2–5 слов, нам не нужен трансформер во время выполнения. Нам нужна только таблица поиска векторов для известных слов (table) и умный способ их суммирования. Во время выполнения весь конвейер TensorFlow.js размером 23 МБ сворачивается в цикл for из семи строк в static-embedder.ts:
// Each word's weight and Int8 scale are pre-folded into `scales[i]`
for (const [i, f] of enc) {
  const wt = scales[i] * f;
  const offset = i * 256;
  for (let k = 0; k < 256; k++) {
    out[k] += wt * table[offset + k];
  }
}
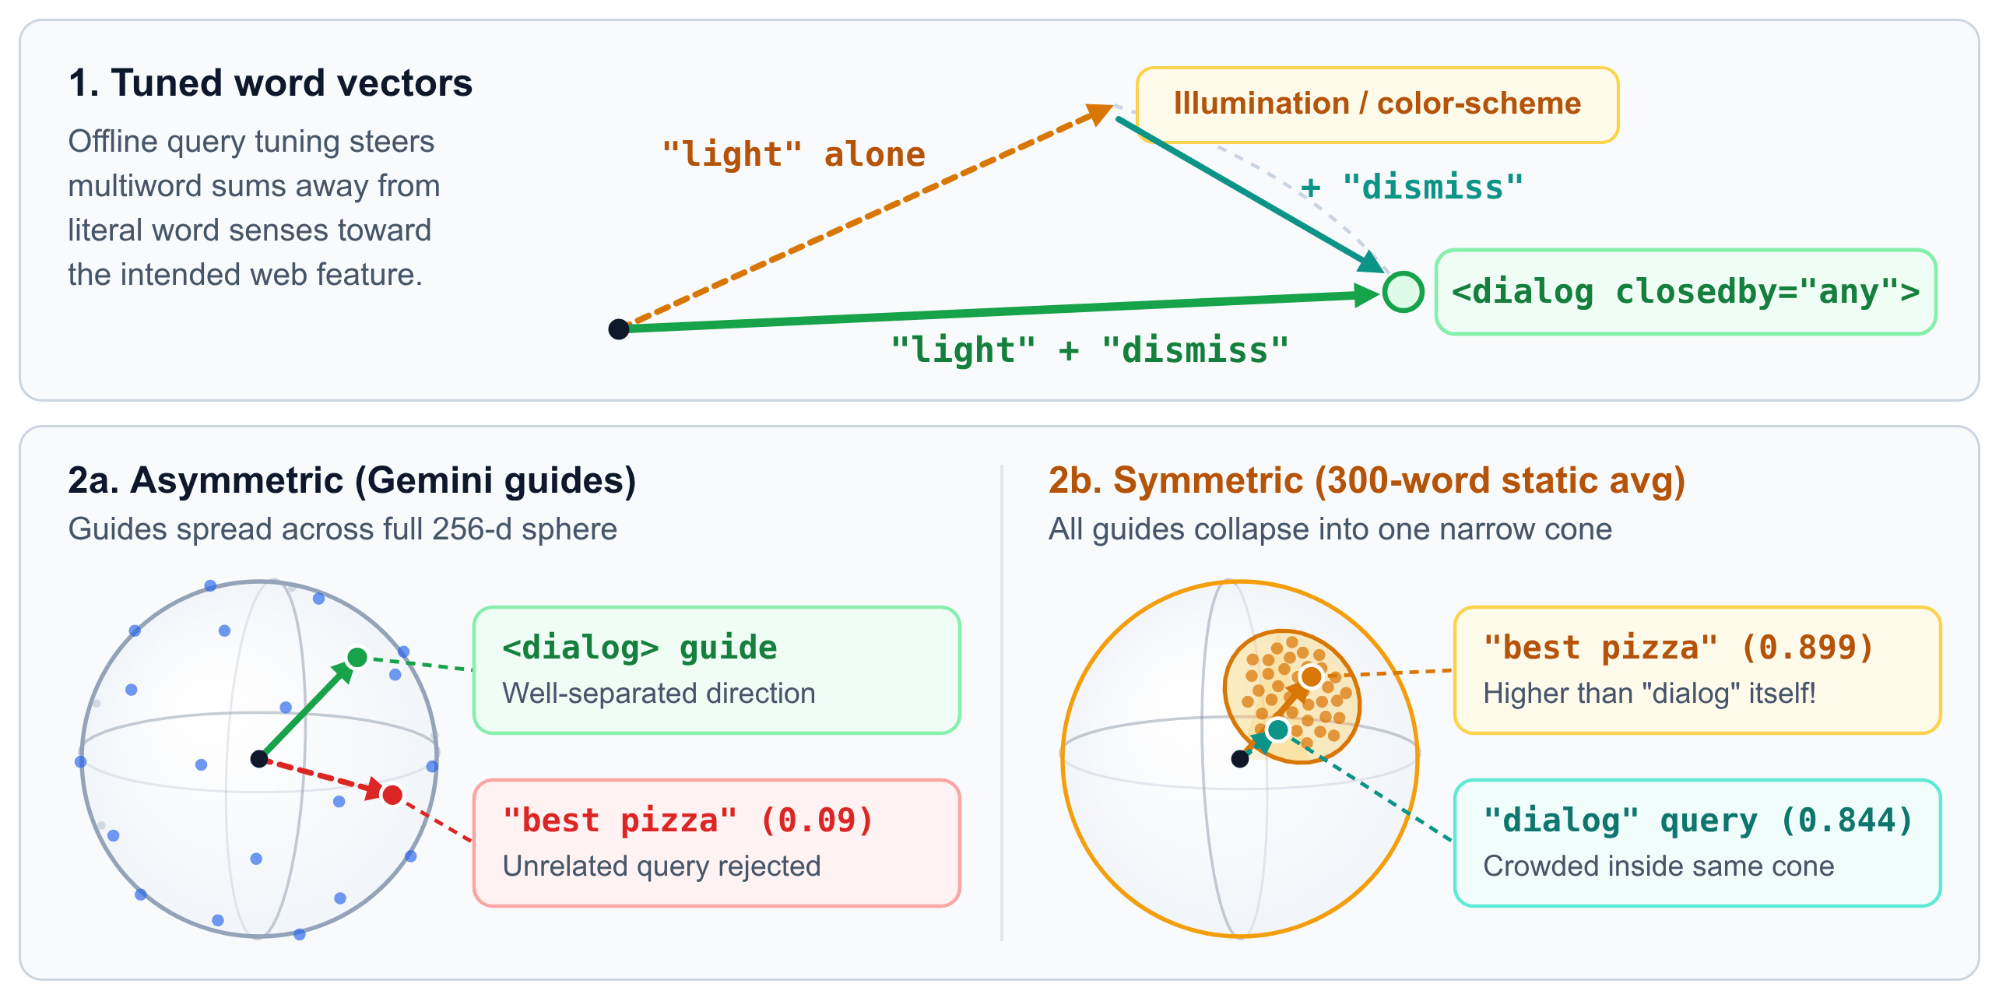
Чтобы создать таблицу подстановки (train-query-words.ts), мы взяли словарь из 29 165 слов (в котором современные веб-термины, такие как fetchpriority, light-dismiss, popover и scrollytelling, являются отдельными целыми словами), встроили их с помощью gemini-embedding-001 и настроили векторы слов в офлайн-режиме по 33 000 реальных веб-запросов, чтобы многословные комбинации попадали в нужное место (например, "light" + "dismiss" указывает на <dialog closedby="any">, а не на освещение или цветовые схемы). Сжатый до Int8 (query-words.i8), весь файл таблицы поиска занимает 5.3 MB в формате GZIP.
Почему бы не использовать эту статическую таблицу поиска, чтобы также встроить руководства и пропустить этап облачной сборки? Мы попробовали этот подход, но он не сработал для целых абзацев. Суммирование трех слов из запроса дает точный результат, но усреднение сотен слов из руководства приводит к тому, что все руководства оказываются в узком конусе рядом с общим средним значением для английского языка. Дошло до того, что косинусное сходство между "best pizza in new york" и руководством по dialog составило 0.899, что выше, чем у самого запроса "dialog" (0.844). Сопоставление статических запросов из трех слов (query-words.i8) с эмбеддингами руководств, созданными полной моделью Gemini (guide-chunks.i8), обеспечивает точность на уровне облачных решений, а запросы выполняются офлайн за 30 мкс.
Результаты всех трех поколений
На разных этапах выпуска показатель Hit@K вырос с 78,2 % при встраивании целых документов до 95,4 % при использовании статического инструмента встраивания Int8 (по сравнению с 96,9 % при использовании облачного API gemini-embedding-001):
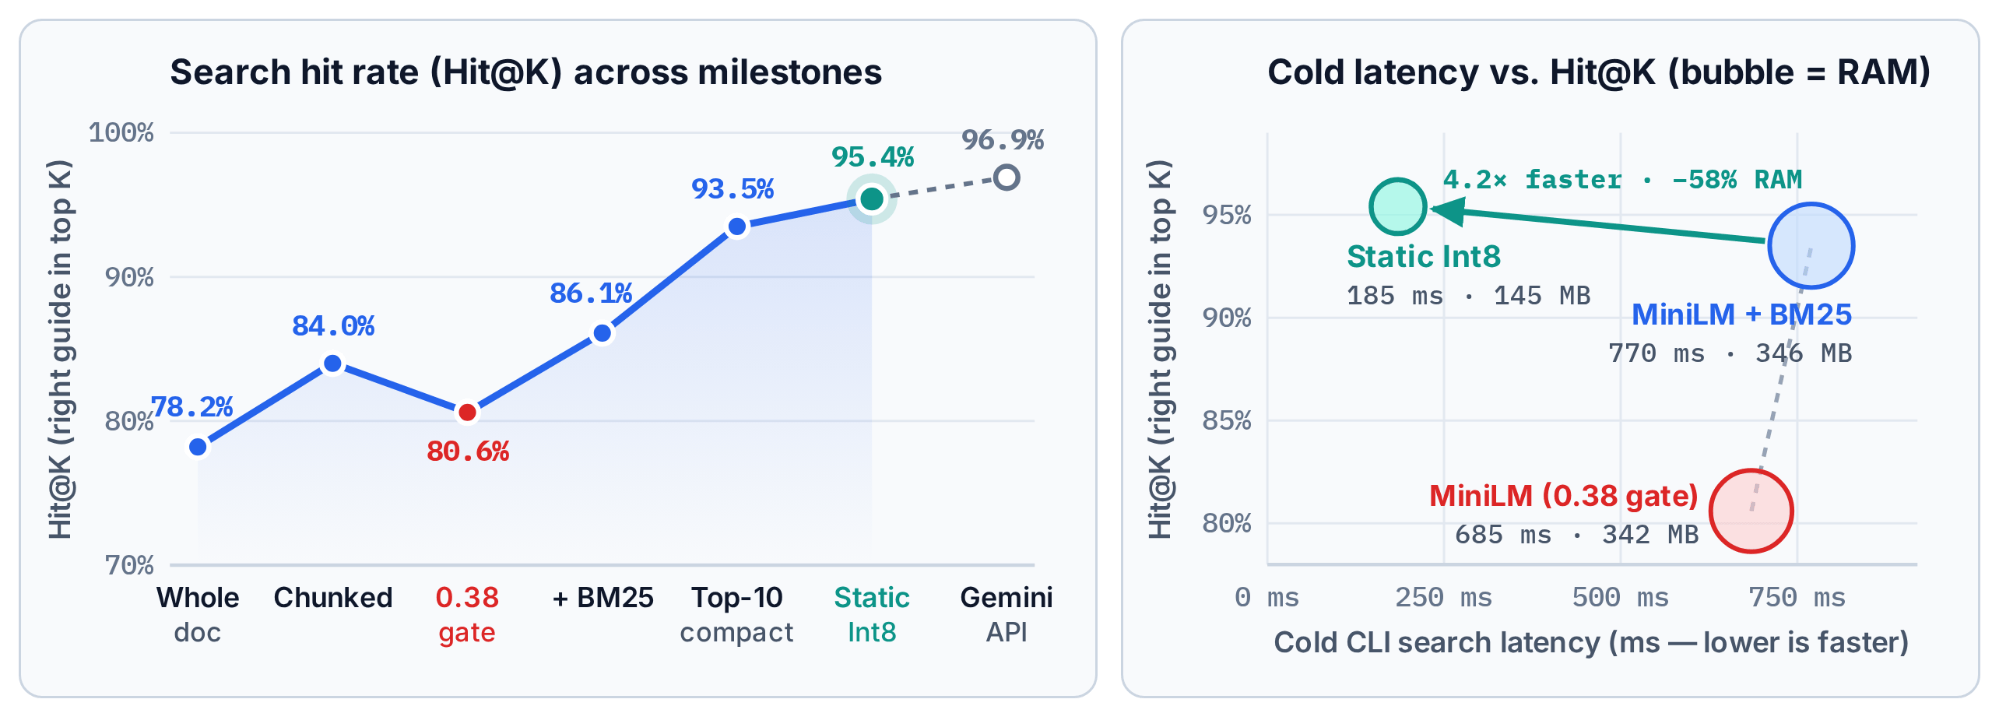
Вот как выглядят три поколения после внедрения статического встраивателя:
А если вы запустите тот неработающий запрос Codex, который мы рассматривали ранее,
npx modern-web-guidance@latest search "confirm destructive action"
Руководство dialog снова появится вверху списка.
Вы можете изучить интерактивные диаграммы по всем этапам, длине запросов и горизонтам K на нашей панели качества поиска.
Код – это просто, а вот измерения – это работа
Агент может за несколько минут написать скрипт для ранжирования BM25 или дистилляции векторных представлений слов. Генерация вариантов реализации больше не является узким местом. Понять, действительно ли изменение помогло (или незаметно сломало 9 % поисковых запросов, как это было с 0.38), – это почти вся работа.
Вот как мы подошли к этой системе:
- Определите главную цель и вложите средства в систему отслеживания, а не в отдельную реализацию. Мы потратили гораздо больше времени на создание
pnpm benchmark:rag, отбор 5000 реальных запросов и калибровку автоматической оценки по сравнению с оценками людей, чем на написание любого ретривера. - Создайте рубрику, по которой вы и ваши агенты будете оценивать качество, и ожидайте, что она будет развиваться, как только попадет в реальные данные. Такой подход часто называют "сначала оценка", но это верно лишь наполовину. В первый же день можно написать базовые проверки с известными ответами, но невозможно разработать хорошую рубрику в вакууме, не изучив реальные ошибки. Шанкар и другие авторы называют это смещением критериев в статье Who Validates the Validators? (Кто проверяет проверяющих?). Когда мы увидели, что агенты запускают резервные ответы
listна 1500 токенов, мы решили штрафовать за раздувание токенов наряду с отзывом. - Имея надежные измерения, активно экспериментируйте с различными реализациями и позвольте табло урегулировать споры об архитектуре. Когда тест оценивает 5000 запросов за секунды,вам не нужно спорить в PR о том, может ли цикл
Int8из 7 строк превзойти трансформер размером 23 МБ. Попробуйте пять подходов за один день и выберите лучший.
Весь код (включая эмбеддер, дистиллятор и тестовую среду) является ПО с открытым исходным кодом, конечно.