


Yayınlanma tarihi: 12 Kasım 2026
Bu hafta, kodlama temsilcilerinin eski geçici çözümler yerine modern web platformu özelliklerini kullanmasına yardımcı olan açık kaynaklı bir beceri olan Modern Web Rehberi 1.0'ı kullanıma sunduk. Bu yayında, jetonlarınızı boşa harcamadan göreviniz için en alakalı kılavuzu bulan yerel arama motoru incelenmektedir.
Bir mühendise, kodlama temsilcisi için 1,7 MB Markdown metni içeren bir bilgi bankası oluşturduğunuzu söylerseniz size iki soru soracaktır:
- "Bu işlem, bağlam pencereme kaç jeton ekleyecek?"
- "Ne tür bir şişirilmiş vektör veritabanı gerekiyor?"
Son altı ayda yerel erişim motorumuzu üç kez yeniden oluşturduk. 507 MB boyutundaki C++ bağlamalarından TensorFlow.js kullanan 23 MB boyutundaki saf JavaScript'e, ardından sorgu yerleştirmenin 7 satırlık bir for döngüsü olduğu 7 MB boyutundaki bir pakete geçtik. Bu süreçte doğruluğu da artırdık.
Temsilci tabanlı RAG ve kademeli açıklama
200'den fazla HTML/CSS/Web API kılavuzu içeren 1,7 MB'lık Markdown metnini AGENTS.md modeline aktarmak pratik değildir. Aşamalı açıklama yöntemini tercih ediyoruz ancak Markdown dizininin büyük ölçekte jeton verimliliğini kaybedeceğini biliyoruz.
Bu sorunu çözmek için arama KSA'sı tarafından desteklenen ajan tabanlı RAG'yi kullanırız:
- Bekleme durumunda, temsilci yalnızca becerinin açıklamasını görür (~205 jeton). Açıklama, Anthropic'in beceri tetikleme yönergelerine uygun olduğundan temsilci, beceriyi ilgili ön uç görevlerinde çağırır.
- Ön uç görevlerinde temsilci, arama yapmak için CLI'yı kullanabilir:
modern-web-guidance search "animate height auto", 10 alakalı eşleşme (~530 jeton) elde eder. - Temsilci, rehberin tamamını (yaklaşık 800 jeton) almak için
modern-web-guidance retrieve animate-to-intrinsic-sizeskez çalışır. Artık uyumluluk, yedekler ve teknikle ilgili en iyi uygulama yöntemleriyle donatılmıştır.
Neden MCP sunucusu veya web araması yerine CLI becerisi kullanmalısınız?
- MCP araçları, jetonları boşa harcar veya güvenilir olmayan tetikleme mekanizmalarına sahiptir (dinamik araç keşfi nedeniyle). Beceri açıklamamız, etkililik açısından optimize edilmiştir ve temsilcinin yalnızca uygun olduğunda rehberlikten yararlanmasını sağlar.
- Yerleşik web araması, güncel ve özel olarak seçilmiş
DO/DO NOTuygulama kalıpları yerine 2015 Stack Overflow yanıtlarını ve referans belgelerini gösterir. Ayrıca ağ üzerinden saniyeler sürer ve çevrimdışı korumalı alanlarda başarısız olur. Yerel CLI ise CPU'da milisaniyeler içinde çalışır.
1. nesil: 507 MB'lık C++ prototipi
Modern Web Rehberi'nin ilk sürümünde yerel bir RAG yığını kullanılıyordu: LanceDB, Apache Arrow ve onnxruntime-native ile Transformers.js.
Geliştirme makinesinde sorunsuz çalışıyordu ancak temsilci becerisi için pek uygun değildi:
- Bir projeye beceri eklediğinizde (veya bir temsilci bunu
npxile çağırdığında), mimariye bağlı.nodeikili dosyalarını indiren birnpm installveya bulut korumalı alanlarında rutin olarak başarısız olannode-gypC++ derlemesini beklemeniz gerekmez. - Ayıklanan
node_modulesdizini 507 MB boyutundaydı.
2. nesil: TensorFlow.js'yi 23 MB'a düşürme
Yerel derleme olmadan, Node'un çalıştığı her yerde anında yürütme istiyorduk. Bu nedenle Nisan ayında yerel yığını, @tensorflow/tfjs üzerinde all-MiniLM-L6-v2 çalıştıran saf JavaScript CPU motoruyla değiştirdik:
- esbuild'de
onnxruntime-nodeshimmed out ve Hugging Face tokenizer'ı küçük bir ağaç içi BERT WordPiece tokenizer ile değiştirildi (0 jeton kimliği uyuşmazlığı). - Kaynak haritasını inceledikten sonra
@tensorflow/tfjs-backend-cpu'nin 400'den fazla modülünü MiniLM'nin kullandığı 26 çekirdeğe budayarak JS motorunu 6 MB'tan 830 KB'a küçülttük. - Derleme zamanında gzip ile sıkıştırılmış vektörler ve yaklaşık 200 rehberin tamamında bellek içi
<1 msnokta çarpım taraması için LanceDB'yi bıraktık. - Yerleştiriciyi bir
import()çağrısının arkasına yerleştirin. Böyleceretrieveveliston milisaniyeden kısa sürede tamamlanır.
Bu sayede npm paketi, çalışma zamanı bağımlılığı olmadan 23 MB'a düşürüldü. Bu özelliği kullanıma sunduk ve temsilciler bu özellik üzerinden yaklaşık 750.000 arama yaptı.
MiniLM, üretimde nerede bozuldu?
Birkaç ay sonra, temsilcilerin beceriyi yüklediği ancak yine de eski kod yazdığı yörüngelere baktık.
Bir Codex çalıştırmasında, bir geliştirici silme onayı istemi istedi. HTML <dialog closedby="any"> ile erişilebilir onay modalleri oluşturma hakkında kapsamlı bir kılavuzumuz var.
Temsilci doğru olanı yaptı ve şu aramayı gerçekleştirdi:
npx modern-web-guidance@latest search "confirm destructive action"
KSA, [] döndürdü. Temsilci de omuz silkip window.confirm() yazmış.
Neden boş döndü? Günlükleri ve yerleştirmeleri incelediğimizde iki bilgi alma boşluğu dikkatimizi çekti:
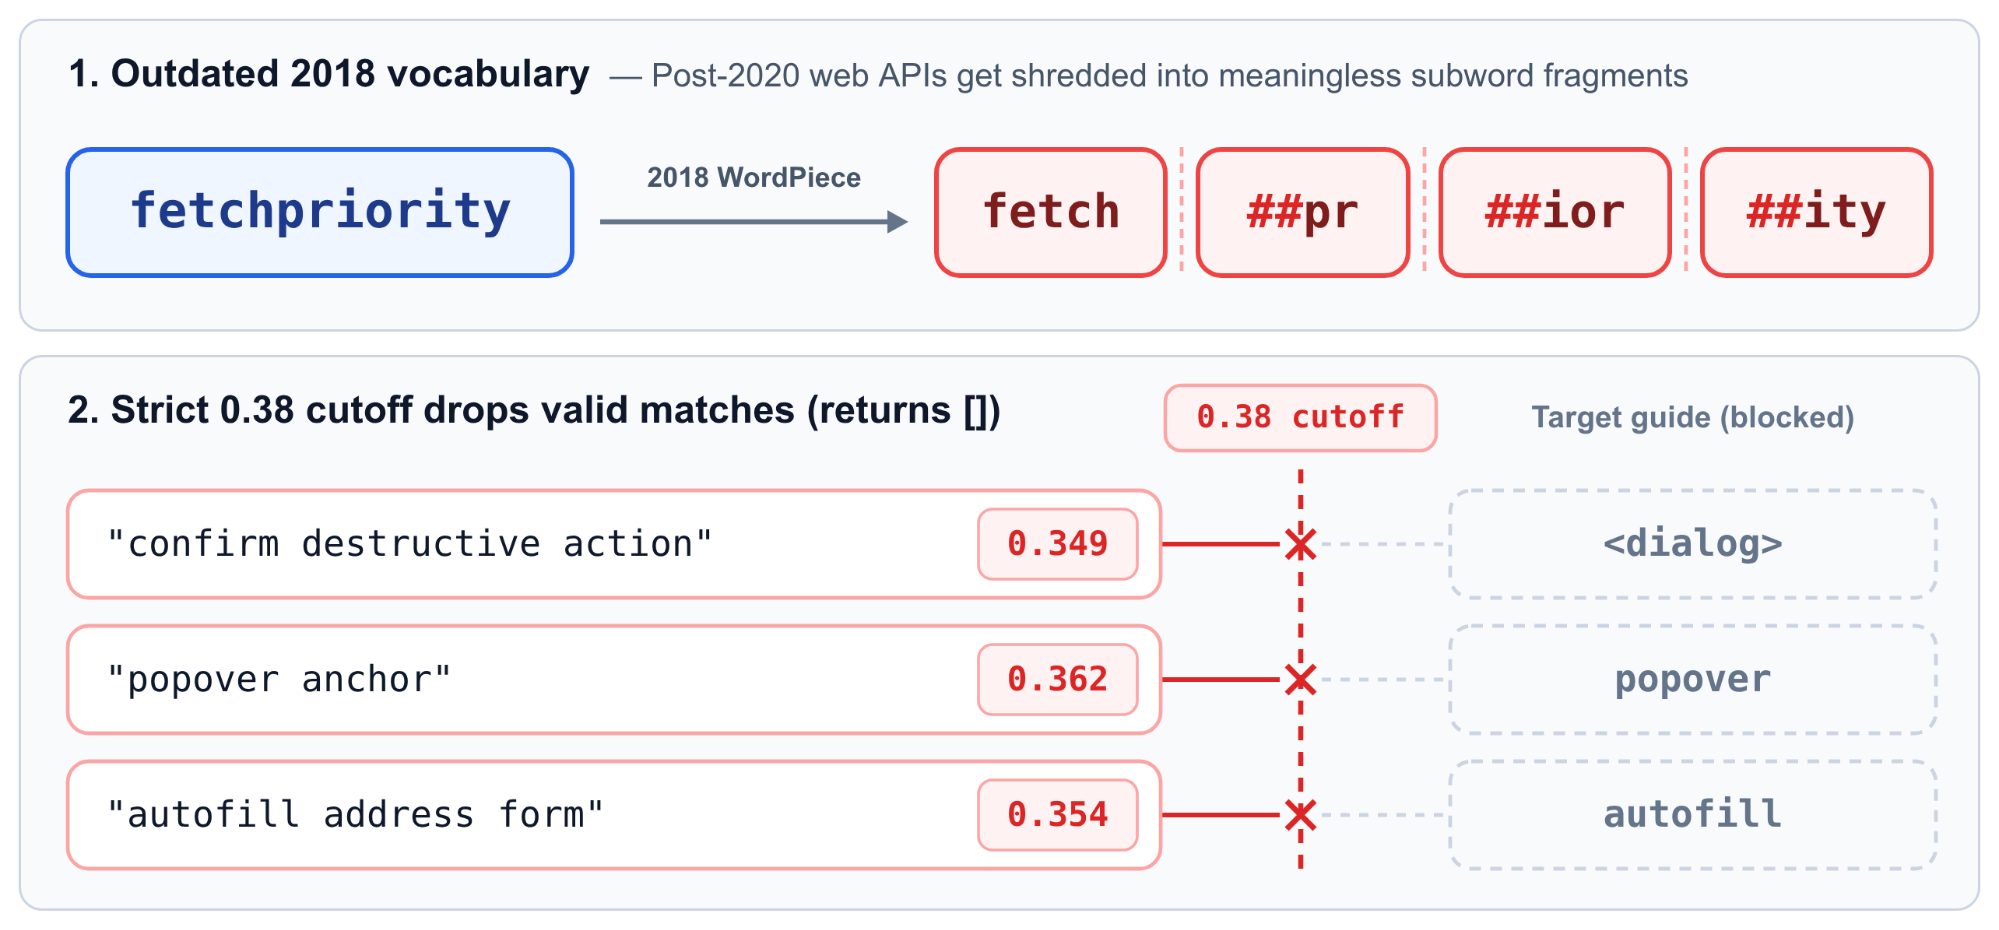
all-MiniLM-L6-v2, 2018-2020 yılları arasında eğitildiği için WordPiece kelime dağarcığı, 2020'den sonraki web API'lerinin varlığından haberdar değildir. Bir temsilcifetchpriority,popoverveyastartViewTransitioniçin arama yaptığında 2018 token oluşturucu,fetchprioritykelimesini dört anlamsız alt kelimeye ayırır:fetch·##pr·##ior·##ity.- Kapsam dışı sorguların rastgele kılavuzlar döndürmesini önlemek için önceki bir PR'de katı bir
0.38kosinüs benzerliği kesme noktası eklenmişti. MiniLM, 3 kelimelik"confirm destructive action"ifadesini"dialog"ile0.38değerinin üzerinde eşleştiremediği için (0.349puan alırken"popover anchor",0.362ve"autofill address form",0.354puan aldı) kapı, geçerli eşleşmeleri attı. Daha da kötüsü,search[]döndürdüğünde beceri talimatlarımız, temsilciyemodern-web-guidance list'ye geri dönmesini ve yaklaşık 200 rehber açıklamasının tamamını (yaklaşık 1.500 boşa harcanan jeton) bağlama eklemesini söylüyordu.
Bilgi getirme sorununu düzeltme: gerçek telemetri, karma arama ve 10 sonuç döndürme
Orijinal karşılaştırma ölçütümüz, kılavuzların kendisinden oluşturulan 850 yapay sorguydu. Bu sorgular, kılavuzdaki ifadelerle çok yakından eşleştiği için bu hataları yakalayamıyordu. Bu nedenle, kapsam dışında kalmayı seçen CLI telemetrisinden (yalnızca temsilcinin 2-5 kelimelik search bağımsız değişkenini günlüğe kaydeder, kullanıcı istemlerini veya depo kodunu asla kaydetmez ve DISABLE_TELEMETRY=1'e uyar) örneklenen yaklaşık 4.000 canlı arama ve Claude Code, Codex CLI ve Gemini CLI'daki gecelik temsilci değerlendirmelerinden elde edilen 1.029 arama etrafında yeni bir değerlendirme sistemi (pnpm benchmark:rag) oluşturduk.
Git geçmişimizi bu gizli sorgularla karşılaştırdığımızda, 0.38 kesme değerinin boş [] yanıtlarını 8 kat artırdığını gördük. Karşılaştırma ölçütünü belirledikten sonra yerleştirme modeline dokunmadan iki hızlı iyileştirme yaptık:
- Karma anahtar kelime + semantik arama: Yoğun vektörler tam API adlarını (
:user-invalid,showModal,details-name) bulanıklaştırırken anahtar kelime araması, temsilci API adını bilmediğinde amaç sorgularını kaçırır. Çoğul kök bulma özelliğine sahip, sıfır bağımlılıklı bir BM25 (biliyorsanız biliyorsunuzdur) anahtar kelime dizini ekledik, her kılavuzunweb-feature-idsdizine ekledik ve BM25'i anlamsal sıralamayla birleştirdik. Artıksearch, yalnızca hem semantik benzerlik<0.30hem de BM25'te sıfır anahtar kelime isabeti olduğunda[]döndürür. - 5 ayrıntılı sonuç yerine 10 kısa sonuç: Beceri talimatlarında, temsilcilere
similarityvetokenCountdeğerlerini yoksaymaları zaten söylenmişti. Kullanılmayan alanları kaldırarak 10 kompakt{id, description}sonucunu, 5 ayrıntılı sonuçla aynı ~530 jeton bütçesine sığdırabiliriz:
// Before: 5 verbose results (~105 tokens each = ~525 tokens)
{
  "id": "dialog",
  "category": "html",
  "description": "Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby.",
  "featuresUsed": ["dialog", "dialog-closedby"],
  "tokenCount": 780,
  "similarity": 0.49
}
// After: 10 compact results (~53 tokens each = ~530 tokens)
{"id":"dialog","description":"Build accessible modal and non-modal dialogs with native <dialog>, showModal(), and closedby."}
Bu iki değişiklik, ayrı tutulan telemetri sorgularındaki arama isabet oranımızı %80,6'dan %94,7'ye çıkardı. Bu oran, Hit@K (beklenen kılavuzun ilk K sonuçta görünüp görünmediği) olarak ölçüldü.
3. nesil: Önceden hazırlanmış yerleştirmeler ve 7 satırlık for döngüsü
94.7% isabet oranında bile telemetrimiz bariz bir uyumsuzluk gösterdi: Canlı temsilci aramalarının %86, 7'si yalnızca 2 ila 5 kelime uzunluğundaydı (medyan: 3 kelime). Temsilciler 3 kelimelik bir ifadeyi her aradığında Node, TensorFlow.js'yi başlatıyor, 22, 6 MB'lık bir nöral ağı ayrıştırıyor ve 770 ms soğuk başlatma gecikmesi ile 346 MB maksimum RAM kullanıyordu.
Nöral ağ olmadan 3 kelimelik sorguları yerleştirmenin daha basit bir yolu olup olmadığı sorulduğunda Antigravity ajanımız, bilinmeyen bir dizi ML damıtma tekniği önerdi: Model2Vec, Tokenlearn, Matryoshka boyutları, Adagrad. (Teknik ayrıntıları öğrenmek isterseniz arama kalitesi sayfamızda daha fazla bilgi bulabilirsiniz.)
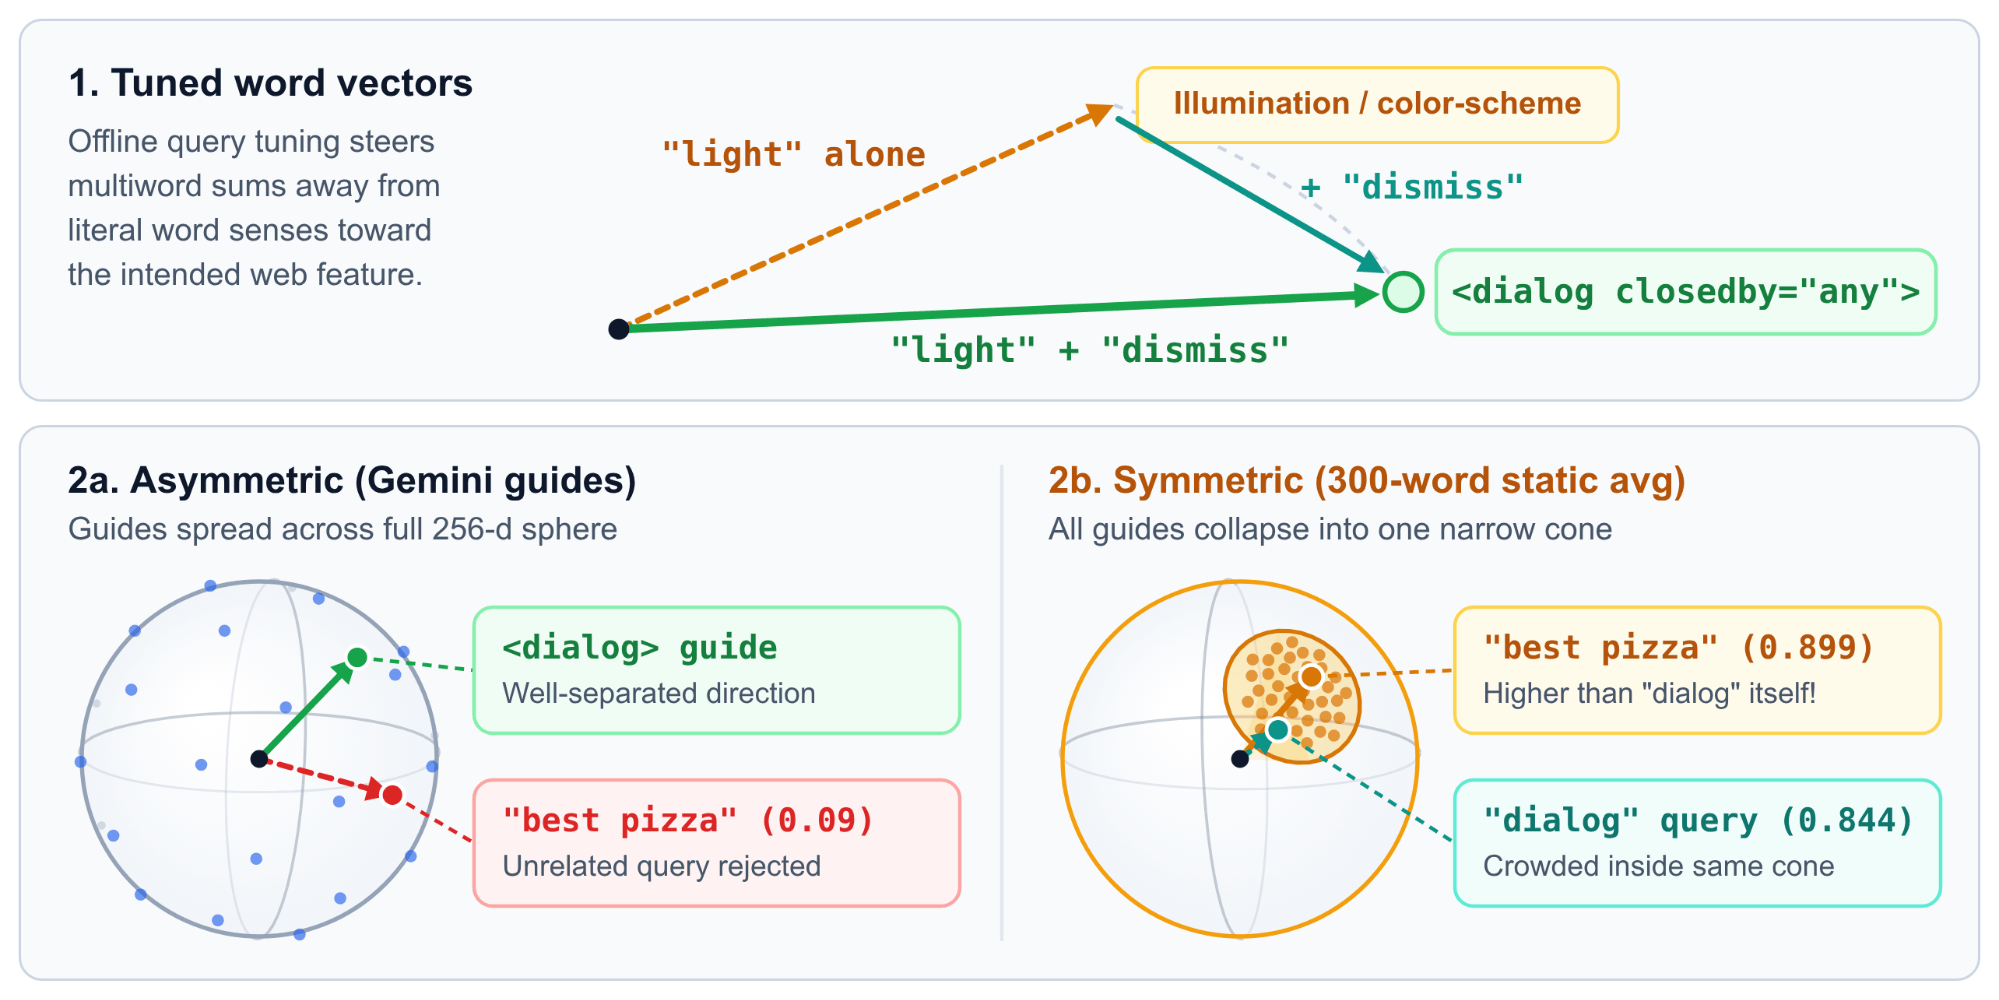
Standart yerel RAG, hem dokümanları hem de sorguları kullanıcının CPU'sundaki aynı küçük model üzerinden işlemeye zorlar. Ancak npm sürümü yayınladıktan sonra yaklaşık 200 kılavuzumuz değişmez. Bu nedenle, bunları küçük bir 2018 modeliyle yerleştirmek için bir neden yoktur. Bunun yerine embed-guide-chunks.ts, tüm kılavuz vektörlerimizi yayınlama sırasında gemini-embedding-001 kullanarak bulutta önceden hazırlar ve bunları ikili 256 boyutlu Int8 vektörleri (guide-chunks.i8, 335 KB gzip ile sıkıştırılmış) olarak gönderir.
Çevrimdışı ve API anahtarı olmayan bir CLI, kullanıcının canlı sorgusunu aynı Gemini vektör uzayına nasıl yansıtır? Temsilci sorguları neredeyse her zaman 2 ila 5 kelimeden oluştuğu için çalışma zamanında dönüştürücüye ihtiyacımız yoktur. Bilinen kelimeler (table) için vektörlerin arama tablosuna ve bunları toplamanın akıllı bir yoluna ihtiyacımız var. Çalışma zamanında, 23 MB'lık TensorFlow.js ardışık düzeninin tamamı static-embedder.ts dilinde 7 satırlık bir for döngüsüne daraltılır:
// Each word's weight and Int8 scale are pre-folded into `scales[i]`
for (const [i, f] of enc) {
  const wt = scales[i] * f;
  const offset = i * 256;
  for (let k = 0; k < 256; k++) {
    out[k] += wt * table[offset + k];
  }
}
Bu arama tablosunu (train-query-words.ts) oluşturmak için 29.165 kelimelik bir sözlük (fetchpriority, light-dismiss, popover ve scrollytelling gibi modern web terimlerinin bağımsız tam kelimeler olduğu) kullandık, bunları gemini-embedding-001 ile yerleştirdik ve kelime vektörlerini 33.000 gerçek web sorgusuna göre çevrimdışı olarak ayarladık. Böylece çok kelimeli kombinasyonlar doğru noktaya ulaştı (örneğin, "light" + "dismiss", aydınlatma veya renk şemalarına değil, <dialog closedby="any">'ye işaret eder). Int8 (query-words.i8) boyutuna sıkıştırılan arama tablosunun tamamı 5.3 MB gzip biçimindedir.
Neden bu statik arama tablosunu kılavuzları yerleştirmek için de kullanmıyor ve bulut derleme adımını atlamıyorsunuz? İlk olarak bunu denedik ancak tam paragraflarda başarısız oldu: 3 sorgu kelimesini toplamak keskin kalıyor ancak tam bir kılavuzdaki yüzlerce kelimenin ortalamasını almak, her kılavuzu genel İngilizce ortalamasına yakın dar bir koniye daraltıyor (öyle ki "best pizza in new york", dialog kılavuzumuza karşı 0.899 kosinüs benzerliği puanı aldı. Bu, 0.844 ile "dialog" sorgusunun kendisinden daha yüksek!). 3 kelimelik statik sorgu aramalarını (query-words.i8) tam model Gemini kılavuz yerleştirmeleriyle (guide-chunks.i8) eşleştirmek, sorgular 30 µs içinde çevrimdışı çalışmaya devam ederken bulut düzeyinde doğruluk sağlıyor.
Üç neslin puan tablosu
Sürüm kilometre taşlarımızda Hit@K, tüm doküman yerleştirmeleriyle %78,2'den statik Int8 yerleştiriciyle %95,4'e yükseldi (bulut gemini-embedding-001 API'si ile %96,9'a kıyasla):
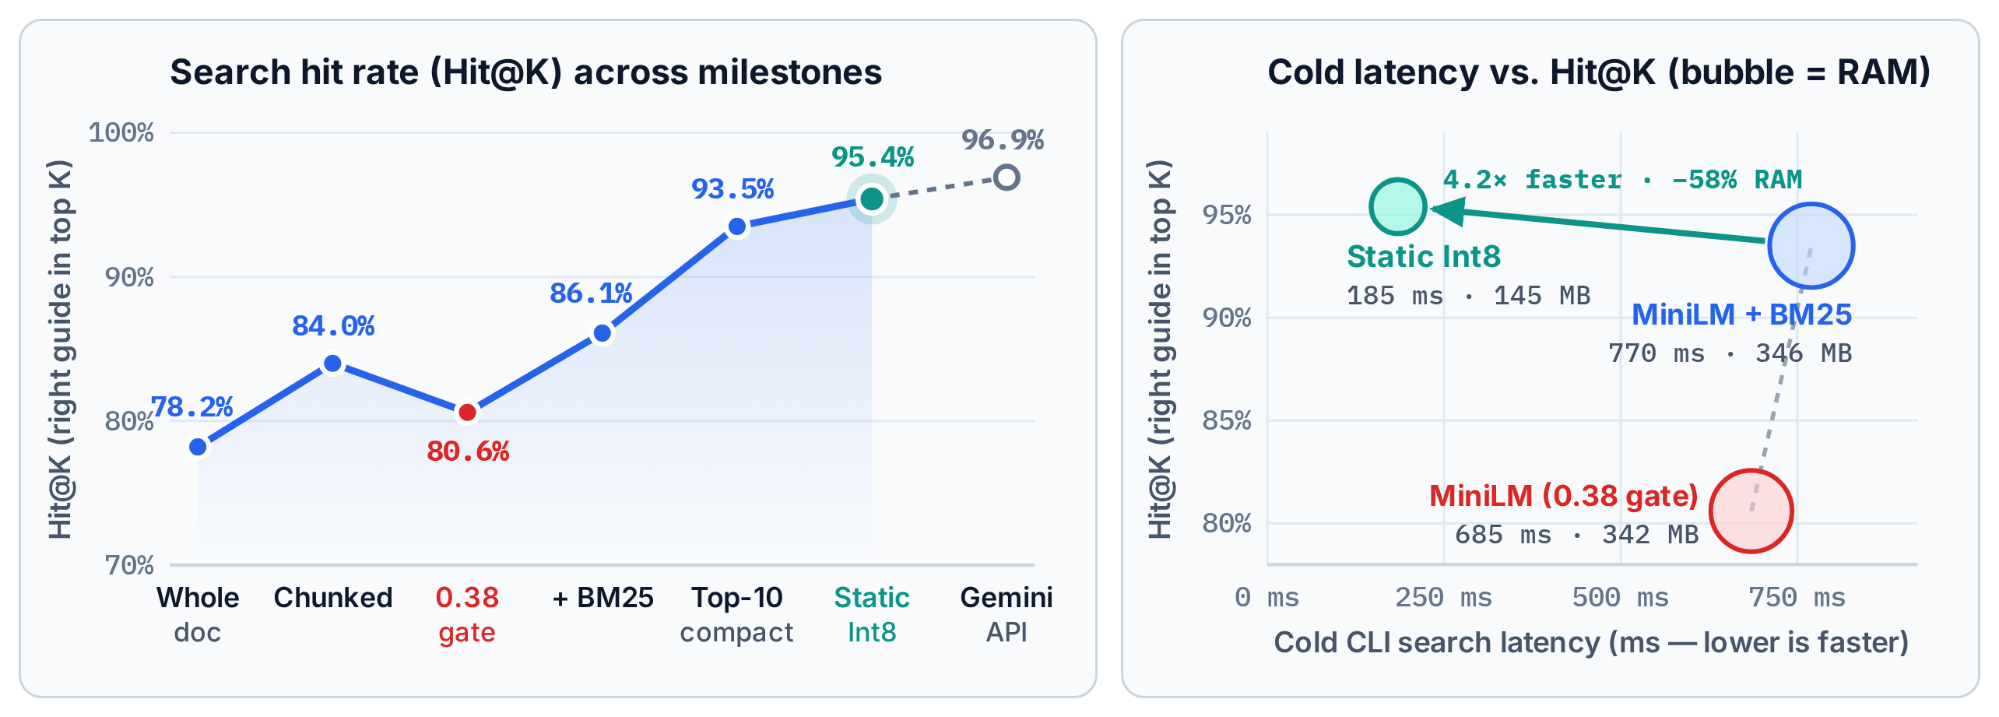
Statik yerleştiriciyi kullanıma sunduktan sonra üç neslin karşılaştırması şu şekildedir:
Daha önce çalıştırdığınız bozuk Codex sorgusunu tekrar çalıştırırsanız:
npx modern-web-guidance@latest search "confirm destructive action"
dialog rehberi, listenin en üstüne geri döner.
(Tüm aşamalar, sorgu uzunlukları ve K ufukları genelindeki etkileşimli grafikleri Arama Kalitesi Kontrol Panelimizde inceleyebilirsiniz.)
Kod yazmak kolaydır, asıl iş ölçümdür
Bir temsilci, dakikalar içinde BM25 sıralayıcı veya kelime vektörü damıtma komut dosyası yazabilir. Aday uygulamalar oluşturmak artık darboğaz oluşturmuyor. Bir değişikliğin gerçekten işe yarayıp yaramadığını (veya bizim 0.38 kapımızda olduğu gibi üretim aramalarının %9'unu sessizce bozup bozmadığını) bilmek neredeyse işin tamamını oluşturur.
Bu sistemi şu şekilde tasarladık:
- Ana hedefi tanımlayın ve tek bir uygulama yerine ölçüm altyapısına yatırım yapın.
pnpm benchmark:ragoluşturmak, 5.000 gerçek sorguyu seçmek ve otomatik notlandırmamızı insan derecelendirmelerine göre kalibre etmek için herhangi bir bilgi getirici yazmaktan çok daha fazla zaman harcadık. - Sizin ve temsilcilerinizin kaliteyi nasıl değerlendireceğine dair bir puanlama anahtarı oluşturun ve gerçek dünya verileriyle karşılaştığında bu anahtarın gelişmesini bekleyin. Buna "önce ölçüm" denir ancak bu yalnızca kısmen doğrudur: İlk gün bilinen yanıt kontrollerini yazabilirsiniz ancak gerçek hataları incelemeden iyi bir değerlendirme ölçeği tasarlayamazsınız (Shankar ve diğerleri, Who Validates the Validators? adlı makalede buna ölçüt kayması adını vermiştir). Temsilcilerin 1.500 jetonluk
listyedekleri tetiklediğini görmek,bizi geri çağırmanın yanı sıra jeton şişkinliğini de cezalandırmaya zorladı. - Güvenilir ölçümler yapıldıktan sonra farklı uygulamalarla agresif bir şekilde denemeler yapın ve mimari tartışmaları puan tablosuna bırakın. Bir karşılaştırma ölçütü 5.000 sorguyu saniyeler içinde değerlendirdikten sonra, PR'larda 7 satırlık bir
Int8döngüsünün 23 MB'lık bir dönüştürücüyü geçip geçemeyeceğini tartışmanıza gerek kalmaz. Bir öğleden sonra beş yaklaşım deneyip kazananı seçin.
Kodun tamamı (yerleştirici, damıtıcı ve karşılaştırma donanımı dahil) elbette açık kaynaklıdır.