


เผยแพร่เมื่อวันที่ 30 เมษายน 2026
AI ในตัวช่วยให้เว็บไซต์หรือเว็บแอปพลิเคชันทำงานที่ทำงานด้วยระบบ AI ได้โดยไม่ต้องติดตั้งใช้งาน จัดการ หรือโฮสต์โมเดลด้วยตนเอง คุณอาจพบว่าการเปลี่ยนจากเวอร์ชันเดโมไปเป็นฟีเจอร์ที่พร้อมใช้งานจริงเป็นเรื่องที่ท้าทาย เอกสารนี้ครอบคลุมข้อควรพิจารณาด้านเทคนิคและ UX เพื่อช่วยให้คุณหลีกเลี่ยงข้อผิดพลาดที่พบบ่อย
คำแนะนำส่วนใหญ่ใช้กับ AI API ในตัวทั้งหมด โดยมีข้อยกเว้นดังนี้
เตรียมโมเดลในเวลาที่เหมาะสม
สิ่งที่ควรทำ: เริ่มต้นเซสชันทันทีที่คุณระบุความตั้งใจของผู้ใช้ในการใช้ฟีเจอร์ AI ได้อย่างชัดเจน เช่น เมื่อผู้ใช้ไปยังแพลตฟอร์มเครื่องมือ AI ที่เกี่ยวข้อง วางเมาส์เหนือพื้นที่ทำงาน AI หรือโต้ตอบกับ UI โดยรอบของฟีเจอร์ การเตรียมเซสชันล่วงหน้าช่วยให้โมเดลโหลดลงในหน่วยความจำอย่างเงียบๆ ในเบื้องหลังขณะที่ผู้ใช้กำลังตั้งค่างาน ซึ่งจะช่วยขจัดเวลาในการตอบสนองจากการเริ่มระบบแบบ Cold Start ที่หลีกเลี่ยงได้ พยายามก้าวล้ำไปอีกขั้นด้วยการเริ่มงาน AI ที่มีแนวโน้มมากที่สุดถัดไปทันทีที่คุณเริ่มแสดงผลลัพธ์ปัจจุบัน เช่น หากฟีเจอร์ได้รับการออกแบบมาเพื่อการใช้งานซ้ำๆ
ข้อควรหลีกเลี่ยง: อย่ารอให้ผู้ใช้คลิก "สร้าง" เพื่อเริ่มต้นเซสชัน เว้นแต่จำเป็น ซึ่งจะทำให้เกิดความล่าช้าในการเริ่มทำงานแบบ Cold Start เนื่องจากโมเดลต้องโหลดลงในหน่วยความจำและเตรียมไปป์ไลน์การดำเนินการก่อน
ตั้งค่าพรอมต์เริ่มต้นระหว่างการสร้าง
คำแนะนำต่อไปนี้มีไว้สำหรับ Prompt API
สิ่งที่ควรทำ: ระบุคำสั่งของระบบในระหว่างการเริ่มต้นเซสชันเพื่อเพิ่มความเร็วของพรอมต์แรก
ไม่ควรทำ: เริ่มต้นด้วยเซสชันที่ว่างเปล่าและส่งคำสั่งของระบบเป็นส่วนหนึ่งของการเรียก prompt() ครั้งแรก ซึ่งจะเพิ่มเวลาในการตอบสนองเนื่องจากเป็นการบังคับให้โมเดลประมวลผลคำสั่งเหล่านั้นในวินาทีสุดท้าย
// ✅ DO: Create the session as early as possible (warm up the model early) and
// use initialPrompts for system instructions in the create call
const session = await LanguageModel.create({
  initialPrompts: [
    {
      role: 'system',
      content: 'You are a helpful assistant specialized in code reviews.'
    }
  ]
});

// Once the user triggers the AI feature
const review = await session.prompt(`Review the following code:\n\n${code}`);

// ❌ DON'T: Send instructions using prompt() after creation
// const slowerSession = await LanguageModel.create();
// await slowerSession.prompt(`You are a helpful assistant specialized in code reviews.\n\nReview the following code:\n\n${code}`); // Higher latency
โคลนเซสชันสำหรับงานที่ทำซ้ำๆ
คำแนะนำต่อไปนี้มีไว้สำหรับ Prompt API
สำหรับ Prompt API แต่ละเซสชันจะติดตามบริบทของการสนทนา โดยพิจารณาการโต้ตอบก่อนหน้าทั้งหมด เนื่องจากโคลนจะรับช่วงทุกอย่างจากเซสชันหลัก ซึ่งรวมถึงพรอมต์เริ่มต้นและประวัติการโต้ตอบทั้งหมดจนถึงจุดที่โคลน ให้จัดโครงสร้างการใช้งานเพื่อรับช่วงเฉพาะสิ่งที่คุณต้องการเท่านั้น
สิ่งที่ควรทำ
- สร้างเซสชันพื้นฐาน: หากต้องการจัดการงานที่ไม่เกี่ยวข้องอย่างมีประสิทธิภาพ ให้สร้างเซสชันพื้นฐานที่มีเฉพาะคำสั่งของระบบและไม่มีบริบทการสนทนาก่อนหน้า
- โคลนข้อมูลพื้นฐาน: ใช้
clone()ในเซสชันฐานนั้นสำหรับงานใหม่เพื่อประหยัดค่าใช้จ่ายในการแยกวิเคราะห์คำสั่งของระบบอีกครั้ง ซึ่งจะช่วยให้คุณสร้างการสนทนาคู่ขนานหรือรีเซ็ตงานกลับไปเป็นค่าพื้นฐานได้
สิ่งที่ไม่ควรทำ
- อย่าใช้เซสชันเดียวกันซ้ำสำหรับงานที่ไม่เกี่ยวข้อง และหลีกเลี่ยงการโคลนเซสชันที่มีประวัติการโต้ตอบที่ไม่จำเป็นอยู่แล้ว ทั้ง 2 รูปแบบอาจทำให้บริบทก่อนหน้าที่ไม่เกี่ยวข้องรบกวนงานปัจจุบันของคุณ
- อย่าเรียกใช้
create()ซ้ำๆ ด้วยคำสั่งของระบบที่เหมือนกัน ให้ใช้รูปแบบการโคลนแทนเพื่อเพิ่มประสิทธิภาพ
// ✅ DO: Create a baseline session and clone it for each new task
const baseSession = await LanguageModel.create({
  initialPrompts: [{
    role: 'system',
    content: 'You are a technical editor...',
  }],
});

// Clone the base session once for the first task
const task1 = await baseSession.clone();
const response1 = await task1.prompt("Review this first draft...");
// ... Repeat the cloning pattern for subsequent independent tasks
// Each task starts fresh from the baseline system instructions

// ❌ DON'T:
// Bad performance pattern: repeated create() calls for identical tasks.
// This forces the model to re-parse instructions every time, increasing latency.
// const sessionA = await LanguageModel.create({ initialPrompts: [...] });
// await sessionA.prompt("Task 1...");
// const sessionB = await LanguageModel.create({ initialPrompts: [...] });
// await sessionB.prompt("Task 2...");
// Bad quality pattern: reusing the same session for unrelated tasks.
// const session = await LanguageModel.create();
// await session.prompt("Analyze this financial report...");
// Unrelated task in the same session:
// await session.prompt("Now write a children's story...");
ทำลายเซสชันที่ไม่ได้ใช้
สิ่งที่ควรทำ: เรียกใช้ destroy() อย่างชัดเจนในเซสชันที่ไม่จำเป็นต้องใช้แล้ว เพื่อเพิ่มพื้นที่ว่างในหน่วยความจำเมื่อไม่ได้ใช้ฟีเจอร์นั้นอีกต่อไป หากใช้รูปแบบการโคลน ให้เก็บเซสชันฐานไว้และทำลายโคลนที่ไม่ต้องการอีกต่อไป
สิ่งที่ไม่ควรทำ: เปิดเซสชันขนาดใหญ่หลายเซสชันไว้พร้อมกัน แต่ละเซสชันจะใช้หน่วยความจำ ซึ่งทำให้เกิดการใช้ทรัพยากรโดยไม่จำเป็นและอาจกลายเป็นปัญหาได้ โดยปกติแล้ว ตัวเก็บขยะจะล้างเซสชันโดยอัตโนมัติ แต่การเรียกใช้ destroy() จะช่วยเพิ่มพื้นที่หน่วยความจำได้เร็วยิ่งขึ้น
// ✅ DO: Use the clone and destroy it immediately after
const clone = await baseSession.clone();
const response = await clone.prompt("Quick task...");
// Free memory right away: destry the clone, keep the baseSession
clone.destroy();
แสดงผลการตอบกลับแบบสตรีมมิงอย่างปลอดภัยและมีประสิทธิภาพ
คำแนะนำนี้ใช้กับ API ที่รองรับการสตรีม (Prompt, Summarizer, Writer, Rewriter และ Translator)
สิ่งที่ควรทำ: ถือว่าเอาต์พุต LLM ทั้งหมดเป็นเนื้อหาที่ไม่น่าเชื่อถือ ตรวจสอบเอาต์พุตที่รวมกันทั้งหมด ไม่ใช่แค่บางส่วน เนื่องจากโค้ดที่เป็นอันตรายอาจแยกออกจากการอัปเดตได้ ก่อนแสดงผล ให้ใช้ Sanitizer API หากรองรับ เพื่อหลีกเลี่ยงประสิทธิภาพที่ลดลง ให้ใช้โปรแกรมแยกวิเคราะห์ Markdown แบบสตรีมมิง เช่น streaming-markdown
ไม่ควร: ตั้งค่า innerHTML โดยตรงในการอัปเดตกลุ่มข้อมูลแต่ละครั้ง ซึ่งจะช้า โดยเฉพาะอย่างยิ่งเมื่อมีการจัดรูปแบบที่ซับซ้อน เช่น การไฮไลต์ไวยากรณ์ และเสี่ยงต่อการแทรก
import * as smd from "streaming-markdown";
// Set up virtual buffer and Sanitizer API
const sanitizer = new Sanitizer({
  allowElements: ['figure', 'figcaption', 'p', 'br', 'strong', 'em', 'img', 'a'],
  allowAttributes: {
    'loading': ['img'], 'decoding': ['img'], 'src': ['img'], 'href': ['a']
  }
});

// Create an off-screen fragment so the parser doesn't cause flicker
// or trigger XSS in the live DOM during the building process.
const buffer = new DocumentFragment();
const parser = smd.parser_new(buffer);

// Use sanitizer as a gatekeeper / cleaner function so we can combine it with the streaming Markdown parser
function syncSanitized(target, sourceFragment) {
  // .sanitize() returns a fresh, clean DocumentFragment
  const cleanFragment = sanitizer.sanitize(sourceFragment);
  // replaceChildren is the modern high-performance way to swap DOM content
  target.replaceChildren(cleanFragment);
}

// Streaming Logic
// `chunks` keeps track of the raw string (useful for logs/debug)
chunks += chunk;
// Let the parser build the DOM incrementally in the buffer.
// This is high-performance because the buffer is not live
smd.parser_write(parser, chunk);
// Use the Sanitizer API to port the content safely to the container.
syncSanitized(container, buffer);
เพิ่มประสิทธิภาพอินพุตเพื่อความเร็ว
สิ่งที่ควรทำ: ส่งเฉพาะสิ่งที่จำเป็นจริงๆ ให้กับโมเดล ตัดทุกอย่างที่ไม่เกี่ยวข้องกับงานที่ทำอยู่ออก สำหรับชุดข้อมูลขนาดใหญ่ ให้ระบุภาพรวมสั้นๆ และรายการที่เกี่ยวข้องที่เลือกมาจำนวนหนึ่ง
สิ่งที่ไม่ควรทำ: ส่งข้อความดิบที่ยังไม่ได้ประมวลผล ข้อมูลเมตาที่ไม่จำเป็น แท็ก HTML หรือรายการขนาดใหญ่ที่ยังไม่ได้กรองไปยัง API เวลาในการตอบสนองจะเพิ่มขึ้นอย่างมากตามขนาดอินพุต ซึ่งอาจทำให้ฟีเจอร์ AI ดูเหมือนใช้งานไม่ได้ในอุปกรณ์หลายเครื่อง
// ✅ DO: Send only relevant text
const cleanText = document.querySelector('#article').innerText;
const summary = await Summarizer.summarize(cleanText);

// ❌ DON'T: Send the entire DOM structure
// const dirtyText = document.querySelector('#article').innerHTML;
ใช้เอาต์พุตที่มีโครงสร้างเพื่อให้ได้ผลลัพธ์ที่คาดการณ์ได้
คำแนะนำต่อไปนี้มีไว้สำหรับ Prompt API
สิ่งที่ควรทำ: เมื่อต้องการให้โมเดลแสดงผลข้อมูลในรูปแบบที่เฉพาะเจาะจง ให้ใช้เอาต์พุตที่มีโครงสร้างโดยระบุช่อง responseConstraint เพื่อระบุสคีมา JSON ซึ่งจะช่วยให้มั่นใจได้ว่าเอาต์พุตจะคาดเดาได้ และช่วยให้คุณไม่ต้องทำการประมวลผลหลังการประมวลผลที่ซับซ้อนหรือการแยกวิเคราะห์ด้วยตนเอง
ไม่ควร: อาศัยคำสั่งภาษาธรรมชาติ (เช่น "เอาต์พุต JSON เท่านั้น") เพียงอย่างเดียว โมเดลอาจมีคำพูดที่ใช้คั่นเวลาในการสนทนาซึ่งทำให้โปรแกรมแยกวิเคราะห์ของคุณทำงานไม่ได้
// ✅ DO: Use a JSON Schema for predictable results
const schema = {
  type: "object",
  properties: {
    isTopicCats: { type: "boolean" }
  }
};

const result = await session.prompt(`Is this post about cats?\n\n${post}`, {
  responseConstraint: schema,
});
console.log(JSON.parse(result).isTopicCats);
แยกการสร้างออกจากข้อจำกัดด้านความยาว
คำแนะนำต่อไปนี้มีไว้สำหรับ Prompt API
สิ่งที่ควรทำ: ปล่อยให้โมเดลสร้างคำตอบอย่างเป็นธรรมชาติ แล้วใช้ตรรกะฝั่งไคลเอ็นต์เพื่อตัดข้อความให้พอดีกับ UI
ไม่ควร: บังคับใช้จำนวนอักขระสูงสุดที่เข้มงวด เช่น maxLength: 125 โดยใช้สคีมาเอาต์พุตที่มีโครงสร้าง เมื่อคำตอบของโมเดลยาวกว่าขีดจำกัดที่คุณตั้งไว้ โมเดลอาจเปลี่ยนไปใช้โทเค็นที่มีความหนาแน่นสูง เช่น ภาษาต่างประเทศหรืออีโมจิ เพื่อบีบอัดความหมาย ซึ่งส่งผลให้เอาต์พุตไม่มีความหมาย
/*  DO: Handle overflow using CSS */
.result {
  overflow: hidden;
  white-space: nowrap;
  text-overflow: ellipsis; /* Displays '…' */
}
// ❌ DON'T: Force length in the prompt
const result = await session.prompt("Write a bio in exactly 50 characters.");
แจ้งให้ผู้ใช้ทราบอยู่เสมอ
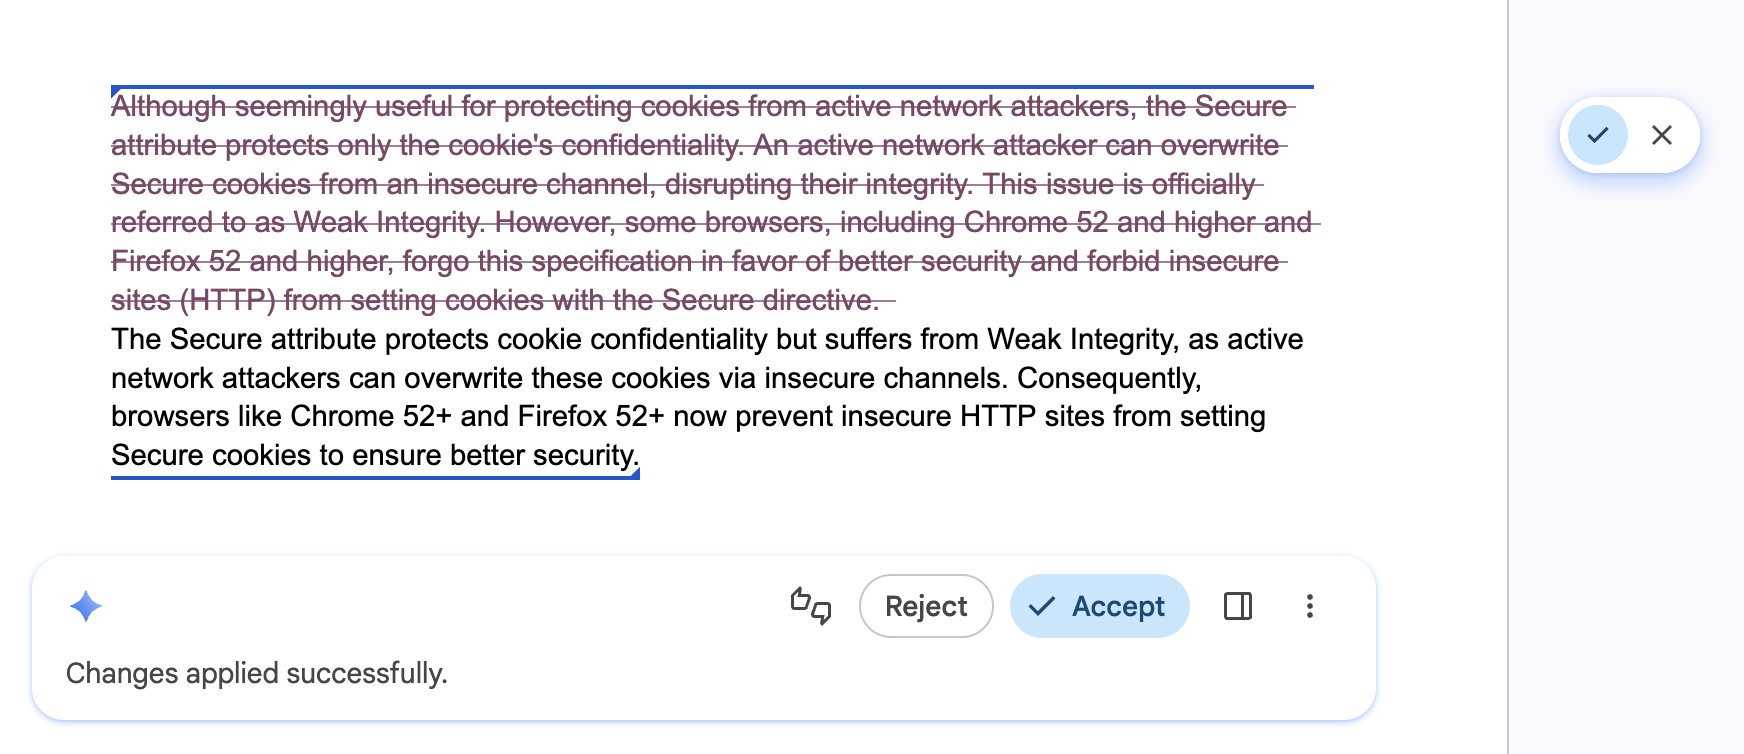
ควรทำ: ใช้ภาพเคลื่อนไหว ภาพชี้นำ และตัวบ่งชี้ความคืบหน้าเพื่อแจ้งให้ผู้ใช้ทราบ ทั้งนี้ขึ้นอยู่กับความซับซ้อนและระยะเวลาที่คาดไว้ของงาน แนวทางที่เหมาะสมที่สุดจะขึ้นอยู่กับ Use Case และความยาวที่คาดไว้ของเอาต์พุต API ลองดูไอเดียต่อไปนี้เป็นตัวอย่าง
- การสตรีมสำหรับเนื้อหาขนาดยาว: สำหรับสรุปหรือแชท การสตรีมจะสร้างเอฟเฟกต์เครื่องพิมพ์ดีดต่อโทเค็นโดยค่าเริ่มต้น ซึ่งจะให้ความรู้สึกเป็นธรรมชาติและให้ความคิดเห็นได้ทันที
- ไม่สตรีมมิงสำหรับงานสั้นๆ (หรืองานแบบไม่พร้อมกันที่ใช้เวลานาน): สำหรับเอาต์พุตสั้นๆ เช่น ข้อความแสดงแทน การไม่สตรีมมิงจะสร้าง UI ที่สวยงามยิ่งขึ้นได้ นอกจากนี้ยังช่วยให้มีเวลาเตรียมงาน AI ถัดไปในระหว่างที่งานปัจจุบันกำลังแสดงผล วิธีนี้ยังใช้ได้กับงานแบบอะซิงโครนัสหรือเบื้องหลังที่ใช้เวลานานกว่าด้วย หากผู้ใช้ไม่ถูกบล็อกในเอาต์พุตเพื่อดำเนินการต่อ ก็ไม่จำเป็นต้องสร้างเอาต์พุตอย่างเร่งด่วนในขณะที่เกิดขึ้น แสดงสัญญาณว่ากระบวนการกำลังดำเนินอยู่ใน UI
- การเปลี่ยนภาพสำหรับการอัปเดต: เมื่อแปลหรือเขียนข้อความใหม่ ให้ใช้ภาพเคลื่อนไหว เช่น การเปลี่ยนรูปแบบคำ
ไม่ควรทำ: อัปเดต UI โดยไม่มีสัญญาณภาพ
สอดคล้องกับโมเดลทางความคิดของผู้ใช้เกี่ยวกับเวลาและการทำงาน
สิ่งที่ควรทำ: พิจารณาการหน่วงเวลาที่สร้างขึ้น 1-2 วินาทีหากการตอบสนองเกือบจะทันที ในทางกลับกัน ผู้ใช้อาจพบว่าผลลัพธ์น่าเชื่อถือมากขึ้นเมื่อรับรู้ถึงกระบวนการสร้างที่สอดคล้องกับความยากของงานที่ตนรับรู้ ใช้ภาพเคลื่อนไหวเพื่อส่งสัญญาณว่ามีการประมวลผลด้วย AI เกิดขึ้นแล้ว
สิ่งที่ไม่ควรทำ: ทำให้ผู้ใช้ประหลาดใจด้วยการแทนที่ UI ทันที
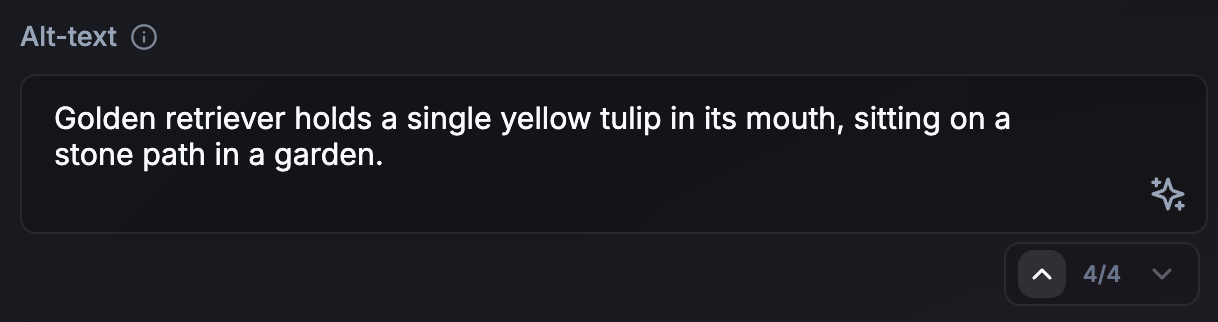
อนุญาตให้ผู้ใช้ไปยังส่วนต่างๆ และเลิกทำการแก้ไขด้วย AI ได้อย่างรวดเร็ว
สิ่งที่ควรทำ: ติดตั้ง Stepper หรือประวัติการนำทางใน UI เพื่อให้ผู้ใช้สำรวจผลลัพธ์ต่างๆ ได้อย่างมั่นใจ และให้ผู้ใช้เลิกทำการแก้ไขของ AI ได้อย่างรวดเร็ว ซึ่งจะช่วยให้มั่นใจได้ว่าเวอร์ชันต่างๆ จะยังคงพร้อมใช้งานอยู่เสมอ
ไม่ควรทำ: เขียนทับฉบับร่างก่อนหน้าของผู้ใช้หรือผลลัพธ์จาก AI ที่ผู้ใช้อาจชอบโดยไม่มีวิธีกลับไป เปลี่ยนกลับ หรือเปรียบเทียบเวอร์ชัน
เพิ่มประสิทธิภาพการควบคุมและการลบล้างของผู้ใช้
สิ่งที่ควรทำ: กำหนดให้ผู้ใช้เป็นผู้แก้ไขขั้นสุดท้ายของเนื้อหาทั้งหมดที่สร้างขึ้น ให้การลบล้างที่ใช้งานง่ายเพื่อให้ผู้ใช้ยังคงเป็นเจ้าของผลลัพธ์สุดท้ายอย่างเต็มรูปแบบ API อาจให้ผลลัพธ์ที่ไม่ถูกต้อง
ข้อควรหลีกเลี่ยง: บังคับให้ผลลัพธ์ที่ AI สร้างขึ้นเป็นตัวเลือกเดียว
แคชผลลัพธ์สำหรับงานที่ทำซ้ำ
สิ่งที่ควรทำ: ใช้แคชผลลัพธ์ในเครื่อง (เช่น ใช้ sessionStorage หรือ IndexedDB) สำหรับอินพุตหรือการค้นหาที่ซ้ำกัน ปรับอินพุตให้เป็นมาตรฐานโดยตัดช่องว่างและเปลี่ยนเป็นตัวพิมพ์เล็กเพื่อเพิ่มการพบแคช สำหรับอินพุตที่มีขนาดใหญ่ เช่น รูปภาพ ให้สร้างแฮชเพื่อใช้เป็นคีย์แคช ตั้งค่า Time to Live (TTL) ที่เหมาะสมสำหรับแคช (หรือแสดงผลลัพธ์ที่แคชไว้ขณะอัปเดตในเบื้องหลัง) อนุญาตให้ผู้ใช้เรียกใช้การอนุมานใหม่หากผลลัพธ์ไม่เป็นที่น่าพอใจ
สิ่งที่ไม่ควรทำ: เรียกใช้การอนุมานเดียวกันซ้ำสำหรับคำค้นหาที่ซ้ำกันหรืออินพุตข้อมูลที่เหมือนกันซึ่งไม่ต้องการความแปรปรวน เช่น เมื่อผู้ใช้ไปยังส่วนต่างๆ ไปมาในผลการค้นหา ซึ่งจะช่วยเพิ่มประสิทธิภาพการตอบสนองและการใช้การประมวลผลในเครื่องอย่างมีประสิทธิภาพ
// ✅ DO: Check a local cache before running inference
async function getAiResponse(userInput, forceRefresh = false) {
  // Normalize the query to increase cache hits
  const query = userInput.trim().toLowerCase();
  const cacheKey = `ai_results_${query}`;
  const TTL_MS = 3600000; // 1 hour conservative TTL

  if (!forceRefresh) {
    const itemStr = localStorage.getItem(cacheKey);
    if (itemStr) {
      const item = JSON.parse(itemStr);
      const now = Date.now();

      // Check if the item has expired
      if (now < item.expiry) {
        // Lightweight safety check before rendering
        if (isValid(item.value)) return item.value;
      } else {
        // Delete the stale entry if the TTL has passed
        localStorage.removeItem(cacheKey);
      }
    }
  }

  // Fallback: Run inference if no valid cache exists
  const session = await LanguageModel.create();
  const response = await session.prompt(userInput);

  // Store the result for future use (with an expiration)
  const cacheData = {
    value: response,
    expiry: Date.now() + TTL_MS
  };
  localStorage.setItem(cacheKey, JSON.stringify(cacheData));

  return response;
}